> ## Documentation Index
> Fetch the complete documentation index at: https://docs.apiyi.com/llms.txt
> Use this file to discover all available pages before exploring further.
# 内容安全拦截排查:用分词消融法找到触发词
> 一个真实案例:同一段提示词网页版能出图、API 报 safety_violations=[sexual]。讲清拦截发生在哪一层、为什么 moderation: low 无效、网页版为何能过,以及用分词消融法 20 次实测定位触发词并给出零改意的改法。
被内容安全拦下,**不等于提示词写了违规内容**。更常见的情况是:提示词里某一个词把「成图」推过了审核线,而你自己读提示词根本看不出问题。本文用一个真实客户案例,讲清拦截发生在哪一层、网页版为什么能过、`moderation: low` 为什么没用,以及一套 20 次调用就能定位触发词的方法。
## 案例复盘:网页版能出、API 报 sexual
客户用 `gpt-image-2.5-sunburst` 生成一张角色设定图(左侧脸部特写、右侧正面 / 侧面 / 背面三视图)。请求体:
```json theme={null}
{
"model": "gpt-image-2.5-sunburst-2026-09-08",
"prompt": "帮我生成一个妈感美艳女主(外国人),皮肤通透有自然光泽,无过度磨皮;皮肤保留自然原生纹理、皮肤通透有自然光泽;整体画面自然真实,8K超高清,细节丰富,真实人像摄影质感,纯白背景#一张综合角色设定图,左侧为脸部大特写,右侧为全身标准三视图,露出完整的头部,脸部特写和全身三视图要在一张图。全身三视图:右侧依次排列全身的正面视角、90 度纯侧面视角(头部完全侧转)、背面视角。",
"size": "2736x1536",
"quality": "xhigh",
"background": "auto",
"n": 1
}
```
API 稳定返回 400:
```json theme={null}
{
"status_code": 400,
"error": {
"message": "Your request was rejected by the safety system. If you believe this is an error, contact us at ***.***.com and include the request ID req_e97b3571a1e2433da4b154fe7ea7a82c. safety_violations=[sexual]."
}
}
```
客户的反馈很有代表性:
> 我理解是内容安全,但我在 ChatGPT 网页版又能成功,你得告诉我,为啥网页版能成。
提示词里没有任何露骨内容,只是「美艳女主 + 三视图 + 纯白背景」。这类「我没写什么却被拦」的工单,排查思路和「我写了什么被拦」完全不同。
## 先分清拦截发生在哪一层
出图模型的内容安全有两道关,触发的层不同,排查方法也不同:
| | 提示词层拦截 | 图像输出层拦截 |
| --------- | ------------- | ------------------------- |
| 审核对象 | 你发的文本 | 生成出来的那张图 |
| 响应耗时 | **几秒内**返回 400 | **与成功请求相同**(图先生成,再被分类器拦下) |
| 同一提示词多次调用 | 结果稳定:每次都拒 | **有随机性**:每次成图不同,时过时不过 |
| 改法 | 删掉明显违规词 | 找到把成图「推过线」的那个词 |
**判据就看耗时**。本案例失败请求耗时 42 到 51 秒,成功请求 46 到 57 秒,两者没有区别,说明图已经生成完了,是输出侧分类器判了 sexual。后面的消融实验也印证了这一点:同一句提示词跑 3 次,出现过 1 过 2 拒。
提示词层拦截和参数错误一样几乎秒回。如果你的 400 等了半分钟以上才来,先按「输出层拦截」来查,别急着删提示词里的词。
## 为什么网页版能成
这和 [如何生成满意的图片](/api-capabilities/image-generation-success-tips) 里讲的是同一件事:**网页版是 Agent,API 是单次原子调用**。
* ChatGPT 网页版不会把你这段话原样喂给出图模型。中间的对话模型会先**改写、扩充**提示词,通常会自己补上服装、场景、光线等细节。等于替你做了下文「加服装」那一步。
* API 是原文直达。你没写穿什么,模型就自由发挥;在「美艳 + 全身三视图 + 纯白背景」这个组合下,它倾向画成贴身或少衣的角色设定图,成图就容易越线。
* 再叠加输出层审核本身的随机性,网页版跑一次成功、API 跑一次失败并不矛盾。
所以「网页版能过」不能推出「API 审核更严」,两条链路送进模型的提示词根本不是同一段。
## 分词消融法:一次只动一个词
提示词里有十几个形容词和构图约束,靠猜哪个词有问题效率很低。有效的办法是**消融**:每次只删或替换一个词块,其余一字不动,看哪一次结果翻转。
分三类:人物形容词(美艳、性感、妩媚……)、身体相关动词(露出、展示、贴身……)、构图约束(全身、三视图、纯白背景……)。构图约束单独看没问题,但会和形容词组合出效果。
删掉或换成中性词,其余原样。同时也跑一组「不动词、只加约束」的变体,比如给人物加一句明确的服装描述。
输出层拦截有随机性,单次通过不算数。命中的变体至少再跑 2 次,全过才算找到。
目标不是「能过」,而是「改意最小地能过」。优先选不动原词、只加约束的方案。
变体之间互不依赖,**并行跑**。本案例 6 个变体一批发出,50 秒左右全部返回;串行等要五分钟。
本案例的完整消融记录(共 20 次调用,同尺寸同 quality):
| 改法 | 结果 |
| ------------------------------------ | --------------- |
| 原句(跑 2 次) | 400 sexual ×2 |
| 原句 + `moderation: "low"` | 400 sexual |
| 只把「露出完整的头部」改成「头部完整入画」 | 400 sexual |
| 只删「妈感」,保留「美艳」 | 400 sexual |
| 只删「美艳」,保留「妈感」 | 200 |
| 「妈感美艳女主」改成「成熟优雅的欧美女性角色」(跑 3 次) | 200 ×3 |
| 改成「成熟优雅、面容精致的欧美女性角色」(跑 3 次) | 400 / 200 / 400 |
| **原句一字不动,只加「身穿米色高领针织衫和深色长裤」(跑 3 次)** | **200 ×3** |
从表里能直接读出三件事:触发词是「美艳」(删「妈感」没用、删「美艳」就过);「露出」不是原因;「面容精致」那组 1 过 2 拒,证明审核对象是每次都不同的成图而不是文本。
## 结论与推荐改法
**触发机制**:「美艳」让模型把人物往性感方向渲染,「全身三视图 + 纯白背景」又是典型的设定图构图,两者叠加,成图容易被输出侧分类器判为 sexual。提示词本身没有一个字违规。
**推荐改法**:保留全部原文,只在人物描述后加一句明确的服装。实测 3/3 通过,人物气质和构图都和原意一致:
```text theme={null}
帮我生成一个妈感美艳女主(外国人),身穿米色高领针织衫和深色长裤,皮肤通透有自然光泽,无过度磨皮;皮肤保留自然原生纹理、皮肤通透有自然光泽;整体画面自然真实,8K超高清,细节丰富,真实人像摄影质感,纯白背景#一张综合角色设定图,左侧为脸部大特写,右侧为全身标准三视图,露出完整的头部,脸部特写和全身三视图要在一张图。全身三视图:右侧依次排列全身的正面视角、90 度纯侧面视角(头部完全侧转)、背面视角。
```
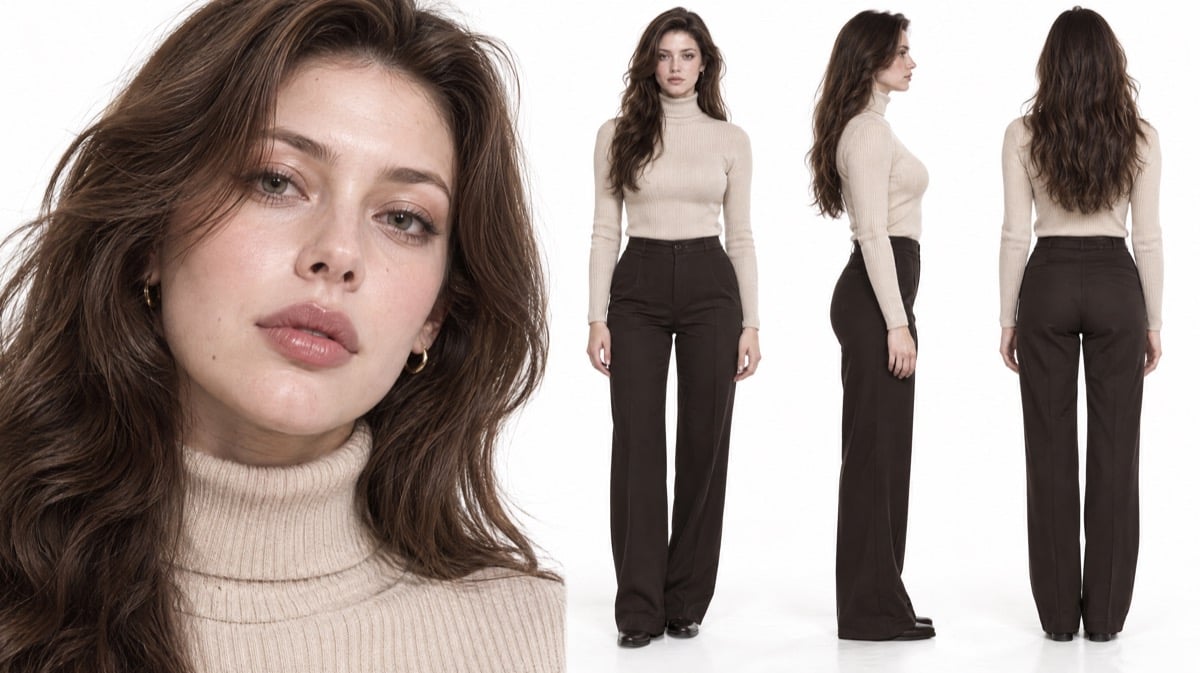 服装换成任何得体的日常装都可以,关键是**要写**,不要留给模型自己决定。
**备选改法**:把「美艳」换成「成熟优雅」,同样 3/3 通过,但脸部气质会偏温和,离原意远一些。
## moderation: low 为什么没用
`moderation` 参数(见 [文生图参数表](/api-capabilities/gpt-image-2/text-to-image))取值 `auto` / `low`,作用是降低**提示词侧**的审核强度。本案例传了 `low` 照样 400,因为拦截发生在输出层,这个参数管不到成图的 sexual 分类。
在网关之外无法区分「参数没透传」和「参数透传了但不生效」,但对结论没有影响:**遇到输出层拦截,改参数没用,得改提示词**。
## 通用排查清单
秒回是提示词层,等了和正常出图差不多的时间是输出层。前者删明显违规词;后者用分词消融法找「推过线」的那个词,并接受同一提示词会有随机性。
人物类提示词只写气质、不写服装,是输出层拦截最常见的来源。加一句明确的服装描述,往往一步就解决,而且不动原意。
同时改三个词,过了也不知道是哪个起作用,下次换个提示词又要从头猜。每次只动一个词块,命中后回归 2 到 3 次。
按 token 计费的 gpt-image 系列触发审核返回 400 时不计费,口径见 [gpt-image-2 常见问题](/api-capabilities/gpt-image-2/overview#常见问题)「生成失败会扣费吗」。所以消融实验本身不花钱,只花时间。
## 速查总结
* **看耗时判层级**:400 秒回是提示词层;等了和出图一样久才 400,是成图被输出层分类器拦下。
* **输出层拦截有随机性**:同一提示词时过时不过,单次结果不能下结论,要回归 2 到 3 次。
* **网页版能过不代表 API 更严**:网页版会先改写扩充提示词(补服装、场景),API 是原文直达。
* **分词消融法**:一次只动一个词块,并行跑变体,取改意最小的方案。本案例触发词是「美艳」。
* **人物提示词写清服装**:只加一句服装描述、其余不动,实测 3/3 通过;`moderation: low` 对输出层拦截无效。
## 相关文档
* [如何生成满意的图片](/api-capabilities/image-generation-success-tips)
* [出图提示词诊断技能](/api-capabilities/image-prompt-doctor)
* [图片 API 调用须知与最佳实践](/api-capabilities/image-api-best-practices)
* [gpt-image-2 常见问题](/api-capabilities/gpt-image-2/overview#常见问题)