> ## Documentation Index
> Fetch the complete documentation index at: https://docs.apiyi.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Устранение отклонений по соображениям безопасности: найдите триггерное слово методом абляции
> Реальный случай: один и тот же промпт успешно обрабатывается в веб-приложении ChatGPT, но API возвращает safety_violations=[sexual]. Узнайте, какой уровень блокирует запрос, почему moderation: low не помогает, почему веб-приложение пропускает запрос и как 20 вызовов методом абляции позволяют точно определить триггерное слово и устранить проблему, сохранив исходный замысел.
Блокировка системой безопасности **не означает, что ваш prompt содержит что-либо откровенное**. Гораздо чаще одно слово в prompt переводит *отрендеренное изображение* за допустимую границу, и при чтении prompt невозможно увидеть проблему. На этой странице разбирается реальный случай клиента: какой слой выполняет блокировку, почему веб-приложение пропускает запрос, почему `moderation: low` ничего не меняет и какой метод позволяет найти слово-триггер примерно за 20 вызовов.
## Случай: веб-приложение отображает, API возвращает ошибку о сексуальном содержании
Клиент использовал `gpt-image-2.5-sunburst` для генерации листа персонажа (крупный план лица слева, развороты спереди / сбоку / сзади справа). Запрос:
```json theme={null}
{
"model": "gpt-image-2.5-sunburst-2026-09-08",
"prompt": "帮我生成一个妈感美艳女主(外国人),皮肤通透有自然光泽,无过度磨皮;皮肤保留自然原生纹理、皮肤通透有自然光泽;整体画面自然真实,8K超高清,细节丰富,真实人像摄影质感,纯白背景#一张综合角色设定图,左侧为脸部大特写,右侧为全身标准三视图,露出完整的头部,脸部特写和全身三视图要在一张图。全身三视图:右侧依次排列全身的正面视角、90 度纯侧面视角(头部完全侧转)、背面视角。",
"size": "2736x1536",
"quality": "xhigh",
"background": "auto",
"n": 1
}
```
Промпт написан на китайском языке. Примерный перевод: *гламурная женщина западной внешности, выглядящая зрелой, естественная текстура кожи, фотореалистичное изображение, чистый белый фон; лист персонажа с крупным планом лица слева и разворотами в полный рост: спереди / сбоку под углом 90 градусов / сзади — справа, голова полностью видна.* API стабильно возвращал ошибку 400:
```json theme={null}
{
"status_code": 400,
"error": {
"message": "Your request was rejected by the safety system. If you believe this is an error, contact us at ***.***.com and include the request ID req_e97b3571a1e2433da4b154fe7ea7a82c. safety_violations=[sexual]."
}
}
```
Реакция клиента типична:
> Я понимаю, что дело в безопасности контента, но в веб-приложении ChatGPT тот же запрос работает. Объясните, почему веб-приложение его пропускает.
В промпте нет ничего откровенного. Это всего лишь «гламурная женщина + разворот + белый фон». Для обращения в формате «Я не написал ничего плохого, но запрос заблокировали» нужен совершенно иной подход, чем для обращения «Я написал что-то плохое, и запрос заблокировали».
## Сначала: какой уровень блокирует запрос?
У моделей изображений есть два защитных уровня. Они срабатывают по-разному, и диагностировать их нужно по-разному:
| | Блокировка на уровне промпта | Блокировка выходного изображения |
| ------------------------------------------- | --------------------------------------- | -------------------------------------------------------------------------------------------------------------------- |
| Что проверяется | Отправленный вами текст | Сгенерированное изображение |
| Время ответа | 400 примерно **через несколько секунд** | **Столько же, сколько при успешном вызове** (сначала изображение визуализируется, затем отклоняется классификатором) |
| Повторная отправка одного и того же промпта | Стабильно: отклоняется каждый раз | **Стохастически**: каждый рендер отличается, поэтому иногда проходит, а иногда отклоняется |
| Решение | Удалите явно нарушающее правило слово | Найдите слово, из-за которого *рендер* пересекает допустимую границу |
**Задержка — главный признак.** В этом случае неудачные вызовы занимали от 42 до 51 секунды, а успешные — от 46 до 57 секунд. Разницы нет, значит, изображение было полностью визуализировано, а классификатор на стороне результата пометил его как содержащее сексуальный контент. Приведённое ниже абляционное исследование это подтверждает: один промпт был выполнен трижды, и результат составил 1 успешный / 2 отклонённых.
Блокировка на уровне промпта возвращается примерно с той же скоростью, что и ошибка параметра. Если ответ 400 поступил через полминуты или больше, сначала рассматривайте это как блокировку выходного изображения и пока не начинайте удалять слова.
## Почему веб-приложение проходит проверку
Это та же мысль, что и в разделе [Как получать удовлетворительные изображения](/ru/api-capabilities/image-generation-success-tips): **веб-приложение — это агент, а API — один атомарный вызов**.
* Веб-приложение ChatGPT не передаёт ваш текст модели изображений дословно. Сначала чат-модель **переписывает и расширяет** prompt, обычно самостоятельно добавляя одежду, окружение и освещение. Именно это описанное ниже действие «добавить одежду» выполняется за вас.
* API отправляет ваш prompt как есть. Вы не указали, что на ней надето, поэтому модель решает сама. При условиях «гламурный образ + разворот в полный рост + белый фон» она склоняется к облегающему или минималистичному наряду — именно так часто выглядит лист персонажа, — и результат пересекает допустимую границу.
* Если вдобавок учесть случайную модерацию на стороне результата, ситуация «веб-приложение один раз прошло проверку, а API один раз не прошло» не является противоречием.
Таким образом, утверждение «веб-приложение проходит проверку» не означает, что «API применяет более строгую модерацию». Эти два пути отправляют модели разные prompt.
## Абляция слов: изменяйте по одному параметру за раз
Такой промпт содержит дюжину прилагательных и ограничений макета. Угадывать, какое из них стало причиной, медленно. Эффективный подход — **абляция**: удаляйте или заменяйте ровно один блок слов в каждом варианте, оставляя всё остальное идентичным на уровне байтов, и наблюдайте, какой вариант меняет результат.
Три категории: прилагательные, описывающие персонажа (гламурная, сексуальная, привлекательная...), глаголы, связанные с телом (раскрывать, показывать, облегающий...), и ограничения макета (в полный рост, разворот, белый фон...). Ограничения макета сами по себе выглядят безобидно, но в сочетании с прилагательными дают эффект.
Удалите его или замените нейтральным словом, не изменяя остальной текст. Также запустите вариант, в котором слова не изменяются, а добавляется только ограничение, например явно заданная одежда персонажа.
Блоки на стороне вывода являются стохастическими, поэтому одного запуска недостаточно для доказательства. Повторно запустите успешный вариант как минимум ещё два раза и засчитывайте его только в том случае, если он проходит при каждом запуске.
Цель не в том, чтобы «он прошёл», а в том, чтобы он прошёл с минимальным изменением замысла. Предпочтительны варианты, сохраняющие исходные слова и лишь добавляющие ограничение.
Варианты независимы, поэтому **запускайте их параллельно**. В этом случае пакет из шести вариантов вернулся примерно через 50 секунд; при последовательном запуске это заняло бы пять минут.
Полный журнал абляции для этого случая (20 вызовов, одинаковые размер и качество на всём протяжении):
| Вариант | Результат |
| -------------------------------------------------------------------------------------------------------- | --------------------------- |
| Исходный промпт (2 запуска) | 400: сексуальный контент ×2 |
| Исходный + `moderation: "low"` | 400: сексуальный контент |
| Только «раскрыть всю голову» → «голова полностью в кадре» | 400: сексуальный контент |
| Удалить только «выглядящая зрелой», сохранить «гламурная» | 400: сексуальный контент |
| Удалить только «гламурная», сохранить «выглядящая зрелой» | 200 |
| «гламурная женщина» → «зрелая, элегантная западная женщина» (3 запуска) | 200 ×3 |
| → «зрелая, элегантная западная женщина с утончёнными чертами» (3 запуска) | 400 / 200 / 400 |
| **Исходный промпт без изменений плюс «в бежевом свитере с высоким воротом и тёмных брюках» (3 запуска)** | **200 ×3** |
Из таблицы напрямую следуют три вывода: триггером является «гламурная» (удаление «выглядящая зрелой» ничего не меняет, а удаление «гламурная» позволяет пройти проверку); причиной является не «раскрыть»; а строка с «утончёнными чертами» при 1 успешном запуске и 2 отклонённых показывает, что классификатор каждый раз оценивает другое изображение, а не текст.
## Вывод и рекомендуемое исправление
**Механизм**: слово «гламурный» склоняет модель к чувственной визуализации, а «поворотный лист персонажа в полный рост + белый фон» — это классическая компоновка листа персонажа. Вместе они создают изображения, которые классификатор на стороне вывода помечает как сексуальные. Ни одно слово в промпте само по себе не является нарушением.
**Рекомендуемое исправление**: сохраните весь исходный промпт и добавьте одну явную фразу об одежде сразу после описания персонажа. Этот вариант успешно прошёл 3 из 3 запусков и сохранил как внешний вид, так и компоновку, которые требовались заказчику:
```text theme={null}
帮我生成一个妈感美艳女主(外国人),身穿米色高领针织衫和深色长裤,皮肤通透有自然光泽,无过度磨皮;皮肤保留自然原生纹理、皮肤通透有自然光泽;整体画面自然真实,8K超高清,细节丰富,真实人像摄影质感,纯白背景#一张综合角色设定图,左侧为脸部大特写,右侧为全身标准三视图,露出完整的头部,脸部特写和全身三视图要在一张图。全身三视图:右侧依次排列全身的正面视角、90 度纯侧面视角(头部完全侧转)、背面视角。
```
Вставленная фраза: «в бежевом свитере с высоким воротом и тёмных брюках».
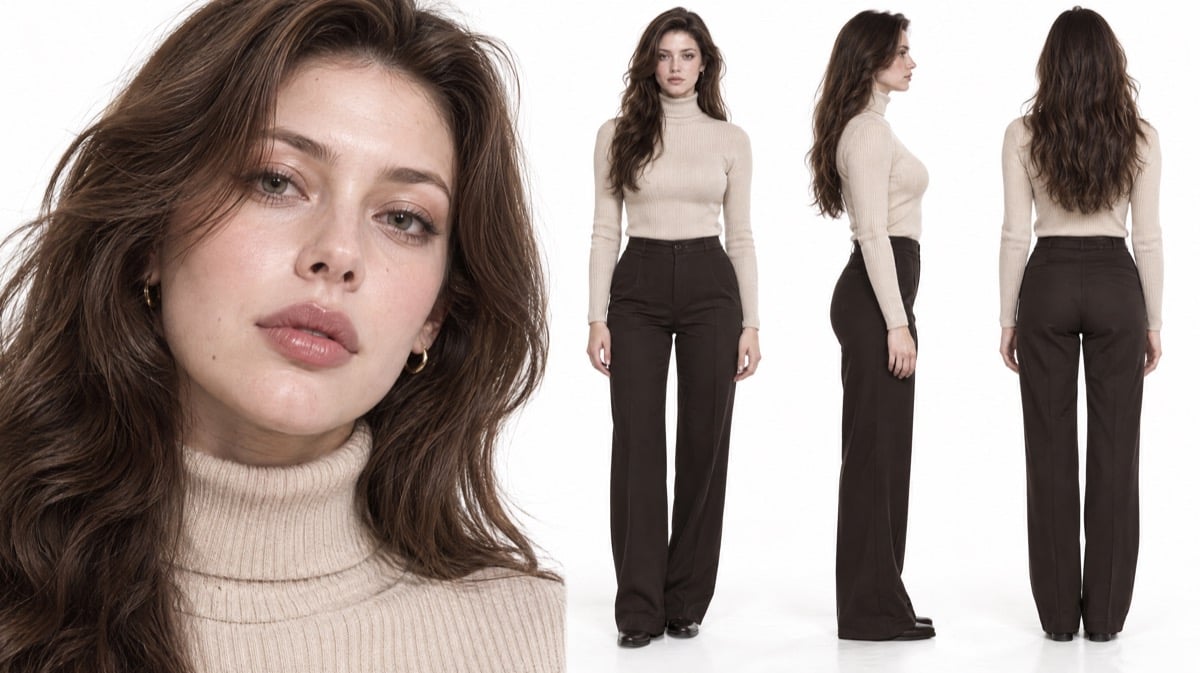 Подойдёт любой скромный повседневный наряд. Важно, чтобы **вы указали его**, а не оставляли это на усмотрение модели.
**Альтернативное исправление**: замените слово «гламурный» на «зрелый и элегантный». Этот вариант также успешно прошёл 3 из 3 запусков, но лицо выглядит мягче и сильнее отклоняется от исходного замысла.
## Почему moderation: low не помог
Параметр `moderation` (см. [таблицу параметров text-to-image](/ru/api-capabilities/gpt-image-2/text-to-image)) принимает значения `auto` / `low` и снижает строгость модерации **со стороны промпта**. Передача `low` здесь всё равно вернула ошибку 400, поскольку блокировка происходит на стороне выходных данных, которой этот параметр не управляет.
За пределами шлюза мы не можем определить, «параметр не был передан» или «параметр был передан, но не возымел эффекта», однако вывод в обоих случаях один и тот же: **при блокировке на стороне выходных данных изменение параметров ничего не даёт; измените промпт**.
## Общий чек-лист
Мгновенная ошибка означает проблему на уровне промпта; ожидание, сопоставимое с обычным рендерингом, — проблему на уровне вывода. В первом случае удалите явно нарушающее правила слово. Во втором выполните абляцию слов, чтобы найти, какое слово переводит рендеринг за допустимую границу, и учитывайте некоторую случайность при использовании того же промпта.
Промпты для персонажей, в которых описано настроение, но не одежда, чаще всего становятся причиной блокировок на этапе вывода. Обычно достаточно одной явной фразы об одежде, чтобы устранить проблему за один шаг, не затрагивая исходный замысел.
Если изменить сразу три слова, вы не поймёте, какое из них имело значение, и следующий промпт придётся начинать с нуля. Выполняйте по одной блокировке для каждого варианта, затем повторно запустите любой успешный вариант 2–3 раза.
С моделей gpt-image с тарификацией по token плата не взимается, если модерация возвращает ошибку 400. См. раздел [часто задаваемых вопросов о gpt-image-2](/ru/api-capabilities/gpt-image-2/overview#faq) о неудачных генерациях. Поэтому абляция требует времени, но не денег.
## Краткая справка
* **Используйте задержку, чтобы определить уровень сбоя**: мгновенная ошибка 400 указывает на уровень промпта; ошибка 400, получение которой заняло столько же времени, сколько и рендеринг, означает, что классификатор на стороне результата отклонил изображение.
* **Блокировки на стороне результата носят стохастический характер**: один и тот же промпт иногда проходит, а иногда завершается ошибкой, поэтому единичный результат ничего не доказывает. Повторите запрос 2–3 раза.
* **Успешное выполнение в веб-приложении не означает, что API строже**: веб-приложение переписывает и расширяет промпт (добавляя одежду и обстановку), тогда как API отправляет его без изменений.
* **Поочерёдное исключение слов**: изменяйте по одному блоку в каждом варианте, запускайте варианты параллельно и сохраняйте правку с наименьшим изменением смысла. В данном случае триггером было слово «гламурный».
* **Явно указывайте одежду в промптах персонажей**: одна добавленная фраза об одежде при полном сохранении остальных частей прошла в 3 случаях из 3; `moderation: low` не влияет на блокировки на стороне результата.
## Связанная документация
* [Как получать качественные изображения](/ru/api-capabilities/image-generation-success-tips)
* [Навык Image Prompt Doctor](/ru/api-capabilities/image-prompt-doctor)
* [Основы Image API и лучшие практики](/ru/api-capabilities/image-api-best-practices)
* [FAQ по gpt-image-2](/ru/api-capabilities/gpt-image-2/overview#faq)