

freepik.com 및 higgsfield.ai과 같은 소비자용 이미지 제품은 여러분이 사용하는 것과 동일한 기반 모델, 즉 동일한 Nano Banana, GPT-Image 및 FLUX 제품군을 기반으로 실행되는데도 결과물이 더 완성도 높아 보입니다. 그 차이는 모델 가중치에 있는 것이 아닙니다. 모델을 감싸는 레이어에 있으며, 이 레이어를 직접 구축할 수 있습니다. 이 페이지에서는 그 방법을 설명합니다.
1. 모델을 둘러싼 소비자용 이미지 제품은 무엇인가
이러한 제품 중 하나를 분해해 보면 모델 외부에 대략 8개의 계층이 있습니다. 이 모든 계층은 API에서 재현할 수 있습니다.2. 첫 번째 레이어가 이미 결과를 분리합니다: 일상적인 입력을 구조로 전환하기
이는 가장 큰 효과를 내는 레이어이자, 가장 자주 생략되는 레이어입니다.나란히 비교하는 테스트: 하나의 모델, 하나의 브리프, 두 개의 프롬프트
브리프는 “커피를 위한 이커머스 제품 사진”입니다. 왼쪽은 사용자가 실제로 입력하는 내용이고, 오른쪽은 누락된 결정을 채운 동일한 브리프입니다. 두 이미지 모두gemini-3-pro-image (Nano Banana Pro)에서 2K, 1:1 조건으로 한 번씩 실행했습니다.
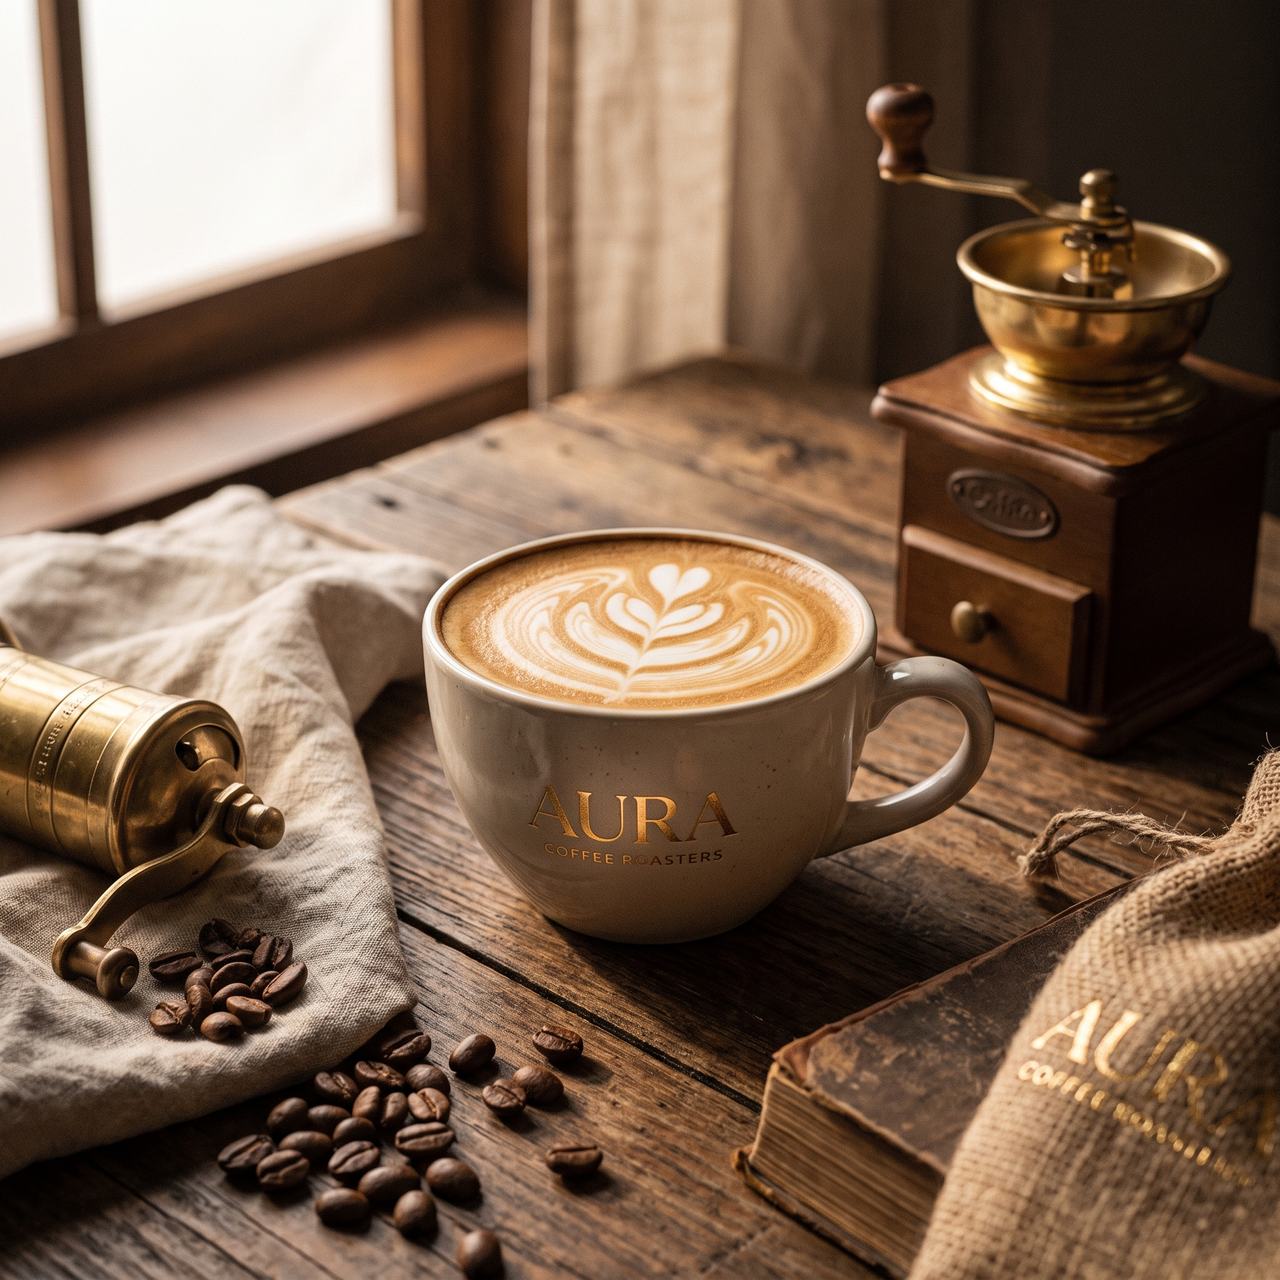
Casual prompt: 'Make me a coffee product shot, make it look nice, make it feel premium'
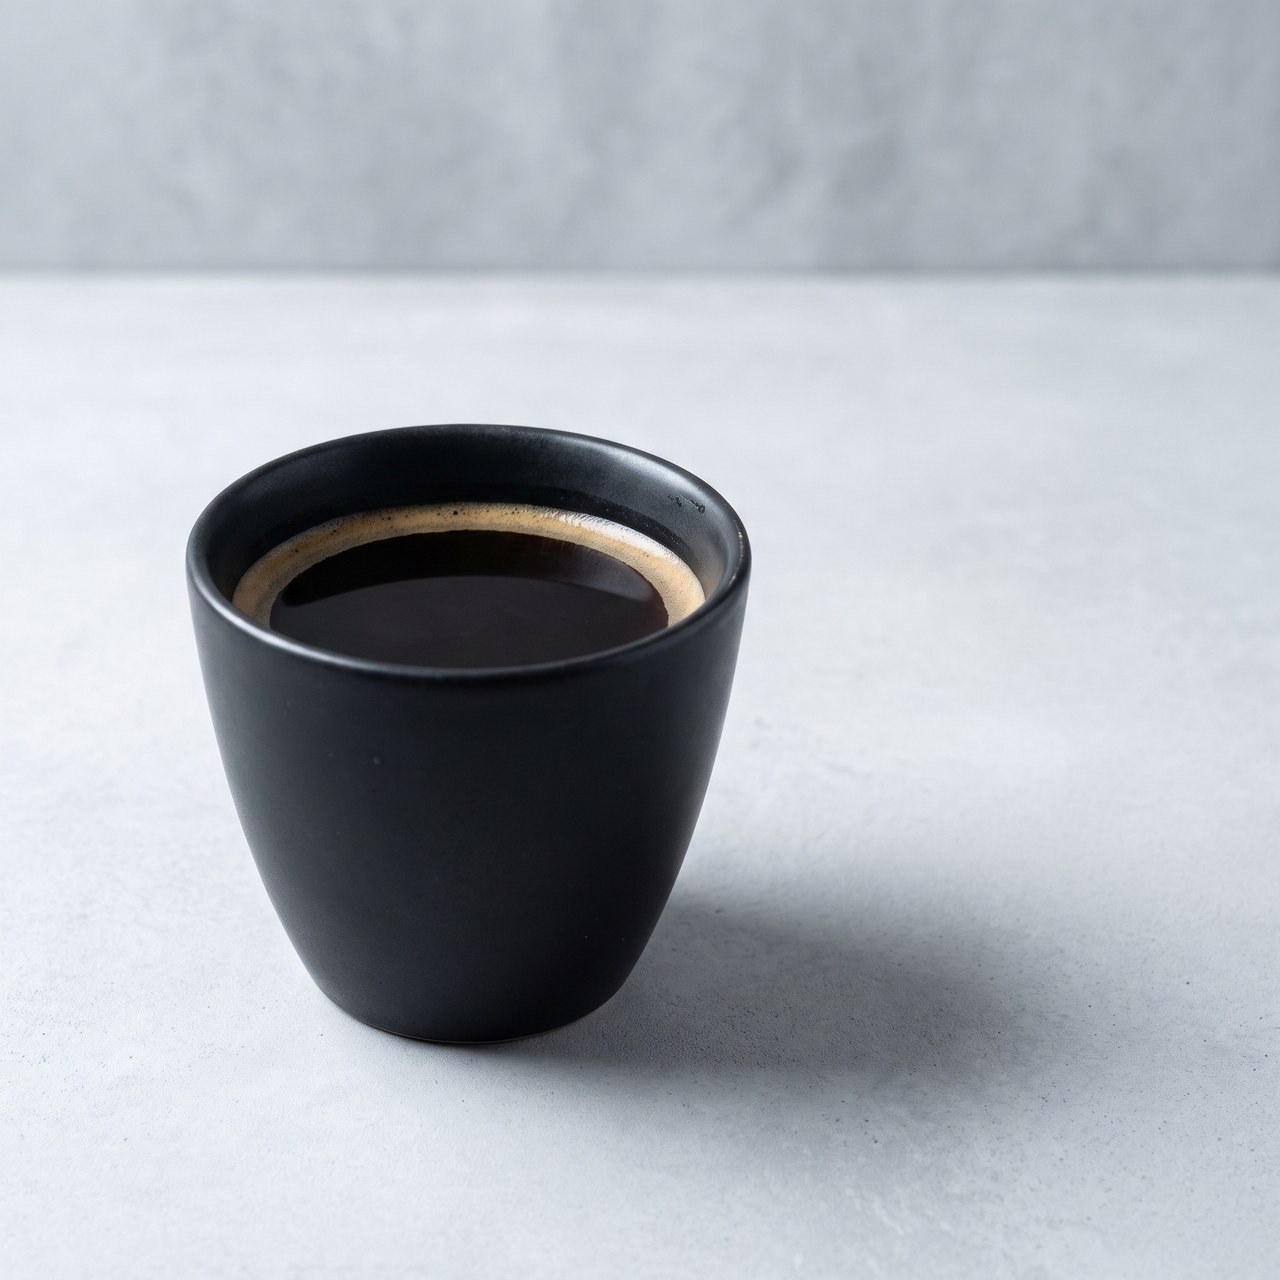
Structured prompt: subject, environment, light position, lens, grading, imperfections and composition all specified
재작성 레이어가 제공해야 하는 여섯 가지 요소
재작성은 프롬프트를 더 길게 만든다는 의미가 아닙니다. 누락된 결정을 채운다는 의미입니다. 이미지 프롬프트에는 핵심적인 여섯 가지 부분이 있습니다.코드에서의 재작성 레이어
여기에는 저렴하고 빠른 텍스트 모델이면 충분합니다. 생성 비용과 비교하면 그 비용은 무시할 수 있는 수준입니다.3. 실제로 배포할 수 있는 파이프라인
나머지 네 개 레이어를 리라이트 레이어에 연결하면 전체 구성이 완성됩니다.1
리라이트: 일상적인 입력을 구조화된 prompt로 변환
섹션 2를 참조하십시오. 이 단계에서는 사용자의 입력에 포함된 민감한 콘텐츠도 처리 과정에서 중화하므로, 이후 단계에서 요청이 차단되는 빈도를 측정 가능할 정도로 줄일 수 있습니다.
2
앵커: 참조 이미지와 스타일 상수
스타일은 두 가지 요소로 고정됩니다. 모든 prompt에 추가하는 스타일 상수(프리셋)와 고정된 참조 이미지 세트입니다.참조 제한은 모델 제품군별로 크게 다르므로 파이프라인을 설계하기 전에 사용 중인 제한을 확인하십시오.
다음 두 가지 규칙을 준수하십시오. prompt의 “이미지 1 / 이미지 2”는 배열 순서에 엄격히 대응하므로 어느 이미지가 무엇인지 명시해야 합니다. 또한 Grok은
/v1/images/edits에서만 참조 이미지를 적용합니다. /v1/images/generations에 참조 이미지를 전달하면 조용히 폐기되면서도 과금은 계속됩니다.3
샘플: N개를 병렬로 생성하고 n에 의존하지 마십시오
소비자 제품에서 느껴지는 “첫 시도부터 정확히 맞힌” 느낌은 실제로 제품이 사용자를 대신해 여러 장의 카드를 뽑는 것입니다.그러나 서버 측
n 매개변수는 대부분의 이미지 모델에 영향을 주지 않습니다(Seedream은 이를 완전히 무시합니다). 여러 후보를 얻으려면 클라이언트에서 여러 요청을 동시에 전송하십시오. 이 사이트의 스킬 페이지에서는 한 번에 최대 5개로 제한합니다. 채널별로 동시 실행 수를 조정하십시오. 일부 채널은 2개부터 429를 반환하기 시작하므로 지수 백오프를 추가하십시오.4
선택: 비전 모델을 심사자로 사용
N개의 후보를 확보했다면 자동으로 하나를 선택해야 합니다. 그렇지 않으면 선택 작업을 단순히 사용자에게 넘긴 것에 불과합니다.후보를 표준
/v1/chat/completions 이미지 입력으로 비전 모델에 다시 보내 점수를 매기십시오. 사용 가능한 모델은 비전 이해를 참조하십시오. 평가 기준은 다섯 가지 차원으로 고정하고 JSON을 반환하도록 요구하십시오. 즉, 지시 준수, 구조와 해부학, 텍스트 정확성, 텍스처의 사실성, 구도입니다.5
수정하고 마무리하십시오
구도가 결정된 후 국소적으로 조정하십시오. 하나의 복합 지시를 사용하는 것보다 성공률이 훨씬 높습니다.
- 픽셀 수준의 국소 재도색: 마스크를 지원하는 것은 **공식 릴레이
gpt-image-2**뿐입니다. 마스크 인페인팅 가이드를 참조하십시오. - 다중 턴 누적 편집: Nano Banana 모델의 네이티브 Gemini 엔드포인트에서 지원됩니다(이전 이미지를
role: "model"으로 다시 전달). 리버스 엔지니어링된 경로에서는 지원되지 않습니다. - 즉시 다시 호스팅: 반환되는 모든 URL은 임시 URL입니다(FLUX는 약 10분이며 CORS를 지원하지 않고, Seedream과 R2는 약 24시간). 따라서 이미지를 확보하는 즉시 자체 객체 스토리지로 다운로드하십시오.
최소 엔드투엔드 구현
4. AI 느낌 없애기
“AI 느낌”은 미스터리가 아닙니다. 이는 하나씩 제거할 수 있는 구체적인 특징들의 집합입니다.나란히 비교
동일한 모델(gemini-3-pro-image), 동일한 주제, 두 가지 프롬프트 스타일, 각각 두 장의 이미지이며 각 배치에서 첫 번째 이미지를 표시합니다:
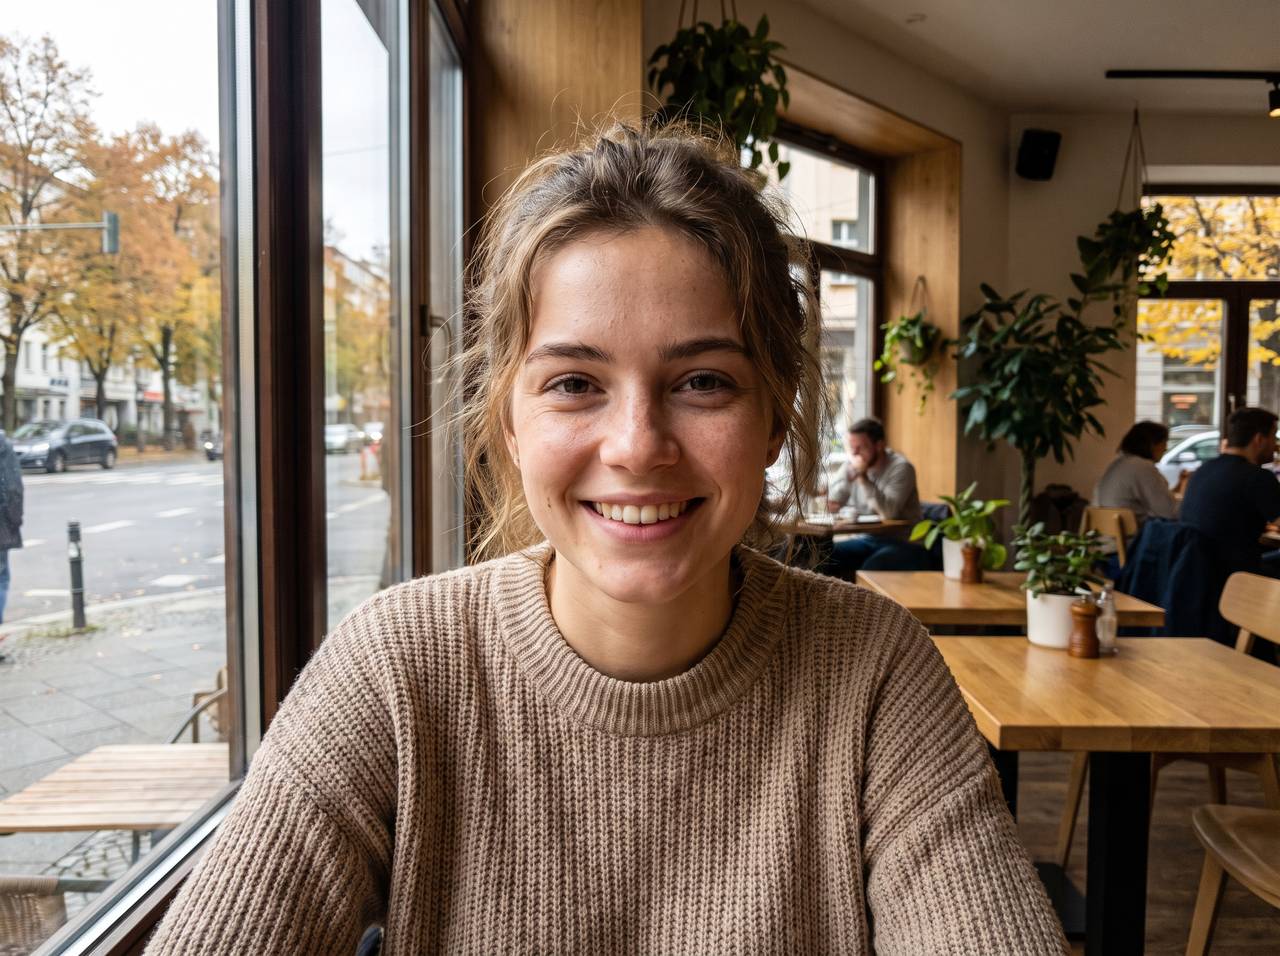
Bare prompt: 'A photorealistic half-body portrait of a young woman by a cafe window, smiling at the camera, 8K, ultra HD, ultra detailed, flawless skin, beautiful, perfect lighting, masterpiece'
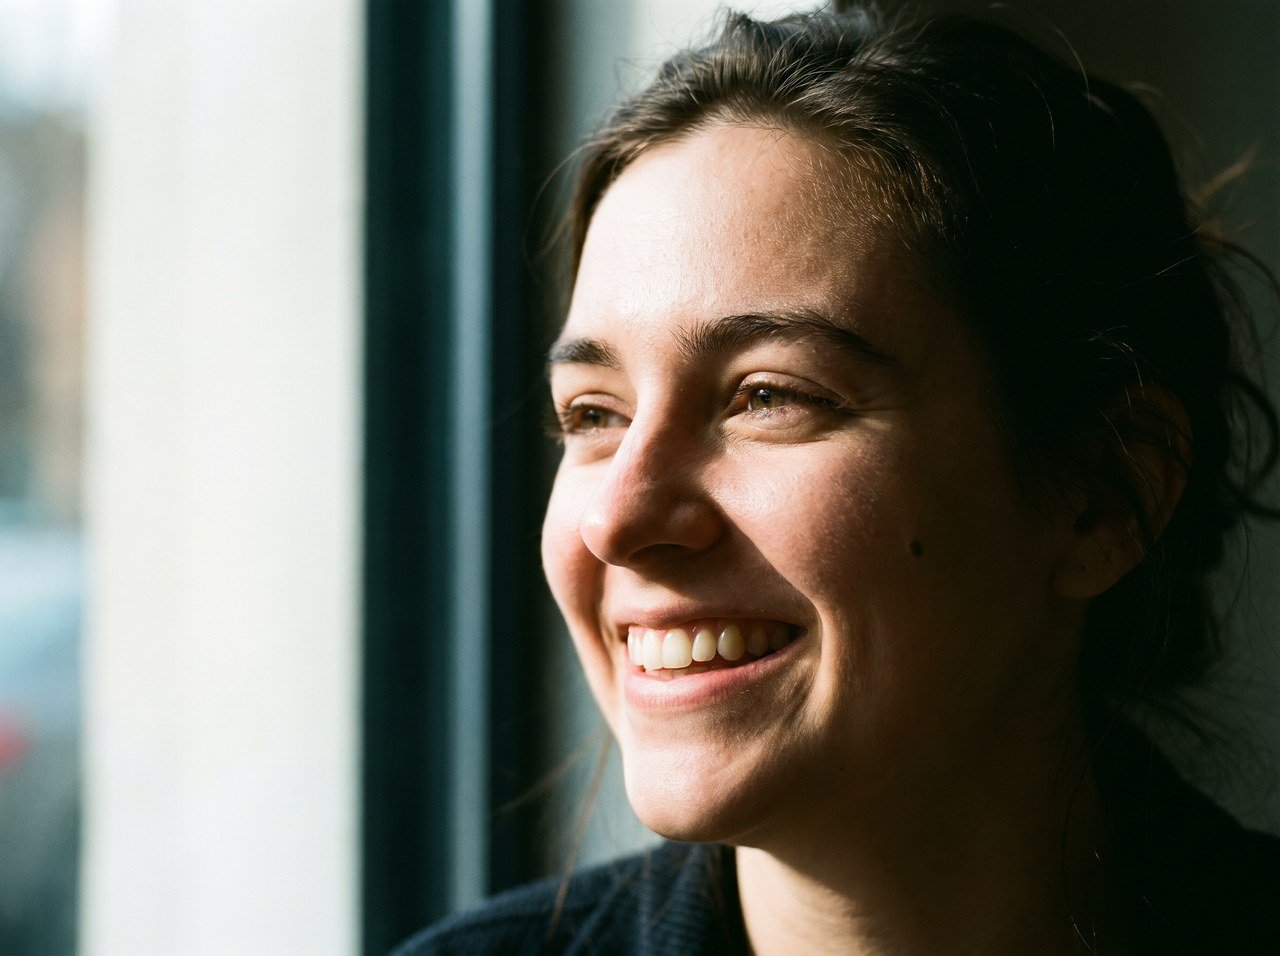
The same subject after adding four blocks of control language: light position, lens, medium, imperfections
파이프라인의 진정한 가치가 드러나는 지점도 바로 여기입니다. 파이프라인은 못생긴 결과물을 예쁜 결과물로 바꾸는 것이 아니라, “운 좋게 나온 좋은 결과”를 “지정하고, 설명하고, 재현할 수 있는 좋은 결과”로 바꿉니다. 이해관계자가 오른쪽 이미지를 더 선호하지 않을 수도 있지만, 왼쪽 이미지로는 왜 그런 모습으로 보이는지 설명할 수 없고, 다음 이미지에 같은 결과를 요청할 수도 없습니다.
AI 느낌의 증상, 해결 방법 및 작성하지 말아야 할 내용
복사해 붙여 넣을 수 있는 제어 문구 네 가지 블록
필요에 따라 prompt에 섞어 사용합니다. 각 블록에서 한두 줄이면 대개 충분합니다.조명
프레임 안에서 왼쪽의 창문 빛만 광원으로 사용 / 오후 3시의 강한 후면 측면광 / 머리카락에 림 라이트가 있는 역광 / 프레임 안에 실용적인 조명으로 배치된 책상 램프 / 뚜렷한 그림자가 없는 흐린 날의 확산광
렌즈
35mm f/2.0, 자연스러운 순간 포착, 눈높이 / 85mm f/2.8, 가까운 쪽 눈에 초점 / 낮은 카메라 위치에서 24mm, 가장자리에 약간의 왜곡 / 공간을 압축하는 망원 렌즈, 평평해진 배경 레이어 / 모서리에 약한 비네팅
매체
Kodak Portra 400 특유의 표현, 미세한 그레인 / 따뜻한 하이라이트, 차가운 그림자 / Polaroid 즉석 필름, 낮은 대비, 부드러운 가장자리 / 초기 CCD 디지털 카메라의 노이즈와 색조 편향 / 전체적으로 낮은 채도, 선명하게 처리하지 않음
불완전함
자연스러운 피부 질감, 보이는 모공과 솜털 / 몇 가닥의 헝클어진 머리카락, 빗지 않은 상태 / 보풀이 일어난 스웨터, 해진 소매 끝 / 테이블 위의 물자국, 지문과 부스러기 / 중심에서 벗어난 구도, 가장자리에서 피사체 일부가 잘린 상태
완전한 예시 3가지
인물 사진: 자연스러운 모습, 증명사진 아님
인물 사진: 자연스러운 모습, 증명사진 아님
자연스러운 반신 인물 사진: 카페 창가에 있는 20대 중반의 여성, 옆으로 돌아선 채 창밖을 바라보며, 애써 참으려는 듯한 미소를 짓고 있습니다. 프레임의 유일한 광원은 왼쪽에서 들어오는 창빛입니다. 얼굴 오른쪽 절반은 그림자에 잠기고, 콧등 아래에는 가장자리가 선명한 작은 그림자가 드리워집니다. 85mm 렌즈, f/2.8, 눈높이, 가까운 쪽 눈에 초점을 맞춥니다. 미세하게 눈에 보이는 입자를 지닌 Kodak Portra 400 특유의 질감, 따뜻한 하이라이트와 차가운 그림자, 전체적으로 낮은 채도입니다. 자연스러운 피부: 보이는 모공과 솜털, 콧방울 옆의 약간의 번들거림, 왼쪽 볼의 작은 점, 몇 가닥 삐져나온 눈썹, 이마에 빗질하지 않은 느슨한 머리카락. 피부 보정 금지, 뷰티 리터칭 금지, 선명화 금지입니다. 피사체는 중앙에서 오른쪽에 배치하고, 왼쪽에 여백을 둡니다.
제품 사진: 제품 페이지에 바로 사용할 수 있는 이미지
제품 사진: 제품 페이지에 바로 사용할 수 있는 이미지
이커머스 히어로 샷: 검은 커피가 80% 채워진 무광 검은색 세라믹 푸어오버 컵, 표면에는 크레마가 가느다란 고리 형태로 남아 있습니다. 밝은 회색 마이크로시멘트 표면 위에 놓여 있으며, 뒤쪽 벽도 같은 색조로 흐릿하게 보입니다. 주요 광원은 왼쪽 위 45도 위치의 소프트박스입니다. 오른쪽의 흰색 바운스 카드는 컵 오른쪽 가장자리를 따라 좁은 하이라이트를 만들고, 부드러운 투사 그림자는 뒤쪽 오른쪽으로 드리워집니다. 85mm 매크로 렌즈, f/5.6, 15도 아래로 기울인 정면 시점, 컵 전체에 선명한 초점을 맞춥니다. 차갑고 중립적인 화이트 밸런스, 전체적으로 낮은 채도입니다. 유약에는 수작업으로 제작한 듯한 약간의 불균일함과 아주 작은 가마 자국 하나가 있으며, 테두리에는 사용 흔적이 아주 희미하게 남아 있습니다. 넉넉한 여백을 두고, 컵은 프레임의 왼쪽 3분할 지점에 배치합니다. 이미지 어디에도 브랜드명이나 텍스트를 넣지 않습니다.
환경: 구체적인 시간과 날씨를 지정합니다
환경: 구체적인 시간과 날씨를 지정합니다
저녁 6시, 비가 막 그친 직후의 좁은 구시가지 거리입니다. 양쪽 상점의 라이트 박스가 물웅덩이에 반사됩니다. 유일한 주요 광원은 거리 끝의 따뜻한 가로등이며, 상점 창문이 보조광 역할을 하고, 하늘에는 차가운 해 질 녘의 기운이 희미하게 남아 있어 따뜻한 색과 차가운 색의 대비를 만듭니다. 28mm 렌즈, f/4, 카메라는 눈높이에 두고 약간 위쪽으로 기울입니다. 전체적으로 낮은 채도, 그림자에 남겨 둔 노이즈, 그림자 밝기 상승 금지입니다. 벽에는 물 얼룩, 찢어진 오래된 포스터와 에어컨 실외기가 보이고, 프레임 위쪽을 전선이 가로지릅니다. 누구도 카메라를 바라보지 않으며, 지나가는 사람들은 뒤에서 보이고 약간의 모션 블러가 적용됩니다.
5. 파이프라인 설계를 재구성할 사실
이러한 사항을 미리 파악하면 재작업을 줄일 수 있습니다.6. 비용 계산: 파이프라인이 가치가 있는 경우
파이프라인은 성공률을 높이는 대신 비용을 지불하는 방식입니다. 이미지 비용은 출력이 대부분을 차지하며(gpt-image-2은 출력에 토큰 100만 개당 $30를 청구합니다), 재작성과 점수 산정에 사용되는 텍스트 및 비전 모델 비용은 무시할 수 있을 정도로 낮습니다. 따라서 비용은 사실상 “몇 개의 후보를 생성했는가”에 달려 있습니다.
모든 작업에 하나의 설정을 적용하기보다는 다음 세 가지 계층을 사용합니다.
테스트는 간단합니다. 팀 외부의 누군가가 이 이미지를 보게 됩니까? 그렇다면 표준 이상을 사용하는 것이 비용 대비 효과가 있습니다. 내부에서 잠깐 확인하는 용도라면 초안으로 충분합니다. 중간에 게이트를 추가할 수도 있습니다. 상위 점수가 임계값보다 낮을 때만 후보를 추가로 생성하면 되므로, 대부분의 요청을 후보 2개에서 수렴시킬 수 있습니다.
빠른 요약
- 차이는 모델 가중치에 있는 것이 아니라 모델을 둘러싼 8개 계층에 있습니다. 즉, 재작성, 프리셋, 앵커링, 샘플링, 선택, 단계별 편집, 후처리, 재호스팅입니다.
- 재작성 계층의 투자 대비 효과가 가장 큽니다. 주제, 환경, 조명, 렌즈, 색보정, 구도를 채워 넣으면 “멋져 보인다”가 “사용할 수 있다”로 바뀝니다.
- 여러 후보와 비전 모델 점수화가 실제로 소비자 제품의 높은 체감 성공률을 만들어 내는 부분입니다.
n는 작동하지 않으므로 클라이언트 측에서 분산 호출해야 하며,/v1/rerank는 이미지에 점수를 매길 수 없습니다. - AI 느낌을 없애려면 형용사가 아니라 구체성을 더해야 합니다. 광원 하나를 명시하고, 초점 거리와 조리개를 제시하며, 매체와 그레인을 지정하고, 의도적으로 불완전함을 추가하고, 피사체를 중앙에서 벗어나게 배치해야 합니다.
8K/masterpiece/perfect lighting는 순효과가 마이너스입니다 — 해상도가 추가되지 않으며, 프레임을 렌더링된 느낌으로 몰고 갑니다.- 재현을 위해 시드에 의존하지 마십시오. 대신 전체 요청을 보관해야 합니다. 이미지 API는 동기식이며 연결이 끊겨도 과금되므로 파이프라인에 큐가 필요합니다.
- APIYI에는 업스케일링, 배경 제거 또는 ID 학습 엔드포인트가 없으므로 처음부터 이러한 계층을 고려해 설계해야 합니다.
관련 문서
원하는 이미지 얻는 방법
단일 실패 호출 복구: prompt 재작성, 재시도, 모델 전환, 테스트 도구로 격리
이미지 API 핵심 사항
동기 호출, 타임아웃 단계, 과금, base64 처리, 입력 이미지 전처리
마스크 인페인팅 가이드
픽셀 수준의 로컬 편집, 공식 릴레이 gpt-image-2 전용
다중 이미지 융합 테스트
참조 제한 측정 방법과 14개 이미지 융합 결과
비전 이해
후보 이미지의 점수를 매기는 데 사용할 수 있는 비전 모델과 호출 방법
사용자 지정 비동기 큐 구축
다중 후보 파이프라인을 지원하도록 동기 생성을 작업 큐로 래핑