

사례 연구: 색상을 잘못 맞춘 편집
작업 내용: 장난감 차 세트의 제품 시트로, 왼쪽 아래의 두 “Cups” 중 하나는 회색이고 하나는 초록색이며, 빨간 상자로 표시되어 있습니다. 프롬프트:빨간 상자 안의 항목을 검은색으로 바꾸고, 빨간 상자를 제거하며, 나머지는 모두 그대로 유지하십시오
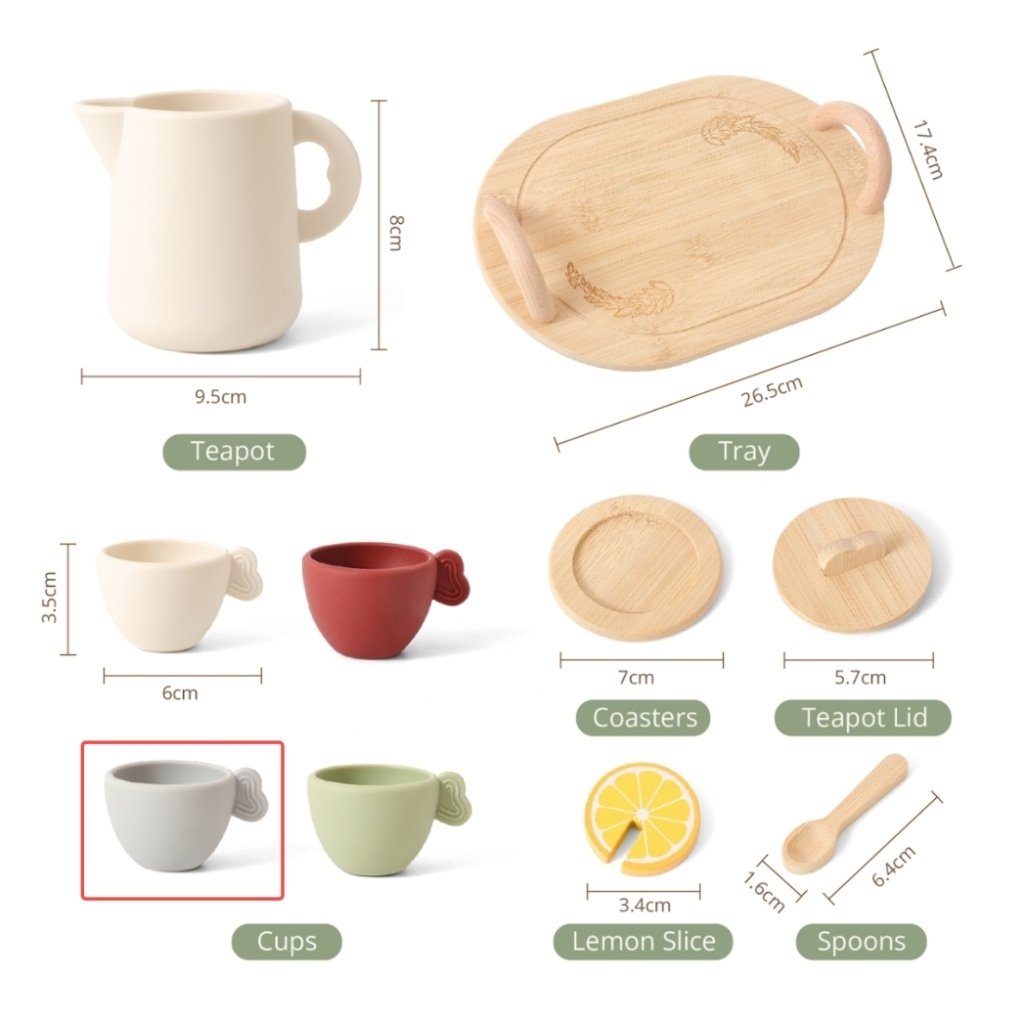
Input image: a red box marks the two cups (one gray, one green) in the lower left; the request is to make them black and remove the box
gemini-3.1-flash-image (Nano Banana 2)를 API를 통해 호출했고, 다음 결과를 받았습니다:
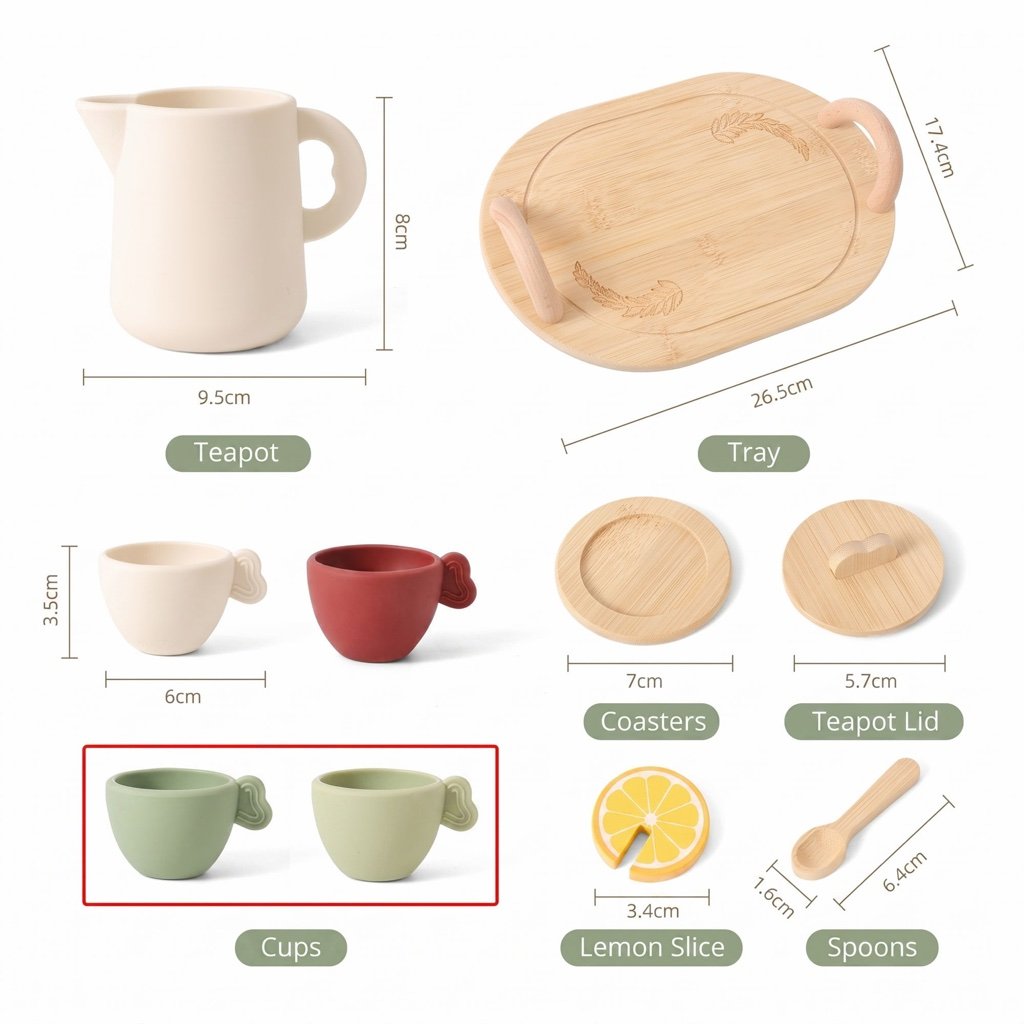
Failed result from a single API call: both cups turned green, and the red box was not removed
gemini.google.com)에서 실행했는데 잘 작동했습니다. 고객의 피드백은 다음과 같습니다:
API 출력이 공식(웹) 출력과 완전히 다릅니다 — 마치 API가 그만큼 잘 이해하지 못하는 것처럼 느껴집니다.불만은 충분히 이해되지만, 원인 설명은 바로잡아야 합니다. 이를 하나씩 살펴보겠습니다.
먼저 이해하셔야 합니다: 웹 앱은 에이전트이고, API는 단일 원자적 호출입니다
gemini.google.com 결과를 원시 API 호출과 직접 비교하는 것은 같은 기준의 비교가 아닙니다:
같은 모델, 두 가지 제품 형태입니다. 웹 앱은 여러분의 일상적인 지시를 모델이 더 안정적으로 실행하는 형태로 다듬어 줍니다. 반면 API에서는 그 다듬는 작업이 여러분의 몫입니다(그리고 바로 그것이 API의 정확한 가치입니다: 모든 것이 제어 가능하고, 재현 가능하며, 통합 가능합니다).
따라서 “웹 앱이 더 잘 작동한다”는 것은 대부분 파이프라인 차이에서 비롯된 것이며, “API가 덜 이해한다”는 결론을 뒷받침하지는 않습니다. API는 가공되지 않은 원시 prompt를 그대로 받기 때문에, 결과는 자연스럽게 prompt 자체의 품질에 더 크게 좌우됩니다.
단일 호출 편차는 생성형 모델의 본질적 특성입니다
우리는 imagen.apiyi.com 테스트 도구에서 완전히 동일한 prompt + 이미지로 작업을 다시 시도했습니다: 첫 시도에 성공했습니다 — 컵은 검은색으로 바뀌고, 빨간 상자는 제거되었으며, 나머지는 모두 그대로였습니다.명확히 말씀드리면, imagen.apiyi.com과 raw API 호출의 유일한 차이는 내장된 “이미지를 생성” 의도 prompt입니다. 이는 모델이 이미지 출력을 확정하도록 돕지만, 이 사례의 정교한 편집이 성공하느냐와는 아무 관련이 없습니다 — 도구가 “비법”을 더했기 때문에 성공한 것은 아닙니다.
전략 1: 프롬프트 개선하기
프롬프트가 덜 모호하고 더 실행 가능할수록 단일 호출 성공률은 높아집니다. 이 사례를 예로 들면: 원본 프롬프트 (캐주얼하고, 모델이 추론하길 기대함):빨간 상자 안의 항목을 검정색으로 바꾸고, 빨간 상자를 제거하고, 나머지는 모두 그대로 유지하세요개선 방법:
개선된 전체 프롬프트 예시:
이 이미지를 편집하여 두 가지를 수행하세요: ① 빨간 상자 안의 두 잔을 무광 순수 검정으로 바꾸되, 원래의 재질 질감과 형태는 보존하세요; ② 빨간 상자 윤곽선 자체를 삭제하세요. 이미지의 다른 모든 항목의 색상, 위치, 치수 레이블, 텍스트는 완전히 그대로 유지하세요.
어떻게 개선해야 할지 모르겠다면? AI에게 다시 쓰게 하세요
프롬프트를 개선하는 일 자체도 AI에 맡길 수 있습니다. 널리 알려지고 신뢰할 수 있는 AI 채팅 제품(예:chatgpt.com 또는 gemini.google.com)에 다음 세 가지를 함께 보내면 됩니다:
- 원본 프롬프트 (그대로 붙여넣기);
- 문제 설명 (예: “검정색을 요청했는데 초록색이 나왔고, 빨간 상자도 제거되지 않았습니다”);
- 전후 비교 (원본 이미지와 실제 출력 결과를 함께 업로드).
전략 2: 실패 시 재시도
실패는 단일 샘플 변동성에서 비롯되므로, 재시도 자체가 효과적인 해결책입니다 — 동일한 요청을 다시 보내면 대개 그대로 작동합니다(이번 사례에서도 정확히 그렇게 되었습니다).- 비즈니스 코드에서는 “결과가 기대와 일치하지 않음”에 대해 자동 재시도를 1–2회 정도 두십시오;
- 두 가지 실패 유형을 구분하십시오: “이미지는 반환되었지만 편집이 잘못됨”과 “이미지가 전혀 없음”입니다. 후자(HTTP 200이지만 이미지 없음)는 보통 콘텐츠 모더레이션 차단입니다 — Gemini Image API 오류 처리 가이드를 참조하십시오.
전략 3: 모델 전환
이 사례에서는 동일한 prompt + 이미지로 다른 모델들을 테스트해 보았으며 — 모두 첫 시도에서 성공했습니다:
서로 다른 모델은 각기 다른 지시 유형에 강점이 있습니다. 특정 모델에서 계속 실패하는 작업도 다른 모델에서는 즉시 통과할 수 있습니다. APIYI 통합 게이트웨이에서는
model 파라미터만 변경하면(동일한 키, 동일한 엔드포인트) 모델을 전환할 수 있어 비용이 거의 들지 않습니다. 이미지 워크플로에서 “모델 전환”을 핵심 단계로 삼으십시오 — 이는 타협이 아니라 목표를 달성하기 위한 정당한 전략입니다.
실제 운영에서는 “빠른 모델 우선, 강력한 모델 사후 투입” 계층 구조를 구성하십시오:
- 일상적인 작업에는 빠르고 저렴한 모델(예:
gemini-3.1-flash-image)을 기본값으로 사용합니다. - 정밀 편집 작업이 1~2회 실패하면
gemini-3-pro-image또는gpt-image-2시리즈로 자동 에스컬레이션하여 재시도합니다. - 그래도 해결되지 않으면 다시 돌아가 prompt를 수정합니다.
특수한 경우: 흐릿한 작은 텍스트는 모델 문제가 아니라 품질 등급 문제입니다
이미지에 포스터, UI 스크린샷, 간판, 차트 라벨 등의 텍스트가 포함된 경우, 작은 글자가 흐릿해지는 현상은 모델 성능 부족이 아니라 대개 품질 등급이 너무 낮게 설정되었기 때문입니다. 먼저 모델이 어떤 등급을 제공하는지 확인하십시오:
모델 간에 등급 이름이 같다고 해서 동일한 등급을 의미하지는 않습니다: 2.5 시리즈는 등급 체계를 재조정했으므로 2.5의
high은 대략 gpt-image-2의 medium에 해당하며, 오직 2.5의 max만이 gpt-image-2의 high과 일치합니다. quality을 변경하지 않고 그대로 유지하면서 gpt-image-2에서 마이그레이션하면 은연중에 등급이 하나 낮아져 “새 모델의 텍스트 렌더링 성능이 더 나빠졌다”고 인식될 수 있습니다. 등급별 수치는 GPT-Image-2.5 / 2 이미지 생성/편집에서 확인할 수 있습니다.
Gemini 패밀리(Nano Banana 2 / 2 Lite)는 quality 파라미터를 지원하지 않습니다. 이 모델에서 조정할 수 있는 것은 해상도와 thinkingLevel입니다. 이미지 내 텍스트 레이아웃이나 구도 논리가 매우 중요한 경우 thinkingLevel: "high"을 활성화하십시오. 단, 비용이 약 +54%, 지연 시간이 약 +55% 증가합니다. gemini-3-pro-image은 이 조정을 지원하지 않습니다. 메커니즘에 대한 자세한 내용은 사용 필드 및 출력 설명을 참조하십시오.
전략 4: 테스트 도구로 먼저 문제를 분리하기
“출력이 왜 잘못되는지”를 디버깅할 때는 먼저 변수를 분리합니다. imagen.apiyi.com에서는 코드를 작성하지 않고도 “prompt + image” 조합을 빠르게 검증할 수 있습니다.- 도구에서도 실패함 → 대부분 prompt/작업 문제입니다. 전략 1로 돌아가거나, 전략 3에 따라 모델을 바꾸십시오;
- 도구에서는 성공하지만 코드에서는 실패함 → 코드를 점검하십시오. 이미지가 완전히 업로드되었는지, 파라미터가 올바른지, prompt가 잘리거나 이스케이프 처리로 인해 망가졌는지 확인하십시오;
- 때로는 되고 때로는 실패함 → 샘플링 분산입니다. 전략 2에 따라 재시도를 추가하십시오.
빠른 참조
- 웹 앱 ≠ API: 웹 앱은 prompt 재작성 및 다단계 오케스트레이션을 갖춘 완전한 에이전트이며, API는 입력한 prompt를 그대로 사용하는 단일 원자적 호출입니다 — 체감되는 차이는 대부분 파이프라인에서 비롯되며, “API의 이해도가 낮아서” 발생하는 것이 아닙니다.
- 단일 호출의 무작위 변동성은 생성형 모델 고유의 특성입니다 — 단 한 번의 실패가 모델이나 게이트웨이에 문제가 있음을 의미하지는 않습니다.
- 전략 1, prompt 개선: 구체적인 명사, 명확한 색상 지정, 유지할 요소 열거, 작업에 번호 매기기 — 한 번에 한 가지 범주의 요소만 변경하십시오.
- 전략 2, 재시도: “잘못된 편집”에 대해서는 1~2회의 재시도를 계획하십시오. “이미지 없음”은 다른 유형의 문제입니다(오류 처리 가이드 참조).
- 전략 3, 모델 전환: 이 경우
gemini-3-pro-image,gemini-3.1-flash-lite-image및gpt-image-2시리즈 모두 첫 시도에서 성공했습니다. 통합 게이트웨이에서는 파라미터 하나만 변경하면 됩니다. - 흐릿한 작은 텍스트: 먼저 품질 등급 상향: 텍스트가 포함된 이미지의 경우 최소
high(2.5 시리즈에서는xhigh/max)를 사용하고, 적용 전 token 비용을 확인하십시오. Gemini 제품군에서는 대신thinkingLevel: "high"을 사용하십시오. - 전략 4, 테스트 도구를 활용한 문제 격리: imagen.apiyi.com에서 “prompt + 이미지”를 먼저 검증하여 prompt 문제, 코드 문제, 샘플링 변동성을 구분하십시오.