

APIの概要
Log Query API は、アカウント内で実行されたすべての API 呼び出しの詳細記録を返します。 これには、使用されたモデル、実際に請求された金額、レイテンシ、呼び出しがストリーミングだったかどうか、 および呼び出しが失敗したときのエラーコードが含まれます。 これは 残高照会 API を補完するものです。残高照会では残っているクレジット量がわかり、 ログ照会ではそれがどこに使われたかがわかります。 代表的なユースケースは3つあります:自動照合
期間ごと、またはモデルごとに実際の支出を集計し、自社の課金と照合する
セルフサービスのトラブルシューティング
失敗したリクエストのエラーコードを確認し、パラメータの問題か上流側の問題かを見分ける
サポートチケット
正確な呼び出しを特定できるよう、
request_id をサポートに提供するログはコンソールの Logs ページでも確認できます。この API は同じデータへのプログラム用エントリーポイントであり、自動照合、定期エクスポート、または独自の監視への取り込みを目的としています。手動で確認する場合はコンソールを使用してください — 呼び出し記録の確認方法をご覧ください。
パーソナルアクセス token の取得方法
ログクエリ API はパーソナルアクセス token(nap_で始まります)で認証を行いますが、これは API キーとは異なります(本ページ末尾の「重要な注意事項」を参照してください)。
1
Personal Access Tokens を開く
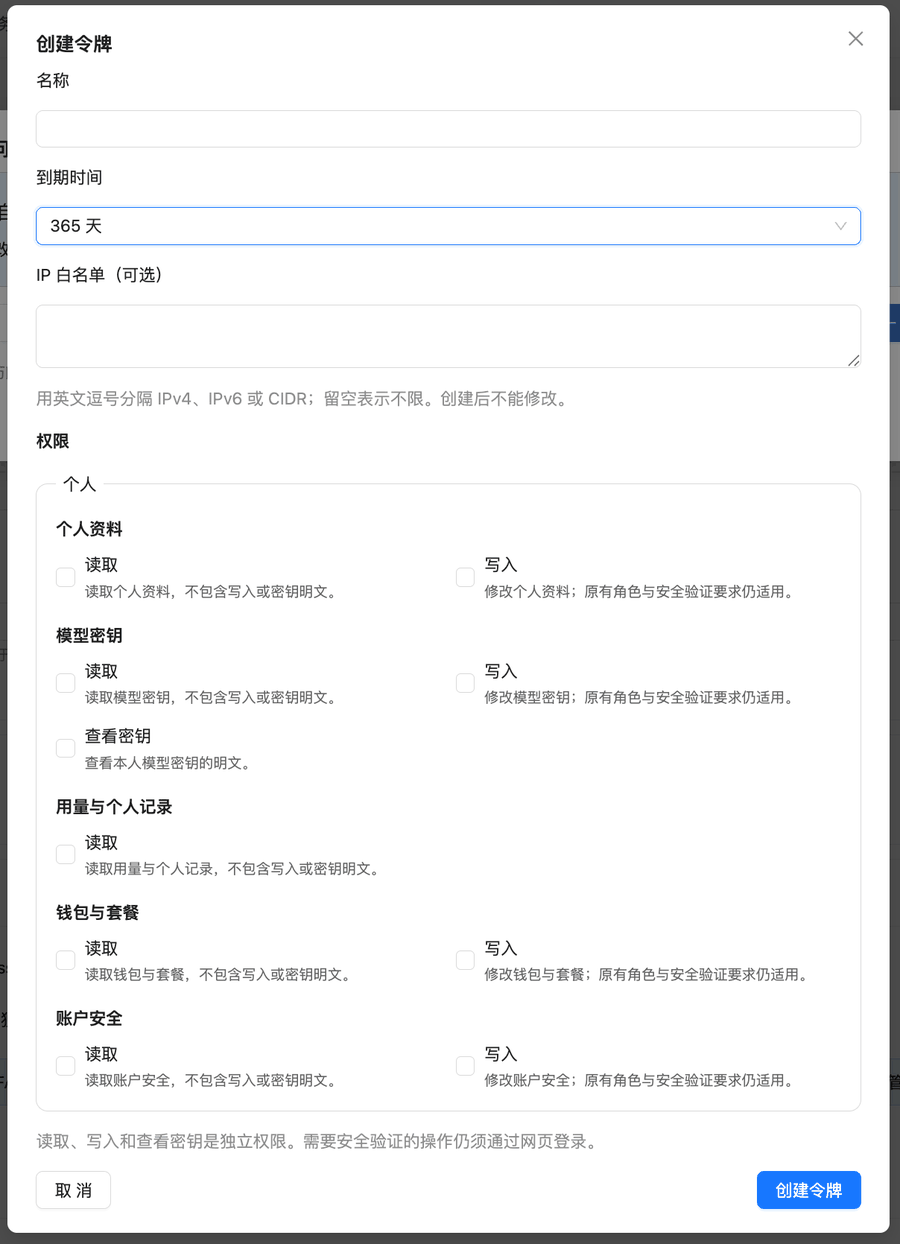
api.apiyi.com/account/profile のプロフィールページに移動します。アカウントオプションで、Personal Access Tokens → Create Token をクリックします。2
権限を選択する
この API に必要なのは Usage & personal records · Read のみです。日次の定期実行ジョブの場合は、長めの有効期限を選択してください。デフォルトは30日間で、token の有効期限が切れるとスクリプトは 401 を受け取ります。
3
IP許可リストを設定する(任意)
同期スクリプトを固定 IP のサーバーで実行する場合に推奨されます。許可リストは作成後に編集できません。まずは許可リストなしでスクリプトが正常に動作することを確認し、その後、許可リストを設定した本番用 token を別途作成してください。
API情報
リクエストの詳細
リクエストヘッダー
Query Parameters
Raising
pageSize is the single most effective optimization for this endpoint. At 10 records
per page, an account making 500,000 calls a day needs 50,000 requests; at 5000 per page it needs
100. Two orders of magnitude fewer requests, and the pagination offset drops with it — see
Performance Notes below.A 5000-record page measures roughly 700 KB gzipped and takes about 2.5 seconds. If bandwidth or
memory is tight, 1000 is a comfortable middle ground.パフォーマンスに関する注意
単一リクエストのコストは固定ではありません。それは 3 つの要素に依存します。これらのルールに従えば API は高速ですが、無視するとサーバー側の 60 秒クエリ制限に達し、エラーが返ります。
実践的なルールは 4 つあります。
start_timestampとend_timestampを必ず渡してください。 ウィンドウを省略するのは、この API を呼び出すうえで最も高くつく方法です。pageSizeを引き上げてください。 これは簡単です。1ページあたり 10 件から 1000〜5000 件にすると、リクエスト数を 2 桁減らせて、オフセットもそれに伴って小さくなります。- オフセットを深くするのではなく、ウィンドウを狭めてください。 コストがかかるのは「どのページか」ではなく、「そこにたどり着くまでに何件スキップしたか」であり、それは超線形に増えます。1つの大きなウィンドウを最後までページングするのではなく、24 個の 1 時間ウィンドウに分割し、各ウィンドウを offset 0 から再開するようにしてください。
- 履歴は一度だけバックフィルして保存し、その後は増分だけを同期してください。 古いデータは最新データよりクエリコストがはるかに高いため、同じ履歴を何度も読み直すのは完全な無駄です。
pageSize=1000 でもウィンドウが数十ページかかるなら、その期間の呼び出し量は多いということです — ウィンドウを半分に分け、それぞれを別々に取得してください。これは、さらに深くページングするよりずっと速いです。下の Python 例にある MAX_PAGES 定数は、まさにこれを行っています。60 秒は厳格な上限で、それを超えるとエラーが返ります
サーバーは単一クエリを 60 秒 に制限しています。それを過ぎると遅い応答が返るのではなく、 エラーが返り、そこまでに費やした時間ではデータは一切得られません。 次の 3 つのパターンは、これを引き起こしやすいです。再試行して期待するのではなく、最初から避けてください。
同じパラメータで再試行しても速くはなりません。単にさらに 60 秒かかるだけです。
正しい対応は、時間ウィンドウを狭めるか、
pageSize を引き上げてページングを減らすことです —
どちらにしても、1 回の呼び出しでサーバーが処理するデータ量を減らしてください。
ログタイプ
レスポンス詳細
成功レスポンスの例
主要レスポンスフィールド
otherフィールドにはネストされたオブジェクトではなくJSON文字列が格納されるため、2回目のパースが必要です
(Pythonではjson.loads()、JavaScriptではJSON.parse())。これにはbilling_type、
request_path(実際に呼び出されたエンドポイント)、group_ratio、model_ratio、およびusageが含まれます。非同期動画タスクの精算エントリには、final_quota(タスクの最終合計)、original_quota
(送信時に行われた事前課金)、adjustment_quota(このエントリの差額)およびactual_tokensも含まれます。詳細は以下のFAQを参照してください。クォータ換算
換算ルール
500,000クォータ = $1.00 USD
quota ÷ 500,000
例:
quota: 7500→ $0.015 USDquota: 22500→ $0.045 USDquota: 18→ $0.000036 USD
エラーレスポンス
HTTP 401 - 認証失敗
sk-で始まるもの)が誤ってパーソナルアクセス tokenとして使用されています。アカウントのパスワード、2要素認証、またはパスキーを変更すると、すべてのパーソナルアクセス tokenが無効化されます。
解決策: コンソールで新しいパーソナルアクセス tokenを作成してください。
他の2つの401レスポンスには明示的なメッセージが含まれています:
HTTP 403 - 権限拒否
コード例
cURLの例(単一ページ、クイック確認)
これを使用してtokenが機能することを確認してください。本格的な照合を行う場合は、以下の日次同期スクリプトを使用してください。
Python の例: 日次の増分同期(cron ジョブとしてすぐ使えます)
これは 推奨される標準的な使い方 です。1日1回実行し、前回の同期以降に新しくなったものだけを取得して、 ローカルの SQLite データベースに書き込みます。再実行しても安全です(レコードはrequest_id で重複排除されます)。また、途中で中断された実行は停止したところから再開されます。
データがローカルにあれば、モデル別、日別、token 別など、必要なあらゆる集計はすべて
ご自身のデータベースに対して実行されるため、そのために再び API に問い合わせる必要はありません。これははるかに高速で、
すでに保持期間を過ぎて消えたデータが欲しくなる問題も回避できます。
Node.js の例(単一の時間枠)
考え方は同じです。1時間ごとに分割し、順番にページングし、ページネーションが深くなりすぎたら時間枠を縮小します。Python の requests ライブラリと Node.js の fetch API はどちらも gzip を自動的に展開するため、
その場合は追加の設定は不要です。明示的な
--compressed フラグが必要なのは curl のみです。Common Scenarios
日次照合(推奨される方法)
上の Python スクリプトを 1 日に 1 回実行するようにスケジュールし、ログをローカルデータベースに保存します。必要な内訳——総支出、モデル別、token別——はすべて、自分のデータベースに対する SQL クエリで取得できます。 これが適切な形である理由は 3 つあります。ローカルのクエリは高速であること、ログの保持期間の影響を受けないこと、そして古い履歴を繰り返し読み直すことで API の速度を落とさずに済むことです。 1 つの model のレコードだけを同期するには、リクエストにmodel_name パラメータを追加します。
失敗した呼び出しの見つけ方
データがローカルにあれば、自分のテーブルを直接クエリします:ゲートウェイによって拒否されたリクエスト(無効なパラメータなど)は、
quota が 0 であり、
課金されません。ログ内の error_code を使うと、「呼び出しが失敗した」のか
「呼び出しは成功したが、結果が気に入らなかった」のかを分けられます。サポートに渡すリクエスト ID の指定
ログ内で問題のある呼び出しを見つけ、サポートにrequest_id を伝えてください。これにより、
エンドツーエンドで正確なリクエストを特定できるため、「ある model への呼び出しが
ある時刻の前後で失敗した」と説明するより、はるかに効率的です。
よくある質問
リクエストが遅い、または完全にタイムアウトします。どうすればよいですか?
リクエストが遅い、または完全にタイムアウトします。どうすればよいですか?
まず次の3点を確認してください。遅いクエリのほとんどは、これらのいずれかが原因です。
start_timestampとend_timestampを渡していますか? 時間範囲を省略することは、この API を呼び出すうえで 最もコストの高い方法です。サーバーが履歴全体を検索します。- 範囲が古すぎる、または広すぎませんか? 1か月前のデータをクエリするコストは、 昨日のデータをクエリするよりはるかに高くなります。範囲は1日未満に保ち、大量の場合は時間単位で分割してください。
pが数千に達していませんか? ページネーションのコストは超線形に増加します。対処方法は、 各時間範囲が数十ページだけで済むよう時間範囲を縮小することであり、1つの大きな範囲内で さらに深くページングすることではありません。
なぜレコードが10件しか取得できないのですか?
なぜレコードが10件しか取得できないのですか?
10回中9回は、パラメータが snake_case の 最大値は5000で、これを超えると明確なエラーが返されます。大量の場合でも、レスポンスが空の配列を返すまで
ページネーション(
page_size として記述されています。正しいスペルは camelCase の pageSize です。これはこの
エンドポイントで唯一の camelCase パラメータです。ほかのすべて(model_name、token_name、start_timestamp、…)は snake_case
であるため、間違えやすくなっています。エラーは発生せず、サーバーはこの
パラメータが存在しないものとして扱い、1ページあたり10レコードにフォールバックします。p=0、p=1、…)を行う必要があります。上記の Python と
Node.js の例では、すでにこの処理がカプセル化されています。request ID で特定の呼び出しを1件検索できますか?
request ID で特定の呼び出しを1件検索できますか?
はい。特定の1件の呼び出しを調査する場合、これは時間範囲を取得して
自分でフィルタリングするよりはるかに高速です。
request_id を渡すと、そのレコードのみが返されます。レスポンス内の一部フィールドが空です。何か問題がありますか?
レスポンス内の一部フィールドが空です。何か問題がありますか?
いいえ。一部のフィールドにはプラットフォーム内部の情報が格納されており、通常の
アカウントの観点では空またはゼロになります。これは想定どおりであり、照合やトラブルシューティングに必要な
フィールドには影響しません。
quota、model_name、error_code、および request_id
はすべて完全に設定されています。token_group がコンソールに表示されるグループ名と異なるのはなぜですか?
token_group がコンソールに表示されるグループ名と異なるのはなぜですか?
API はグループの識別子を返しますが、コンソールにはグループのラベルが表示されます。
これらは異なる場合があります。たとえば、API は
default を返しますが、コンソールには Default と表示されます。完全なマッピングは、公開エンドポイント https://api.apiyi.com/api/pricing の
usable_group フィールドから取得できます。このフィールドは識別子をラベルにマッピングします。レポートを
コンソールと一致させたい場合は、このマッピングを自身で適用してください。token 数とクォータが一致しないように見えます。どちらが正しいですか?
token 数とクォータが一致しないように見えます。どちらが正しいですか?
quota を使用してください。これは呼び出しに対して実際に差し引かれた金額であり、
照合に適した唯一のフィールドです。画像生成や動画生成などの呼び出しごとに価格設定されるモデルでは、
レスポンス内の token 数が価格設定に関与しないプレースホルダー値である場合があります。
これらのモデルは、other.billing_type に by_count を報告します。どこまで過去にさかのぼってクエリできますか?
どこまで過去にさかのぼってクエリできますか?
直近30日間のみクエリ可能であることを前提に、同期ロジックを設計してください。実際にはクエリ可能な範囲は通常もっと長いですが、保持については一切保証しません。
これはログクリーンアップポリシーに応じて変更され、その変更は個別に告知されません。30日間を
計画上の下限として扱えば、そのポリシーが変わっても照合処理は壊れません。また、範囲が古いほどクエリのコストは高くなります。データがまだ存在していても、
取得にははるかに時間がかかります。したがって、適切なパターンは1日に1回、自身のデータベースへ同期することであり、履歴分析は
ローカルで実行してください。長期間保持する必要があるものは、自身でアーカイブしてください。この
API から後で取得できることに依存しないでください。
curl が文字化けしたテキストを返す、または jq がエラーを出します
curl が文字化けしたテキストを返す、または jq がエラーを出します
理由: API は gzip 圧縮されたコンテンツ(Python の requests ライブラリと Node.js の fetch API は自動的に展開します。
Content-Encoding: gzip)を返しますが、curl が
それを展開していません。解決策: --compressed フラグを追加してください。動画タスクで2件のログエントリが生成されました。task_id への対応付けと動画のコスト取得はどうすればよいですか?
動画タスクで2件のログエントリが生成されました。task_id への対応付けと動画のコスト取得はどうすればよいですか?
非同期動画タスク(Seedance など)は「送信時に事前チャージし、完了時に差額を精算する」方式で課金されるため、
1本の動画につき2件のエントリが残ります。事前チャージ(そのページングパラメータは snake_case の
completion_tokens が0で、request_id が存在)と精算
(completion_tokens が実際の使用量、request_id は空、quota は差額のみ)です。
どちらのエントリにも task_id は含まれないため、この API ではエントリをタスクに対応付けられません。動画の実際のコストを取得するには、task_id でタスク API をクエリしてください。その quota は2件のエントリの合計です。page_size であり、p は1から始まる点に注意してください。これはこの API と逆です。
失敗したタスクでも quota には事前チャージが表示されますが、実際のコストは0です(ログには負の type=11 の返金エントリが含まれます)。
詳しい手順:task_id で Seedance 動画の実際のコストを検索する方法。ログのクエリはクォータを消費しますか?
ログのクエリはクォータを消費しますか?
いいえ。ログクエリのエンドポイントはクォータを消費しません。
重要な注意事項
推奨される呼び出しパターン
- 1日1回同期する — より頻繁に実行する必要はありません。各実行では新規データのみを取得します
- デフォルトの 10 ではなく、1000〜5000 の
pageSizeを使用する — これは他の要素すべてを合わせたものよりも重要です - ページ間は約1秒の間隔を空けてシリアルに呼び出し、決して同時に実行しないでください
- クライアントのタイムアウトは 60 秒に設定してください(サーバー側のクエリ制限も 60 秒です)
- 各時間ウィンドウは 1 日以下に抑えてください。データ量が多いアカウントの場合は、1時間ごとに分割してください
- タイムアウトが発生した場合は、再試行する前にウィンドウを狭めてください — 同じ条件で再試行しても処理速度は上がりません
関連ドキュメント
- 残高照会 API — アカウントの残りクレジットを確認
- Token 管理 API — API キーをプログラムで作成および管理
- 呼び出し履歴の確認方法 — コンソールでの手動確認
- ログと課金の理解 — 課金フィールドの読み取り方