

要約
8つのモデルはすべて、内部的に OpenAI の GPT-Image 2.5 / 2 シリーズをベースに構築されています。違いはチャネルの性質(公式直接かリバースエンジニアリングか)、料金モデル、およびパラメータの粒度にあります。3つの公式モデルは価格とパラメータが共通です。5つのリバースモデルは呼び出し形式が共通です(2つの
-all モデルは $0.025/画像、-vip の3モデルは $0.03/画像)。
3系統のリバースモデル(-all / 2.5-all / -vip の3種):本ページの「リバース」列は、
gpt-image-2-all、gpt-image-2.5-all、および gpt-image-2-vip / gpt-image-2.5-flare-vip / gpt-image-2.5-sunburst-vip(エイリアス gpt-image-2.5-vip = sunburst-vip)を対象としています。すべて同じ呼び出し形式を共有し(3つの -vip モデルはさらに size もサポート)、呼び出しごとに課金されます。2つの -all モデルは $0.025/画像、-vip の3モデルは $0.03/画像です:gpt-image-2-all/gpt-image-2.5-all:ChatGPT web 系統、約90秒の生成 — 速度が強みです。2.5-all は Images 2.5 をベースに提供されていますgpt-image-2-vipおよび2つの 2.5 -vip モデル:Adobe 系統(Firefly)、sizeの固定(4K を含む30種類のプリセット)。3モデルすべてがqualityを受け付けます(チャネル側の動作であり、保証事項ではありません)。2つの 2.5 モデルは2026-09-10の再テストでxhigh/maxが開放され、現在は全6段階に対応しています。gpt-image-2-vipは最大highまで対応します。3モデルすべてが透明な背景を返します。flare-vip は最も高速で柔らかい仕上がり、sunburst-vip は見た目がgpt-image-2-vipに近くなります- 共通事項:いずれも
nをサポートしていません。maskはすべてのモデルで画像全体の再生成となり、マスクされた領域のみを変更する保証はありません
n > 1 が必要な場合は、公式モデル(gpt-image-2.5-flare / gpt-image-2.5-sunburst / gpt-image-2)をご利用ください。完全比較表
🔑 API tokenの作成と管理:https://api.apiyi.com/token
コンソールで token を作成する際は、グループ(
コンソールで token を作成する際は、グループ(
Default で可)と token タイプ(Per-call / Token-priority)を選択してください。公式の3モデル(gpt-image-2.5-flare / sunburst / gpt-image-2)の呼び出しには「Token-priority」token が必要です — Per-call の token は課金モード不一致のため拒否されます。サンプル結果
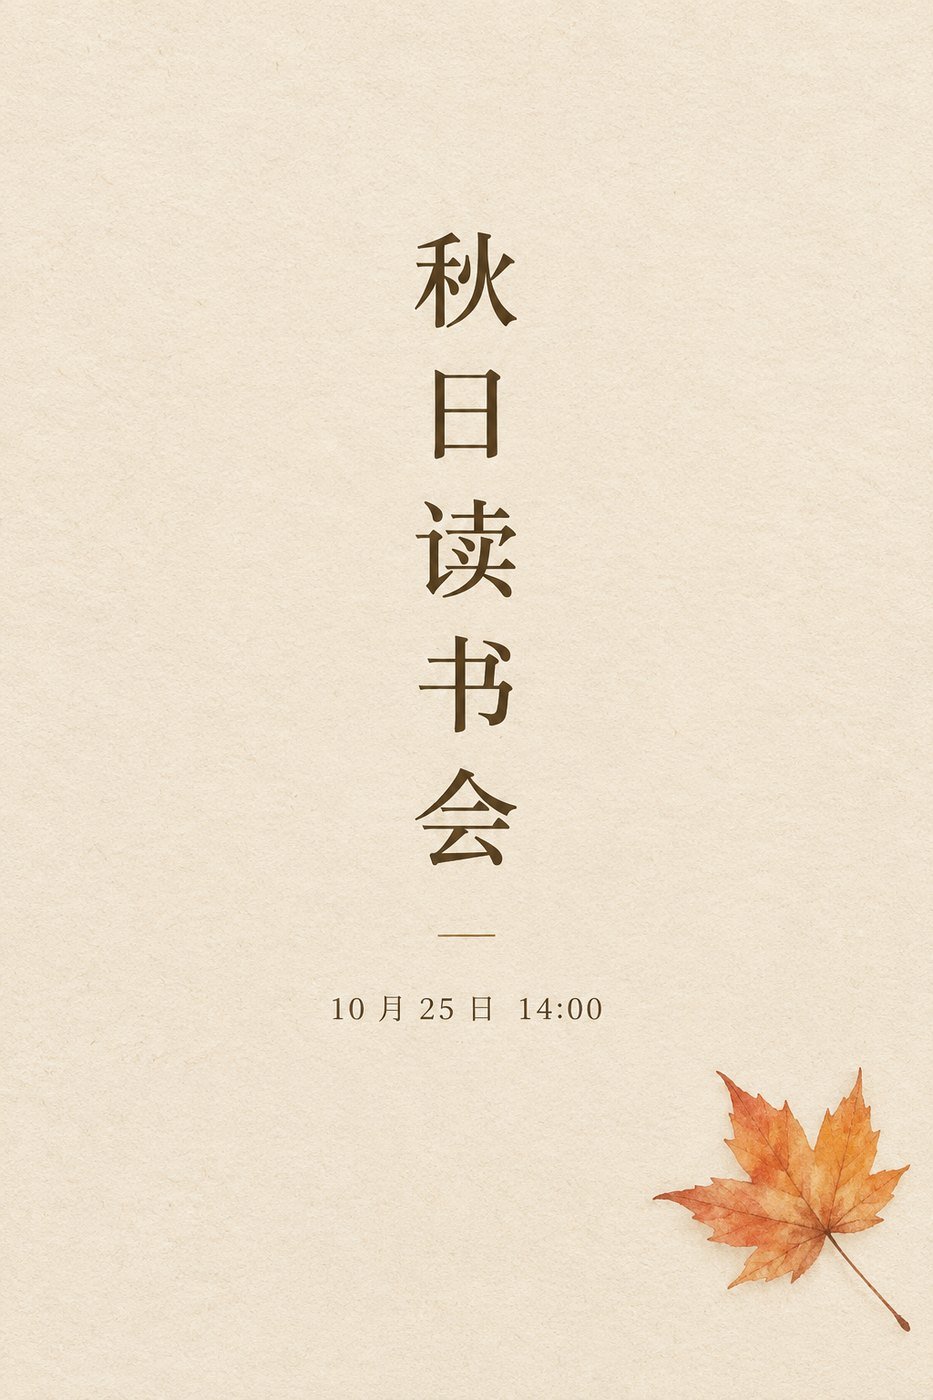
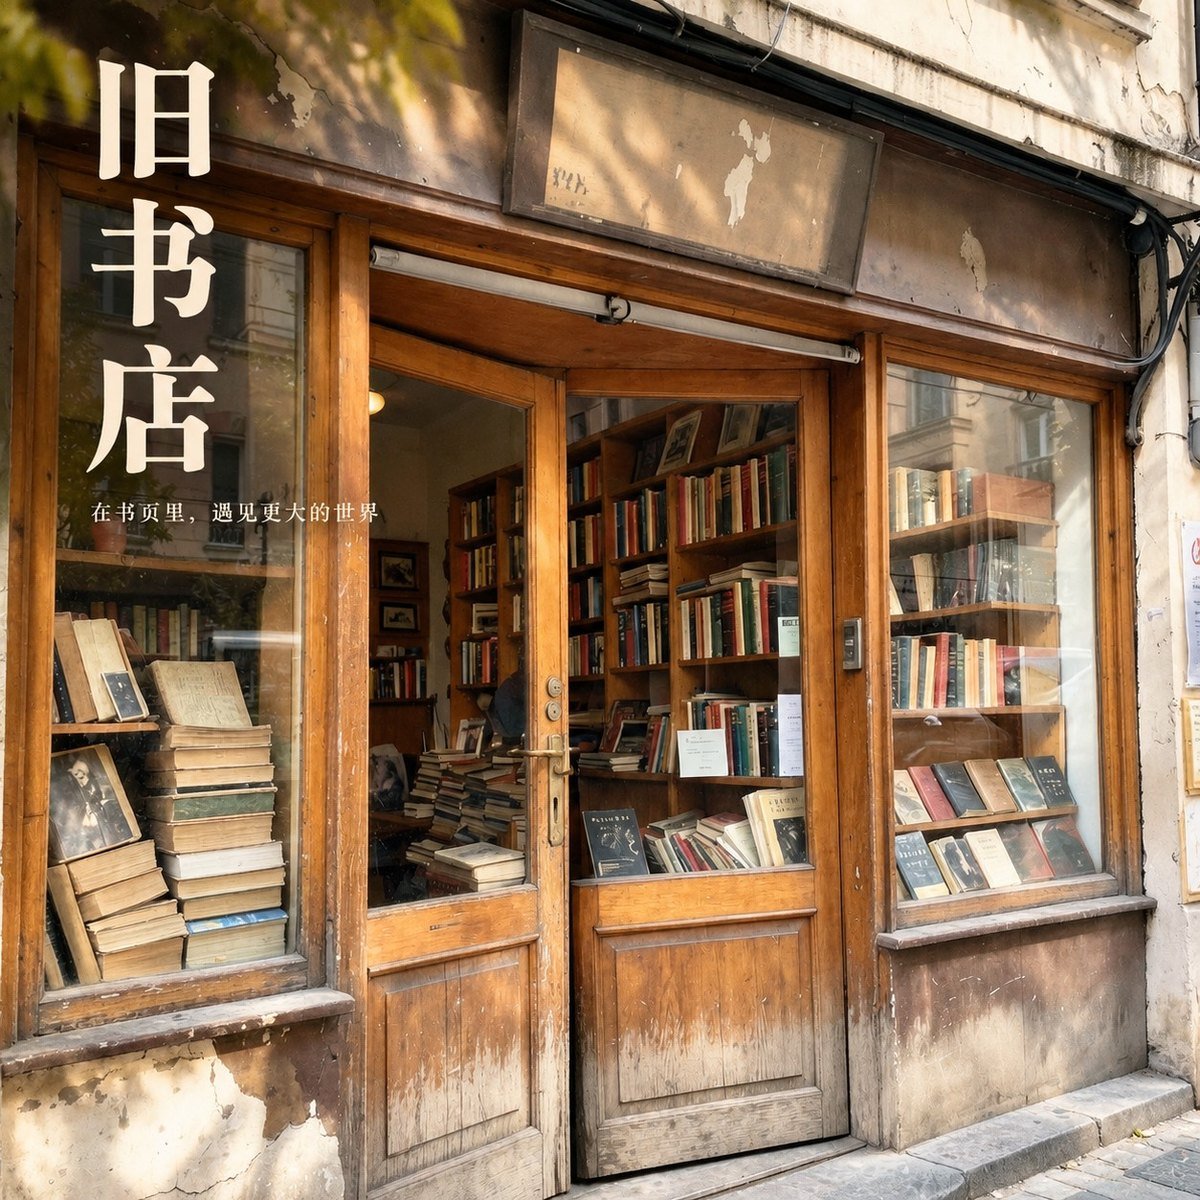
以下の2枚の画像は、どちらもgpt-image-2.5-allを使用して生成したもので、テキストから画像への生成と画像編集の結果を示しています。これらはこのモデルとこれらのプロンプトに限った結果であり、比較対象のすべてのモデルで同等の性能が得られることを保証するものではありません。
テキストから画像への生成 · 中国語の縦書きポスター(プロンプトのみ:温かみのあるベージュの紙の質感、中央に縦書きの中国語の見出し 秋日读书会、その下に日付 10 月 25 日 14:00、右下に手描きのカエデの葉):33.8 秒、縦書き見出しのすべての文字が正確で、日付の行もくっきりしており、余白と葉の配置も指示どおりです。
各モデルの選び方
gpt-image-2-all / gpt-image-2.5-all(リバース)を選ぶべきケース
💰 予測可能なコスト
サイズや品質ティアに関わらず安定した$0.025/画像(2026-10-10に$0.03から値下げ)で、チャージボーナス適用後はさらに低価格になります。明確なコスト上限があるバッチ生成に最適です(インフォグラフィック、マーケティング素材、ECサムネイルなど)。
⚡ より高速な出力
約90秒での生成 —
-vipおよび公式バージョンの両方よりもわずかに高速です。リアルタイムのUXが向上します。🔁 共通コードベースでいつでも切り替え可能
標準のImages API形式 — 3つの
-vipモデルおよび3つの公式モデルと同一のコードで使用でき、model名を変更するだけで切り替えやフォールバックが可能です。gpt-image-2-allとgpt-image-2.5-allは価格と動作が共通しており、新しい名称はChatGPT WebがImages 2.5に移行したことを反映しているにすぎません。🌏 中国語+マーケティングテキスト
ネイティブの中国語promptに対応し、看板・ポスター・インフォグラフィックなどのテキスト描画に優れています — 中国語圏向けのコンテンツ制作に最適です。
3つの-vipモデル(リバース、サイズ固定)を選ぶべきケース
🎚️ qualityが有効(2.5では全6ティア)
テストにおいて
gpt-image-2.5-flare-vip / gpt-image-2.5-sunburst-vipはautoからmaxまでの全6ティアを受け付けます(xhigh / maxは2026-09-10に解放)。gpt-image-2-vipは最大highまで対応します。これらはすべてチャネル側の動作であり、保証されたものではありません。ティアの対応関係:2.5のhighはgpt-image-2-vipのmediumにのみ相当し、2.5のmaxはgpt-image-2-vipのhighに相当します。一律$0.03の価格はティアによって変わりません。⏱️ 3モデル間の選択基準
flare-vipは最も高速で柔らかな画風、sunburst-vipはより高品質で編集精度が高く
gpt-image-2-vipに近い仕上がりになります。3モデルとも同じ最上位のtokenティアに達します(2.5ではmax、highではgpt-image-2-vip)。いずれも-allより低速であり(1024²でのmaxの実測値は80〜160秒)、待ち時間が許容できる場合に適しています。🖼️ 固定サイズ / 4K
sizeパラメータが復活しました(2026-07-22以降):30種類のプリセットサイズ(10種類のアスペクト比 × 1K/2K/4K)。ECのヒーロー画像、ポスターテンプレート、4K壁紙を正確な寸法で出力可能 — 4K追加料金なしの一律$0.03/画像です。🔁 -allとコードを共有
-allと同一のリクエスト構造(追加のsizeフィールドが1つあるのみ)— 速度と品質の好みに応じてmodel名を切り替えるだけで、1つのコードベースで5つのリバースモデルすべてに対応できます。-vipのsizeは/v1/images/generationsおよび/v1/images/editsエンドポイントでのみ機能します — /v1/chat/completions chatエンドポイントはsizeをサポートしていません。30種類のプリセット以外の任意のカスタムサイズや、精密なマスクインペインティングが必要な場合は、公式モデル(gpt-image-2.5-flare / sunburst)をご利用ください。このパラメータの利用可否はアップストリームの変更に準じます — 最新の状況についてはリアルタイム更新をご確認ください。公式モデル(gpt-image-2.5-flare / sunburst / gpt-image-2)を選ぶべきケース
🎚️ 品質ティア
全6つの
qualityティアが利用可能かつ公式に保証されており、公式スペックに準じた安定したティアとtoken数を提供します。リバースの2.5 -vipモデルでも全6ティアが解放されていますが(2026-09-10実測)、これは保証のないチャネル動作であり、gpt-image-2-vipは依然としてhighまでに留まります。🎯 マスクインペインティング
アルファチャネルマスクをサポート — 他の部分を保持したまま特定の領域のみを精密に修正できます。リバースモデルは画像全体を再生成する仕様のため、マスク領域のみの編集は保証されません。
🖼️ 任意のカスタムサイズ
sizeはプリセットに限定されず、あらゆる有効な解像度(4Kを含む)を受け付けます。-vipの3モデルは30種類のプリセットのみを保証し、それ以外は書き換えられます — 厳密なカスタムサイズが必要な場合は公式モデルをご利用ください。🔌 OpenAI公式と完全同一
公式Images APIを経由 — フィールドと動作はOpenAI公式と同一です。既存のOpenAI SDKベースのコードやシステムを変更ゼロで移行でき、長期的に安定して運用できます。
主な相違点の詳細
1. b64_jsonフォーマットの落とし穴(移行時のトラップ!)
2026年7月の検証時点で、公式モデルおよびリバースモデルはすべて**未加工のbase64(data:接頭辞なし)**を返します。ただし、以前のgpt-image-2-allには接頭辞が含まれていたため、最も安全な共通コードはまずそれをチェックすることです:
2. 解像度制御
gpt-image-2-all / gpt-image-2.5-all(sizeフィールドはありません — 構図はpromptに記述します。両モデルとも同じ挙動を示します):
-vipモデル(gpt-image-2.5-vip / gpt-image-2.5-flare-vip / gpt-image-2-vip。sizeは2026-07-22以降復元済み):
30種類のプリセットサイズ(10種類のアスペクト比 × 1K/2K/4K)を受け付けます — size: "WIDTHxHEIGHT"を直接渡します(30種類のプリセットのいずれかである必要があります。全リストは30種類のサイズ一覧表を参照してください)。3モデルともテストにおいてqualityも受け付けます(チャンネルの挙動であり、仕様を確約するものではありません):2つの2.5モデルは6つのティアすべてに対応し(xhigh / maxは2026-09-10に解放)、gpt-image-2-vipは最大highまで対応します。2.5モデルのhigh出力tokensはgpt-image-2-vip mediumにのみ相当し、それらのmaxはそのhighに相当します:
sizeを厳密に順守 + qualityティア。サンプルではgpt-image-2.5-flareを使用していますが、モデル名を変更するだけでsunburst / gpt-image-2に切り替え可能):
3. アップロード/出力フォーマットの相違点
4. コストの目安
公式の数値は概算です:2026-09-09に測定した出力tokens × 100万あたり$30(通常$0.001未満のprompt入力tokensを除く)。
モデルの価格は公式に準拠しており、プロバイダーの調整に応じて変更される可能性があります。上記の表は参考情報です。トップナビゲーションのモデル価格タブが正式な情報源となります:モデル価格。
要点:バッチ処理や低品質のワークロードでは、リバースチャンネルが必ずしも安価とは限りません(1K
lowは公式ティアの方が実際に安く、2つの2.5モデルでもmedium / highでわずか約$0.013 / 約$0.053です)。中〜高品質レンジ(gpt-image-2のmedium以上、2.5モデルのxhigh以上)では、リバースチャンネルの$0.025〜$0.03が最も有利な選択肢となります。qualityティア/マスクインペインティング/固定サイズ、4K/厳密なOpenAI-APIフィールドの互換性が必要な場合は、公式(token従量課金)を選択してください。クライアント設定
FAQ
入力画像を圧縮すべきですか?promptに4K / 8Kと記述すると効果はありますか?
入力画像を圧縮すべきですか?promptに4K / 8Kと記述すると効果はありますか?
はい、強く推奨します。 8つのモデルすべてにおいて、各入力画像を1.5MB未満(JPEG品質80〜90 / 解像度を縮小)に圧縮してください。散発的な
shell_api_error / Unknown errorレスポンスは過大な入力によって引き起こされることが最も多く、圧縮することで成功率とレイテンシを目に見えて改善できます。圧縮によって品質が低下することを心配する必要はありません — 出力解像度は入力サイズとは無関係です。「出力側」の制御は、3つの系統で異なります:gpt-image-2-all/gpt-image-2.5-all:promptの構図表現によって制御されます(-all 概要ページの検証済みフレーズ表を参照)— prompt内の4K/8Kは効果がありません- 3つの
-vipモデル(gpt-image-2.5-vip/gpt-image-2.5-flare-vip/gpt-image-2-vip):sizeフィールド(4Kを含む30種類のプリセットサイズ)によって制御され、オプションでquality(2.5モデルでは6つの階層、gpt-image-2-vipでは最大high)を指定できます — こちらもprompt内の4K/8Kは効果がありません - 公式モデル(
gpt-image-2.5-flare/sunburst/gpt-image-2):size+quality(任意の有効なサイズ)によって制御されます
同じAPI Keyで8つのモデルすべてを呼び出せますか?
同じAPI Keyで8つのモデルすべてを呼び出せますか?
はい。8つのモデルはすべてDefaultグループで動作するため、同じAPI Keyで追加設定なしに呼び出すことができます。注意:公式モデルの呼び出しには「Token優先」tokenが必要です。
-all / -vipはいずれのtokenタイプも受け入れます。リバースチャンネルではどのエンドポイントを使用すべきですか?
リバースチャンネルではどのエンドポイントを使用すべきですか?
次の2つの理由から、OpenAI Images API(テキストから画像への生成には
/v1/images/generations + 編集には/v1/images/edits)を使用してください:- より安定的:Images APIチャンネルの上流リソース供給の方が豊富なため、呼び出し成功率が高くなります
- 公式リレーと互換性があり簡単に切り替え可能:呼び出し方法とパラメータ形式は3つの公式モデル(
gpt-image-2.5-flare/sunburst/gpt-image-2)と完全な互換性があります — リバースチャンネルでリスクコントロールによる乱れが発生した場合でも、コードを変更することなく**model名を変更するだけで公式リレーに切り替えることができます**
/v1/chat/completions、現在は非推奨)もありますが、これはマルチターンの反復編集やオンライン画像URLを直接渡す場合にのみ有用です。画像生成の意図が曖昧な場合、画像の代わりにプレーンテキストが返されることがある点にご注意ください(固定のプレフィックス「Generate an image:」などを先頭に追加して補強してください)。パラメータの詳細については、-all チャットベースAPIリファレンス / -vip チャットベースAPIリファレンスを参照してください。リバースチャンネル内では、-all と -vip のどちらを選ぶべきですか?
リバースチャンネル内では、-all と -vip のどちらを選ぶべきですか?
どちらの系統もリバースエンジニアリングされたチャンネル(-allは$0.025/画像、-vipは$0.03/画像)であり、呼び出し形式は同一です(
-vipの3モデルは追加でsizeの固定とqualityに対応しており、2.5モデルでは全6段階をサポート)。違いは速度 vs 品質 + サイズ固定です:- 生成時間:
-all/2.5-allは約90秒 — 速度が強みです。-vipの3モデルは約120〜200秒です。現在はOpenAIの上流コンピュートの変動により、リリース時よりも遅くなっています - 品質:
-vip(Adobe系統)のディテール描画はより高い場合があります — お急ぎでなく、ポートフォリオ用の画像などに適しています。3モデルの中では、sunburst-vipはgpt-image-2-vipに近く、flare-vipはよりソフトな描写になります - サイズの固定:
-vipの3モデルは30種類のプリセットsize値(4Kを含む)をサポートしています。-all/2.5-allはsizeを受け付けず、構図はpromptに記述します
-all / 2.5-all、サイズの固定や4Kが必要な場合 → -vipの3モデル、30のプリセットを超えるカスタムサイズや精密なマスクが必要な場合 → 公式モデルを選択してください。詳細はGPT-Image-2.5-VIP 概要を参照してください。-vip内では、2つの2.5モデルと gpt-image-2-vip のどちらを選ぶべきですか?
-vip内では、2つの2.5モデルと gpt-image-2-vip のどちらを選ぶべきですか?
価格、グループ、呼び出し形式は同じです(2026-09-09に同じチャンネルおよびtokenで実施された253リクエストの3者間比較検証では、コントラクトが完全に一致していることが確認されています)。異なるのは次の3点のみです:
- 階層:2.5モデルは全6段階に対応(
xhigh/maxは2026-09-10に解放)、gpt-image-2-vipは最大highまでです。同名の階層でも同じではありません — 2048×1152では、2.5のhigh1,413 =gpt-image-2-vipmedium、2.5のmax5,650 =gpt-image-2-viphighです。3モデルすべてが同じ最高token階層に達します - 品質と速度:flare-vipは最も高速で、装飾的なディテールが控えめな柔らかい仕上がりになります。sunburst-vipは
gpt-image-2-vipに近い描写になります - デフォルトサイズ:flare-vipは1024×1536固定、他の2モデルは2048×2048です。固定するには必ず
sizeを渡してください
gpt-image-2.5-vipはsunburst-vipです。行ごとの完全な比較表はGPT-Image-2.5-VIP 概要の「3つの-vipモデルの比較」セクションにあります。サイズの固定や4Kが必要な場合はどうすればよいですか?
サイズの固定や4Kが必要な場合はどうすればよいですか?
まずは
-vipの3モデル(デフォルトはgpt-image-2.5-vip、最高token階層にはhighを指定したgpt-image-2-vipを選択)から始めてください。sizeパラメータは2026-07-22に復旧し、4Kの追加料金なしの一律$0.03/画像で**30種類のプリセットサイズ(10種類のアスペクト比 × 1K/2K/4K)**をサポートしています。なお、sizeはimagesエンドポイントでのみ機能し、30種類のプリセットのいずれかである必要があります。30種類のプリセットを超える任意の有効なサイズ、公式に保証されたquality階層(-vipの階層はチャンネルの挙動であり保証はありません)、精密なマスクインペインティング(アルファチャンネルマスク)、または厳密なOpenAI APIフィールド互換性(既存のOpenAI SDKコードを無変更で移行)が必要な場合は、公式モデル(gpt-image-2.5-flare / sunburst / gpt-image-2、token従量課金)をご利用ください。1.5からの移行では、どれを選ぶべきですか?
1.5からの移行では、どれを選ぶべきですか?
- OpenAI SDKをそのまま使い続けたい / OpenAI公式と完全に一致させる必要がある、または30種類のプリセット以外のカスタムサイズが必要な場合:公式モデル(テキストから画像への生成には
gpt-image-2.5-flare、編集にはgpt-image-2.5-sunburst)を選択してください。input_fidelityを削除し、それ以外は変更せずにそのまま使用できます(background: transparentは引き続き動作します)。 - コストを削減し、高速な出力を求める場合:
gpt-image-2.5-allを選択してください(リバース、約90秒、gpt-image-2-allと同等の価格および挙動)。 - コストを削減し、品質を最優先する場合、あるいはサイズの固定 / 4Kが必要な場合:
gpt-image-2.5-vipを選択してください(リバース、約120〜200秒、4Kを含む30種類のプリセットサイズ、全6段階のquality階層に対応。gpt-image-2-vipはhighまで)。
フェイルオーバー用に複数のモデルをデプロイできますか?
フェイルオーバー用に複数のモデルをデプロイできますか?
はい。一般的なパターンは、プライマリに
2.5-allまたは2.5-vip(予測可能なコスト — 速度や品質の好みに応じて選択)、フォールバックに公式のgpt-image-2.5-flare / sunburst(quality階層、マスク、または30のプリセット以外のカスタムサイズが必要な場合に切り替え)とする構成です。リバースと公式ではレスポンスの構造が異なるため、ビジネスロジック層で正規化を行ってください。R2 CDNの画像リンクが遅いのですが、どうすればよいですか?
R2 CDNの画像リンクが遅いのですが、どうすればよいですか?
CDNダウンロードが遅い場合の対処法を参照してください。
関連ドキュメント
- GPT-Image-2.5 / 2 概要 - 3つの公式モデルに対応した完全な統合ドキュメント
- GPT-Image-2.5-All 概要 - リバース ChatGPT-web ライン(最速出力;
gpt-image-2.5-all/gpt-image-2-all)の完全な統合ドキュメント - GPT-Image-2.5-VIP 概要 - リバース Adobe ライン(
gpt-image-2.5-vipシリーズにgpt-image-2-vipを追加;sizeロック、quality階層)の完全な統合ドキュメント - 詳細解説:GPT-image-2.5 リリース - 2.5デュアルモデルのリリース
- 詳細解説:gpt-image-2 リリース - 公式バージョンのリリース
- 詳細解説:gpt-image-2-all リリース - リバースエンジニアリング版のリリース
- コミュニティ:Luck GPT-Image 2 ComfyUI ノード - マルチモデル ComfyUI ノードパック
- コミュニティ:APIYI GPT-Image 2 スキル - マルチモデル AI Agent スキルパック
- チャージプロモーション - チャージボーナスポリシー