

概要
gpt-image-2.5-all および gpt-image-2-all は、APIYIの GPT 画像生成リバースエンジニアリングモデル(ChatGPT Web系統)です。ChatGPT Webアプリ全体がImages 2.5に移行したため、gpt-image-2-all はすでに2.5画像を生成します。新しい gpt-image-2.5-all という名称は、そのアップグレードを明確にしたものに過ぎません。両名称は価格と挙動が共通しており、相互に互換性があります。新規プロジェクトでは gpt-image-2.5-all をご使用ください。1回の呼び出しあたり $0.025/image という極めて競争力の高い価格設定(2026-10-10に$0.03から値下げ)で、約30〜60秒で画像を生成し、テキスト画像生成 / 単一画像編集 / 複数画像合成 / 自然言語編集をサポートしています。テキストレンダリングの再現性が高く、中国語のpromptもネイティブにサポートしています。
/v1/images/generations(テキスト画像生成)および /v1/images/edits(画像編集)を使用します。出力サイズや4Kを固定する必要がありますか? 姉妹モデルのgpt-image-2-vipに切り替えてください。呼び出し形式は同一で、size フィールドが1つ追加されるだけです。テキスト画像生成 API
/v1/images/generations — テキストのpromptから画像を生成します。画像編集 API
/v1/images/edits — 編集・合成指示を含むマルチパートアップロード。AIエージェントに統合を任せる
このpromptをコピーしてCodex / Claude Code / Cursorに貼り付けてください
まずこのページのプレーンテキスト版を取得し(任意のドキュメントURLに.mdを追加)、プロジェクト独自の技術スタックでコードを記述します。タイムアウト、base64レンダリング、アップロード圧縮、そしてこのモデルで拒絶されるパラメータはあらかじめ要件に組み込まれています。
このプロジェクトにgpt-image-2-allのText-to-Image(テキストからの画像生成)および画像編集を統合 / トラブルシューティングしてください。
コードに触れる前にドキュメントを読んでください:このページのプレーンテキスト版を取得するには https://docs.apiyi.com/en/api-capabilities/gpt-image-2-all/overview.md を取得してください。より詳細なパラメータについては、
.mdを…
- タイムアウト:クライアントのタイムアウトを360秒に引き上げてください。画像APIは同期的です — タスクIDが存在しないため、クライアントが切断されると結果が失われます…
合計6つの要件があります。以下のボタンを使用してprompt全体をコピーしてください。
このpromptが防ぐトラブル
このpromptが防ぐトラブル
主な機能
非常に競争力のある価格設定
高度なテキストレンダリング
中国語プロンプトに対応
複数画像の融合
より高速な出力
gpt-image-2-vipと公式リレーのgpt-image-2の双方よりも高速ですR2 CDNによる高速化
response_format: "url"を渡します自然言語による編集
標準エンドポイントのサポート
/images/generationsおよび/images/editsと互換性があります料金
- 一律料金です。解像度、品質、prompt の長さによる料金設定の違いはありません
- 失敗したリクエスト(認証エラー、パラメータ検証エラー)には課金されません
- N枚の画像が必要な場合は、API を並行して N 回呼び出してください
グループの設定
gpt-image-2-allはDefaultグループに存在するため、追加のグループは不要です。リバースチャネルは現在安定して供給されているため、公式リレーのgpt-image-2のようなエンタープライズグループへのフォールバック構成は存在しません。
確定的なURL出力が必要な場合 → image2_OSSグループへの切り替え
デフォルトグループにおいて2026年7月時点で計測された結果では、response_formatを省略した場合、gpt-image-2-all(およびgpt-image-2-vip)はb64_jsonを返します。画像のURLを取得するには明示的にresponse_format: "url"を渡してください。デフォルトグループの出力形式は保証されていません — これまではデフォルトでurlとなり、高負荷時にはb64_jsonへフォールバックしていましたが、チャネルのバージョンによって変更されてきました。
業務がURL出力に依存している場合(データベースへのURLの直接書き込み、URLによるフロントエンド描画、base64が許容されない場合など)、tokenのグループを**image2_OSSに切り替えてください。これは確定的なURL出力**のために特別に構築されたグループであり、**1倍レート倍率(追加料金なし)**で、両方のリバースモデルgpt-image-2-allおよびgpt-image-2-vipに有効です。レスポンスに常に画像URLが含まれ、base64にフォールバックしないことが保証されます。
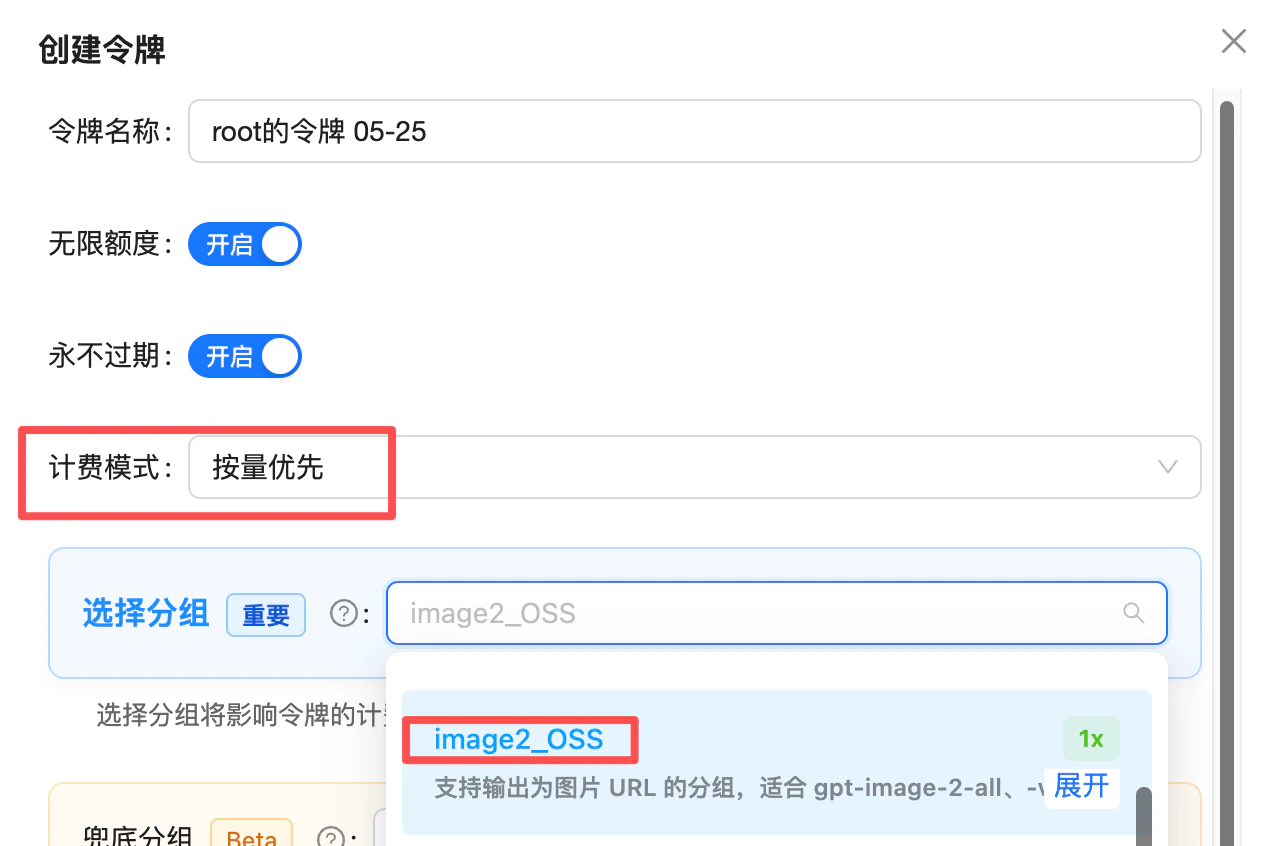
Token creation: set billing mode to "pay-as-you-go first" and pick the image2_OSS group (1x) — use it when you need deterministic URL output
image2Enterpriseグループについて:/en/live/2026-04/image2-enterprise-stable
技術仕様
エンドポイント
sizeパラメータで出力サイズを固定したいですか? 姉妹モデルのgpt-image-2-vipをご利用ください — エンドポイントは同一で、追加のsizeフィールドが1つあるだけです(4Kを含む30種類の明示的なサイズに対応)。サイズとアスペクト比の制御(prompt 内に記述)
gpt-image-2-all には size パラメータがありません。サイズは prompt に記述します。出力サイズを厳密に固定したい場合(EC のヒーロー画像、ポスターテンプレート、4K 壁紙など)は、代わりに gpt-image-2-vip を使用してください。
検証済みの「prompt の表現 → 実際の解像度」表
以下の 8 つの表現は、実際に安定して再現されることが確認済みです。第 1 列の表現を prompt の 先頭 に置くと、第 2 列に示した解像度が得られます(いずれの出力もおよそ 1.5K ピクセル帯です)。- すべての出力は 約 1.5K ピクセル帯(長辺 1500〜2000 px)です。これはモデルの実質的な上限であり、本当に「任意の解像度」ではありません。
- prompt に表の表現以外を 入れない ときが、再現性が最も高くなります。ほかの構図に関する語を混ぜると、ずれが生じます。
- 中国語の文字列は実際に送信する値です。翻訳せず、そのまま使うことをおすすめします。
スタイル用の表現(固定解像度なし)
以下の表現には検証済みの解像度がありません。上の表と組み合わせて、スタイル修飾子としてのみ使用してください。この表をエンドユーザーに公開する
gpt-image-2-all には size パラメータがありませんが、ユーザーに「サイズ / アスペクト比」ドロップダウンを用意して、公式の size フィールドのように見せる ことはできます。
- 上の表にある prompt の表現を、オプションの
valueとして使用します(例:横版 16:9) - ユーザーが何を得られるか分かるように、オプションラベルに 予想解像度 を表示します(例:
Landscape 16:9 (1672×941)) - バックエンドでは、選択された表現をユーザーの元の prompt の先頭に付けてから API に送信します
ベストプラクティス
入力画像を1.5MB未満に圧縮する(画像編集 / マルチ画像融合)
4K / 8K を詰め込んでも高解像度画像にはなりません。より大きい出力を安定して得るには、上の「検証済みのprompt表現 → 実際の解像度」表の表現を使ってください。サイズはpromptの先頭に置く
テキスト要素を自信を持って使う
マルチ画像の順序を明記する
image フィールドを繰り返す順序には意味があります。prompt では「image1/image2/image3」と明示的に参照してください。必要に応じてレスポンス形式を選ぶ
b64_json は直接Web描画用、url はサーバー側での保存/転送用です。300秒のタイムアウトを使う
拒否されるパラメータを削る
gpt-image-2-all は size, n, quality, aspect_ratio を拒否します — 送信すると検証エラーが発生することがあります。size を通すには、gpt-image-2-vip に切り替えてください。エラーコードと再試行
- リクエストタイムアウトは 300秒から に設定してください(保守的。一般的には 30〜60s ですが、画像のアップロード / ダウンロードとリバースチャネルのピークテールにより変動が大きく、120s では誤タイムアウトが頻発します)
- 5xx とタイムアウトには 指数バックオフ を使用してください(2〜3回の再試行を推奨)
- デバッグのために
request-idレスポンスヘッダーをログに記録してください
FAQ
gpt-image-2-all と gpt-image-2-vip の両方がありますが、どちらを選ぶべきですか?
gpt-image-2-all と gpt-image-2-vip の両方がありますが、どちらを選ぶべきですか?
size のサポート、生成時間、安定性です:- 厳密なサイズ制御が不要で、より高速かつ安定した出力を求める場合 →
gpt-image-2-all(約30〜60秒、プロンプト内でサイズを指定、1K〜1.5K出力)。 - 出力サイズを固定したい、または4Kが必要な場合 →
gpt-image-2-vip(約90〜150秒、4Kを含む30種類の明示的なサイズ)。 qualityの調整機能や OpenAI API との完全なフィールド互換性が必要な場合 → 公式のgpt-image-2をご利用ください。
一度に複数の画像を生成できますか?
一度に複数の画像を生成できますか?
n パラメータはサポートされていますか?n=3 を渡すとどうなりますか?
n パラメータはサポートされていますか?n=3 を渡すとどうなりますか?
n=3 を渡すと、課金は 0.025 × 3 = $0.075 になりますが、実際に返される画像は1枚のみです。無駄な課金を避けるため、リクエストから n フィールドを必ず削除してください。コンテンツが拒否されたり、モデルが「I can't do that」と返答した場合、課金されますか?
コンテンツが拒否されたり、モデルが「I can't do that」と返答した場合、課金されますか?
- ✅ 事前フィルタリングとユーザーへの警告:フロントエンドまたはゲートウェイでキーワード/シナリオのフィルター(実在の人物名、著作権のあるキャラクター、センシティブなトピック)を追加し、「有名人やIP関連のトピックは失敗する可能性があり、その場合でも上流ポリシーにより課金される場合があります」といったUIヒントを表示します。これにより、無駄な課金を大幅に削減できます。
- ✅ 消費者向けプロダクト向けの月次返金:一般ユーザー向けプロダクトではユーザー入力を完全に制限できないことを理解しています。月間の利用額が十分に大きい場合(月額 $1000 以上)、ログを月単位でまとめて(レイテンシが短い呼び出しは通常ソフトな拒否に該当します)、サポートにお問い合わせいただくことで、一括の手動クレジット付与を受けることができます。呼び出しごとに異議申し立てを行う必要はありません。
b64_json に data:image/png;base64, プレフィックスを追加する必要がありますか?
b64_json に data:image/png;base64, プレフィックスを追加する必要がありますか?
b64_json は data: プレフィックスのない生の base64 です。ファイルに書き込む場合はデコードし、レンダリングする前にご自身でプレフィックスを先頭に追加してください。なお、以前のバージョンにはプレフィックスが含まれていました。コード内に startsWith('data:') のチェックを追加してください。プレフィックスが存在する場合はその値を直接 img src として使用し、存在しない場合は先にデコードするかプレフィックスを追加します。これにより、二重プレフィックスの付与や、プレフィックス付き文字列をデコードして画像が破損することを防げます。プロンプトで 1024x1024 と指定しているのに、異なるサイズになるのはなぜですか?
プロンプトで 1024x1024 と指定しているのに、異なるサイズになるのはなぜですか?
cinematic、phone poster、square composition)と組み合わせてください。特定の解像度に高い信頼性でマッピングされる言い回しについては、このページの前半(「サイズとアスペクト比の制御」内)にある「検証済みのプロンプト表現 → 実際の解像度」テーブルを参照してください。入力画像を圧縮すべきですか?プロンプトに 4K や 8K と記述すると効果はありますか?
入力画像を圧縮すべきですか?プロンプトに 4K や 8K と記述すると効果はありますか?
4K や 8K を詰め込んでも、実際には高解像度の画像は生成されません。それらの単語は単なる装飾であり、モデルがそれによって解像度を上げることはありません。確実により大きな出力を得るには、上記の「検証済みのプロンプト表現 → 実際の解像度」テーブルにある検証済みの言い回し(例:cinematic、phone poster、square composition)を使用してください。厳密なサイズ固定または 4K が必要な場合は、gpt-image-2-vip(4K を含む 30 種類の明示的なサイズ、一律 $0.03/画像)に切り替えてください。参照画像の最大サイズとサポートされている形式は何ですか?
参照画像の最大サイズとサポートされている形式は何ですか?
png / jpg / webp です。過度に大きな画像はゲートウェイの制限に達する可能性があります。複数画像の融合を行う場合、各画像がこの制限を満たす必要があります。返された画像 URL の有効期限はどのくらいですか?ダウンロードする必要がありますか?
返された画像 URL の有効期限はどのくらいですか?ダウンロードする必要がありますか?
url モードのレスポンスの url フィールドは、約1日(24時間)で期限切れになる R2 CDN リンクです。それ以降のリクエストは 404 になります。強く推奨:生成後すぐに、生成された画像をご自身のオブジェクトストレージ(S3 / OSS / R2)、CDN、またはデータベースにダウンロードして永続化してください。返された URL への長期的な直リンクは避けてください。2つの推奨アプローチ:- サーバーサイドプロキシ:レスポンス受信後すぐに
requests.get(url)を行い、ご自身のストレージに保存して、独自の URL をフロントエンドに返します。 b64_jsonの使用:リクエストに"response_format": "b64_json"を追加して base64 画像データを直接取得します。クロスオリジンのダウンロードが1回減るため、フロントエンドでのレンダリングやファイルへの直接書き込みに最適です。
ストリーミングはサポートされていますか?
ストリーミングはサポートされていますか?
公式の OpenAI SDK は使用できますか?
公式の OpenAI SDK は使用できますか?
base_url を https://api.apiyi.com/v1 に向け、api_key を APIYI の token に設定してください。ただし、client.images.generate() はデフォルトで size / n を送信します。このモデルは両方のパラメータを拒否するため、/v1/images/generations および /v1/images/edits に対して requests / fetch を使用して生の HTTP 呼び出しを行うことを推奨します。中国語と英語のプロンプトで大きな違いはありますか?
中国語と英語のプロンプトで大きな違いはありますか?
/v1/chat/completions 経由で画像を生成することは引き続き可能ですか?
/v1/chat/completions 経由で画像を生成することは引き続き可能ですか?
/v1/images/generations および /v1/images/edits を使用してください(より安定しており、公式リレーの gpt-image-2 とも同じコードで動作します)。チャットベースの形式が適しているのは、マルチターンの反復編集、またはオンライン画像 URL を直接渡す場合の2つのシナリオのみです。画像の生成意図が曖昧な場合、モデルは画像の代わりにプレーンテキストを返す可能性がある点にご注意ください(プロンプトの先頭に「画像を生成してください:」のような固定プレフィックスを追加して強調してください)。完全なパラメータについては、チャットベースの API リファレンスを参照してください。関連ドキュメント
- ⚖️ 公式版とリバース版の比較 - 公式
gpt-image-2との並列表の選定ガイド - Text-to-Image Playground -
/v1/images/generations対応エンドポイント - 画像編集 Playground -
/v1/images/editsのマルチ画像融合と編集 - GPT-Image-2-VIP(同価格、
sizeと4K対応) - 同価格の姉妹モデルで、30種類の明示サイズ(4K含む)に対応し、呼び出し形式も同一です - GPT-Image-2 公式版(token課金) -
qualityパラメータ / マスクベースの再描画 / 厳密な OpenAI-API フィールド互換向け - GPT-Image シリーズ概要 - 公式 GPT-Image 比較
- コミュニティ: Luck GPT-Image 2 ComfyUI ノード - ComfyUI で
gpt-image-2-allを直接呼び出せます(デュアルエンドポイント: chat_completions / images_api) - コミュニティ: APIYI GPT-Image 2 スキル - Codex CLI / Cursor / Gemini CLI などの AI コーディングツールから、1文で呼び出せます
- API マニュアル - 一般的な呼び出し規約