

概要
このページでは、APIYIの公式リレーを介したOpenAIのGPT-Image 2.5 / 2シリーズについて説明します。対象は、gpt-image-2.5-flare(速度重視)、gpt-image-2.5-sunburst(品質と編集精度重視)、および旧世代の**gpt-image-2です。2.5モデルは2026-09-08にリリースされ、gpt-image-2より高品質で、より精密な編集に対応し、2つの新しいqualityティア(xhigh / max)を備えています。価格とパラメータはgpt-image-2と完全に同一**です。シリーズ共通の特長は、有効な任意の解像度(2K / 3840×2160 4Kを含む)、参照画像での自動高忠実度処理、token単位の課金です。APIYIのゲートウェイはOpenAI Images APIと完全互換です。公式OpenAI SDKのbase_urlをここに指定するだけで、コード不要で直接接続できます。
xhigh / max品質ティア。正確なサイズや品質の制御が必要な本番シナリオ、OpenAI公式APIとの完全な一致が必要なケース、または4K出力が必要なケースに最適です。デフォルトではテキストから画像への生成にgpt-image-2.5-flare、編集にgpt-image-2.5-sunburstを使用します。テキスト画像生成 API
/v1/images/generations — promptから画像を生成し、サイズ / 品質 / output_formatを制御します。画像編集 API
/v1/images/edits — 参照画像(最大16枚)と編集・融合指示をマルチパートでアップロードし、マスクによるインペインティングに対応します。AIエージェントに統合を任せる
このpromptをコピーして Codex / Claude Code / Cursor に貼り付けてください
まずこのページのプレーンテキスト版を取得し(任意のドキュメントURLに .md を追加)、プロジェクト固有のスタックでコードを記述します。最も頻度の高い4つの落とし穴(タイムアウト、base64レンダリング、アップロード圧縮、品質ティア)はすでに要件に組み込まれています。
このプロジェクトに GPT-Image 2.5 シリーズのテキストからの画像生成および画像編集を統合/トラブルシューティングしてください: テキストからの画像生成には
gpt-image-2.5-flareを、画像編集にはgpt-image-2.5-sunburstを使用し…コードに触れる前にドキュメントを読んでください: このページのプレーンテキスト版を取得するには https://docs.apiyi.com/en/api-capabilities/gpt-image-2/overview.md を取得してください。より詳細なパラメータ情報については、同様に
.mdを…
- タイムアウト: クライアントのタイムアウトを360秒に引き上げてください。画像APIは同期的です — タスクIDは存在しないため、クライアントが切断されると結果は失われ…
計7つの要件があります。以下のボタンを使用して完全なpromptをコピーしてください。
このpromptによって回避できる問題
このpromptによって回避できる問題
なぜAPIYIのGPT-image-2公式リレーを選ぶのか?
OpenAI公式チャネルをベースに構築され、信頼性、コスト、統合体験の観点からエンタープライズの本番ワークロード向けに高度に最適化されています:公式チャネル・公式と同等
同時実行数の制限なし
公式同等価格+最大15%オフ
グローバル対応・障壁ゼロのアクセス
api.apiyi.comへ直接接続可能で、安定したレイテンシを実現し、国境を越えたネットワーク再設計も不要です。充実したモデルラインナップ
gpt-image-2-all(一律$0.025/画像)や、コストパフォーマンスに優れたNano Banana Pro / 2へシームレスに切り替え可能で、シナリオに合わせて自由に組み合わせられます。プロフェッショナルなエンタープライズサポート
モデル選択: flare / sunburst / gpt-image-2
2026-09-08以降、このドキュメントグループでは3つのOpenAI GPT-Image 2.5 / 2モデルを扱います。3つとも価格、パラメータ、グループ、エンドポイントは同じで、切り替えは1フィールドのmodel変更だけです。
主な機能
任意の解像度(4Kを含む)
自動高精細
input_fidelity は渡さないでください(エラーになります)。20-30% 安価
中国語 + テキストレンダリング
high 品質でぼやけることはほとんどありません。マルチ画像融合(最大16枚)
image[] 配列は最大16枚の参照画像を受け付けます。prompt で「image 1 / image 2 / image 3」を使うと、アップロード順で参照できます。マスクインペインティング
複数の出力フォーマット
output_compression を設定してファイルサイズを調整できます。OpenAI SDK 直接接続
base_url を https://api.apiyi.com/v1 に向けて、公式 OpenAI SDK で直接呼び出せます — コード不要で移行できます。料金
APIYIのgpt-image-2.5-flare / gpt-image-2.5-sunburst / gpt-image-2(デフォルトグループ)は、OpenAIの公式料金と完全に一致する1つの料金表を共有しています。割引は代わりにチャージボーナスとして適用されます。$100をチャージすると10%のボーナスを獲得でき、最大20%です。📖 チャージキャンペーンについて。
トークンレート(OpenAI の価格表と同じ)
トークン課金制 — 1 回のリクエスト = 入力テキスト + 入力画像 + 出力画像 token:画像あたりの料金リファレンス(公式表、gpt-image-2)
1Kプリセットサイズにおけるgpt-image-2の一般的な画像あたりの料金(2.5モデルでは同じティア名でも異なる token 数が使用されます。次のセクションを参照してください):
- 単価はOpenAIのリスト価格と同じです。チャージボーナス($100で10%、最大20%)を加算すると、実質コストは直接利用するより低くなります
- 2K / 4Kには画像あたりの固定料金はなく、実際の入力 + 出力 token 数に基づいて課金されます
- 編集リクエストでは、高い忠実度が強制されるため、text-to-imageより入力 token 数が大幅に多くなります
- ストリーミング(
stream: true+partial_images: N)では、部分結果ごとに出力画像 token がさらに100加算されます - 同じサイズと品質の
gpt-image-1.5と比較すると、gpt-image-2は約20~30%安価です
2.5モデルの品質ティアと測定コスト(2026-09-09測定)
同じティア名でも、2.5とgpt-image-2で同じtoken数を意味するわけではありません:2.5では品質の段階が再調整されています。lowは変更されず、2.5のhighはgpt-image-2のmediumに相当し、2.5のmaxはgpt-image-2のhighに相当します。表はusage.output_tokensと、1024×1024のテキストから画像への変換における$30 / 1Mでの出力コストを示しています。同じpromptを使用し、それぞれ1回ずつシリアル実行しています(flareとsunburstではティアごとのtoken数は同一で、異なるのはレイテンシのみです)。
複数の入力画像が価格に与える影響(2026年7月検証済み)
よくあるお客様の質問: 「参照画像ごとに一律料金なのか、それとも大きい画像ほど消費する token が増えるのか?」答えは、どちらも影響し、画像枚数は厳密に線形で加算されます。gpt-image-2 はすべての入力画像を強制的な高忠実度(input_fidelity は調整できません。渡すと 400 が返ります)で処理し、各参照画像はその寸法とアスペクト比に基づいて画像 token に変換されます。実測値(edits エンドポイント、2026-07-15):
- 個数は厳密に線形です: N 枚の参照画像 ≈ N × 1枚分の token。1024² の参照画像 16 枚 ≈ 16384 tokens ≈ $0.13 — これは
highの出力 1 回分($0.211)と同じ桁なので、複数画像の融合ではもはや無視できません。 - サイズには下限と上限の両方があります: 1024² 以下の正方形画像はすべて 1024 tokens として課金されます(512 に縮小しても 何も節約できません)。2048² と 4096² はどちらも 1521 tokens です(大きすぎる画像は変換前に縮小されるため、上限がかかります)。参照画像 1 枚あたりは、アスペクト比込みでおおむね 800〜1600 token の範囲に収まります。
- token 数はファイルサイズではなくピクセル寸法で決まります: 1.5MB まで圧縮するとアップロードの安定性と速度は向上しますが、画像 token は減りません。逆に、50MB のオリジナルをアップロードしても請求額が跳ね上がることはありません(上限が適用されます)。
2K/4K のコスト見積もり(ピクセル比による外挿、⚠️ 公式の固定価格ではありません)
OpenAI は 1K サイズについてのみ、画像ごとの固定価格表を公開しています — 2K/4K のサイズ別価格については公式のものがありません。以下の表は、予算見積もり目的のみで、上の 1K の公式レートを基準にピクセル数でスケーリングした、APIYI 独自の外挿です。SaaS サブスクリプション / クレジットベース課金との違い
画像生成ツールのベンダーは、通常 2 つの方式のどちらかで課金します。- 月額サブスクリプションプラン: 「月間 N 枚」のクォータに対して定額の月額料金を支払う方式です。このクォータは 過剰販売前提 を織り込んだ価格設定になっており、ベンダーは大半のユーザーが付与上限を使い切らないことを前提にしています。そのため、広告される「1 枚あたりのコスト」は、単にプラン料金をクォータ上限で割ったものにすぎず、実際に各画像を生成するのにあなたにとって本当にいくらかかるかを示すものではありません。
- クレジット / ポイントベースの計測: 品質やサイズの異なるジョブを、正体の分かりにくい「クレジット」に変換します。これは実態としては従量課金であり、実際の token 消費を隠すクレジット単位の背後に再パッケージされているだけです。
各呼び出しの実際の token 数を確認する方法
/v1/images/generationsと/v1/images/editsはいずれもusageフィールドを返し、画像入力 token とテキスト入力 token は別々のフィールドとして返されます。推定は不要で、各呼び出しの正確なコストを確認するには、それらを読み取るだけです。以下は、1枚の参照画像を使用した実際の編集リクエストから取得した完全なusageオブジェクトです(実行時に取得):
グループ設定
3つの GPT-Image 2.5 / 2 モデルは、同じ公式リレーのグループを共有します。ダッシュボードで Token Settings → グループ に切り替えます。image2Enterprise に切り替えてピークを乗り切ってください。
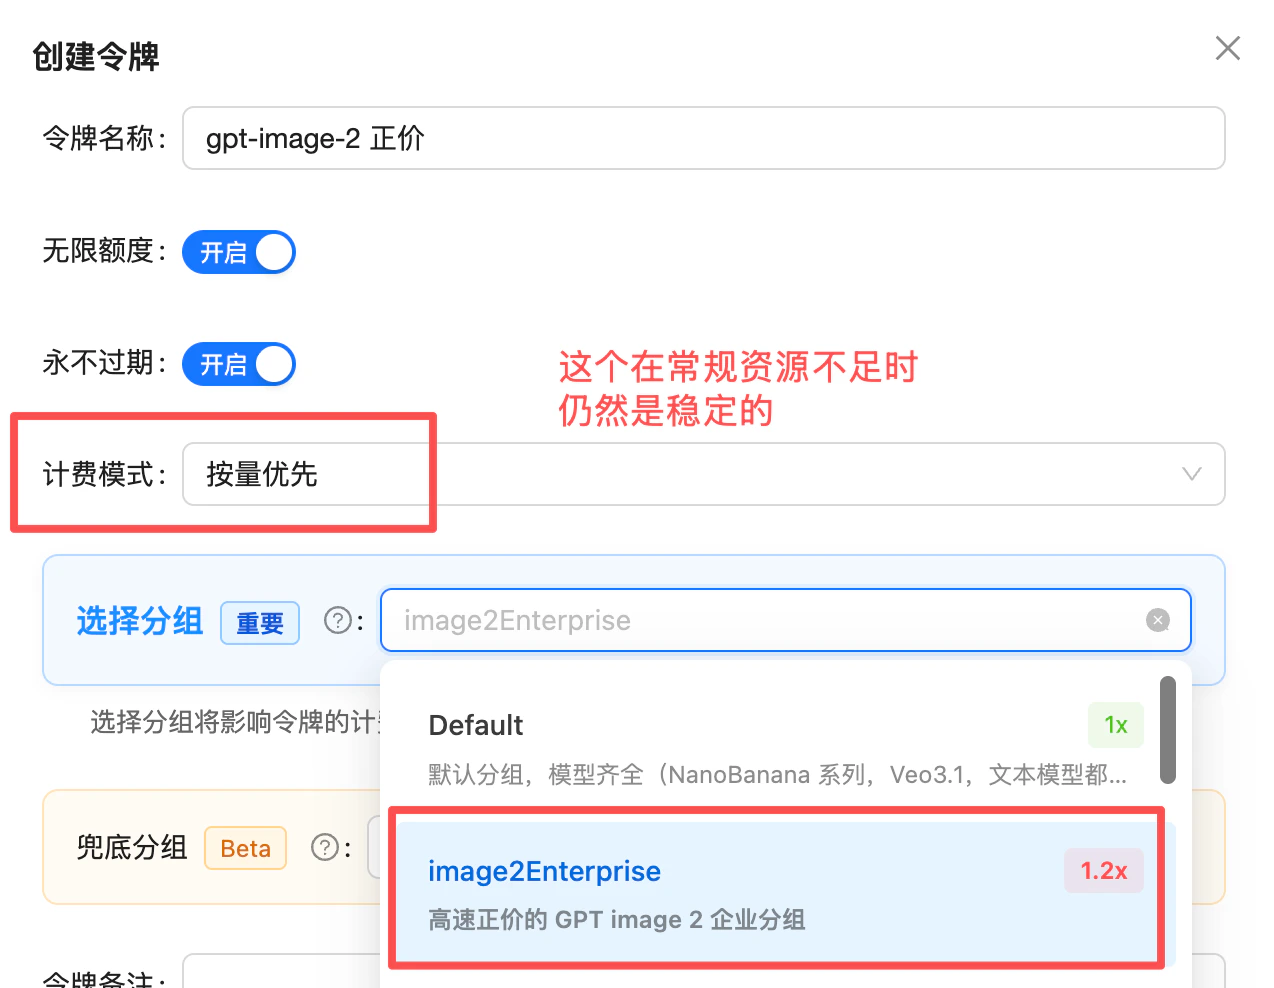
Token settings: pick the image2Enterprise group (1.2x) — stable when default capacity is tight
技術仕様
エンドポイント
サイズ参照
プリセットサイズ
カスタムサイズの制約
gpt-image-2 は、以下をすべて満たす 任意の有効なサイズ を受け付けます:
- 最大辺 ≤ 3840px
- 両方の辺が 16 の倍数
- アスペクト比 ≤ 3:1
- 総ピクセル数 ∈ [655,360, 8,294,400](約0.65MP~約8.3MP)
1600x1200, 1792x1024, 2048x1536, 3200x1800
無効な例: 1000x1000(16 の倍数ではない), 4000x4000(最大値を超過), 3840x1000(比率 > 3:1)
品質リファレンス
利用可能なティア
quality であり、size よりも大きな影響があります。 出力画像の token 数は quality × size によって決まりますが、quality の影響ははるかに大きくなります。同じサイズの場合、low から high に変更すると、画像 1 枚あたりのコストが 30 倍以上 変わる可能性があります(上記の「画像 1 枚あたりのコスト」表を参照してください。1024×1024 の gpt-image-2 は low $0.006 から high $0.211 の範囲で、2.5 のモデルは low $0.006 から max $0.211 の範囲です)。まず quality に基づいてコストを見積もり、その後 size の影響を加味してください。ベストプラクティス
まずは low で連携する
quality=low + プリセットサイズから始めてください。low は high よりも数倍高速なため、長いレイテンシに埋もれることなく、機能的な問題を迅速に洗い出すことができます。プリセットサイズを優先する
シナリオに応じて品質を使い分ける
low、日常用途/最終成果物 → medium、テキスト、繊細なテクスチャ、印刷 → high。low ↔ high の違いは視覚的な忠実度にとどまらず、推論の複雑度も段階的に大きく変化する点に注意してください。そのため、レイテンシもそれに応じて増加します。JPEG出力を選択する
output_format=jpeg + output_compression=85 がPNGよりも高速で、サイズもおよそ半分になります。テキストを含むシナリオでは high に固定する
quality=high に固定してください。参照画像を適切に準備する
透明背景:パラメータを指定し、プロンプトにシーンの描写を含めない
gpt-image-2.5-flare / gpt-image-2.5-sunburst のみです(gpt-image-2 は2026-09-30以降、OpenAIによって400エラーで拒否されます)。background: "transparent" を png / webp とともに指定しても、アルファチャンネルが保証されるだけです。プロンプトや参照画像で全体的なシーン(森、部屋、街並みなど)が描写されている場合、モデルはそのシーンを描画してしまい、パラメータでそれを止めることはできません——これが透明度が「時々しか機能しない」主な原因であり、quality とは無関係です(2026-09-11の測定値:被写体のみのプロンプトでは16/16が透明化、シーンを含むプロンプトではmediumとhighのいずれも0/3)。プロンプトの末尾に isolated subject on a transparent background, no scenery, no ground を追加してください。参照画像に背景がある場合は、編集プロンプトで remove the background entirely, keep only the subject と指示します。詳細は透明背景に関するFAQを参照してください。クライアントのタイムアウトを段階的に設定する(high → セーフティネットとして600秒)
quality と size であり、特に quality が影響します。ティアごとにクライアントのタイムアウトを設定してください。high モードでは、キュー待ち、ロングテールのばらつき、アップストリームのジッターを吸収するために、セーフティネットとして600秒のタイムアウトを設定してください。UI上で進捗状況を表示し、サーバー側ではタスクキューの導入を検討してください。移行に関する注意事項
gpt-image-1.5 からの移行:input_fidelity を削除してください(強制的に高忠実度となるため、渡すとエラーになります)。透明背景を利用する場合は2つの2.5モデルのいずれかに移行してください(gpt-image-2 は2026-09-30以降、background: transparent を受け付けなくなりました)。従来のDALL·E 2/3コードからの移行:response_format を削除してください(GPT Imageモデルは400 Unknown parameter: 'response_format' で拒否します。出力は常に b64_json となります)。エラーとリトライ
qualityに応じてリクエストのタイムアウトを段階的に設定してください:low≥ 120秒 /medium≥ 240秒 /high≥ 600秒(セーフティネット — 実際には3〜5分が確認されています。120秒/360秒前後に設定すると誤ったタイムアウトが多数発生します)- まずは
quality=lowと統合し、実際の品質ニーズに応じてmedium/highへとステップアップしてください - 5xx エラーおよびタイムアウトにはエクスポネンシャルバックオフを適用してください(2回のリトライを推奨します)
- サポート用に
x-request-idヘッダーをログに記録してください
FAQ
400 Unknown parameter: 'response_format' のエラーはどのように修正すればよいですか?
400 Unknown parameter: 'response_format' のエラーはどのように修正すればよいですか?
response_format パラメータを削除してください。これが現在最もよくある 400 エラーです。 gpt-image-2(および GPT Image シリーズ全体)は response_format を受け付けません。出力フォーマットは b64_json に固定されており、変更できません。渡すと次のエラーが返されます:url / b64_json を提供していた)であり、多くの古いサンプルコードや一部のサードパーティライブラリではデフォルトで含まれたままになっています。gpt-image-2 に移行する際は、このフィールドを削除し、data[0].b64_json を直接読み取ってください(生の base64 です。デコードして画像ファイルを取得します)。このエラーは入力検証ステージで返されるため、課金は発生しません。ワークフローで base64 ではなく画像 URL がどうしても必要な場合:- 公式の
gpt-image-2には URL 出力がありません。base64 をデコードしてご自身のオブジェクトストレージにアップロードしてください - または、リバースエンジニアリング版の
gpt-image-2-allに切り替えてください。こちらはresponse_format: "url"に対応しており、24時間有効な CDN リンクを返します
b64_json に data:image/png;base64, プレフィックスを追加する必要がありますか?
b64_json に data:image/png;base64, プレフィックスを追加する必要がありますか?
gpt-image-2 は gpt-image-2-all とは異なり、プレフィックスのない生の base64 文字列を返します。クライアントの実装パターンは2つあります:- ファイル書き出し:
base64.b64decode(b64_str)→ ディスクに書き出し - ブラウザでのレンダリング:
img.src = 'data:image/png;base64,' + b64_str(手動でプレフィックスを付与)
input_fidelity を渡すと 400 が返されるのはなぜですか?
input_fidelity を渡すと 400 が返されるのはなぜですか?
gpt-image-2 は参照画像の高忠実度処理を強制しており、input_fidelity は受け付けなくなりました。1.5 から移行する場合は、このフィールドを削除するだけでよく、代替パラメータは不要です。透明な背景が必要な場合はどうすればよいですか?
透明な背景が必要な場合はどうすればよいですか?
gpt-image-2.5-flare または gpt-image-2.5-sunburst を使用し、background: "transparent" を指定して output_format を png または webp に設定してください。返される画像は本物のアルファチャンネル画像であり、切り抜きの後処理は不要です。テキストからの画像生成と画像編集の両方でサポートされています。gpt-image-2 はサポートしていません。OpenAI は 2026-09-30 にその透明背景機能を停止しており、現在は 400 を返します。モデル名を変更し、他のパラメータはそのまま維持してください。2つの制限事項があります。jpeg はアルファチャンネルを持たず、透過処理と排他関係にあります(400 が返されます)。また、編集エンドポイントにおける透明化は元の輪郭を正確にトレースするものではなく再描画であるため、被写体のディテールが変化する可能性があります。ピクセル単位で正確な抽出が必要な場合は、ご自身で rembg / PIL / sharp を実行してください。見落とされがちな3つ目の制限事項として、プロンプトや参照画像で背景シーンが描写されている場合、モデルはそのシーンを描画してしまいます。パラメータでそれをオーバーライドすることはできず、quality を上げても解決しません。被写体のみを描写し、末尾を isolated subject on a transparent background, no scenery, no ground で終えるようにしてください。詳細およびモデルごとの対応状況については、透明な背景の画像を生成する方法 をご覧ください。1回の呼び出しで何枚の画像を生成できますか?
1回の呼び出しで何枚の画像を生成できますか?
n=1)。N 枚の画像が必要な場合は、N 個の並列リクエストを発行してください。それぞれ個別に token 課金されます。なぜ 2K/4K はこれほど遅いのですか?
なぜ 2K/4K はこれほど遅いのですか?
quality=high + 高解像度では1枚あたり約235秒(約4分)かかることを確認しており、3840×2160 + high のロングテールでは5分近くまで延びることがあります。推奨事項:- まず
quality=lowでインテグレーションして呼び出しチェーンを検証し、実際の品質ニーズに応じて上位モデルへ移行する - クライアントのタイムアウトを品質ごとに階層化する:
low≥ 120秒 /medium≥ 240秒 /high≥ 600秒(セーフティネット) - UI に「生成中」の進捗状況を表示する
- 4K が不要な場合は、1024×1024 / 1536×1024 の 1K プリセットを使用する
キャッシュされた入力の料金体系の恩恵を実際に受けられますか?
キャッシュされた入力の料金体系の恩恵を実際に受けられますか?
画像編集リクエストがテキストからの画像生成よりも高価なのはなぜですか?
画像編集リクエストがテキストからの画像生成よりも高価なのはなぜですか?
gpt-image-2 は参照画像の高忠実度処理を自動的に有効化するため、参照画像自体が Vision の価格設定ルールによって大量の入力 token 数に変換されるからです。画像編集の入力 token はテキストからの画像生成よりも大幅に高くなりますので、それを考慮して予算を組んでください。同じサイズと参照画像なのに、呼び出しごとにコストが異なるのはなぜですか?
同じサイズと参照画像なのに、呼び出しごとにコストが異なるのはなぜですか?
quality が auto に設定されていた(または省略されていた)ことです。 お客様から「サイズ、解像度、参照画像がまったく同じなのに、価格が上下に変動する」という報告を受けたことがあります。調査したところ、size と quality の両方が auto に設定されていました。原因は quality: auto です。auto モードでは、モデルがリクエストを解釈し、生成ごとに動的に異なる品質ティアを選択します。ティアが異なれば出力画像 token 数も異なり、結果として価格が変わります。以下は、**同一の入力(それぞれ 1061 入力 tokens)**でありながら、コストが数倍異なった実際の3つの課金エントリです:auto がより高い品質ティアに解決され、出力 tokens が 5146 に跳ね上がり、価格は約3.5倍に上昇しました。解決策:quality を auto のままにせず、low / medium / high を明示的に渡してください。 ティアを固定すれば、同一の入力に対する出力 token 数と価格が安定し、予測可能になります。上記の「品質リファレンス」セクションを参照してください。編集エンドポイントの画像枚数とサイズの制限は何ですか?
編集エンドポイントの画像枚数とサイズの制限は何ですか?
gpt-image-2 画像編集エンドポイント(/v1/images/edits)は、最大 16 枚の参照画像をサポートしています:- multipart/form-data によるファイルアップロード: 各画像は 50MB 未満、フォーマットは
png/jpg/webp - base64 データ URL: フィールド長の制限は約 20MiB(スキーマ
maxLength: 20971520— 文字列フィールドの制限であり、50MB の multipart 上限とは異なります)であるため、元の画像は 15MB 以内に抑えてください - マスクファイル: 個別に 4MB 未満の PNG に制限されています
編集エンドポイントが 400 'Invalid image file or mode for image 1' を返します。どうすればよいですか?
編集エンドポイントが 400 'Invalid image file or mode for image 1' を返します。どうすればよいですか?
code: invalid_image_file)は、N 番目の参照画像が標準的な png / jpg / webp ファイルではないことを意味します(1 から始まるインデックスです。このインデックスを使って問題のある画像を特定してください)。最も一般的な根本原因は、スマートフォンのカメラによる MPO フォーマットです。Huawei Mate シリーズのスマートフォンから直接出力された .jpg ファイルには HDR ゲインマップサブフレームが埋め込まれており、実際にはマルチフレーム JPEG コンテナ(MPO)となっています。ヘッダーは同じ FFD8 であり、拡張子も file コマンドも JPEG と報告するため、目視で見分けることは不可能です。2026年7月の検証では、MPO ファイルは常に拒否され、標準の JPEG/PNG として再エンコードされた同じ画像は元の完全な解像度で成功しました(寸法、image[] フィールド名、または quality/size パラメータとは無関係です)。このエラーは入力検証ステージで返されるため、課金は発生しません。解決策:アップロード前に Pillow で再エンコードしてください(Image.open(f).format が "MPO" を返す場合は変換が必要です):マスクファイルはどのように準備すればよいですか?
マスクファイルはどのように準備すればよいですか?
- 元の画像と同じサイズ、PNG フォーマット、4MB 未満
- アルファチャンネルが必須:透明(alpha=0)= インペイント領域、不透明 = 保持
- 最初の画像にのみ適用されます
- マスクは「緩やかなガイド」であり、モデルがマスク領域の周囲を拡大または縮小する場合があります
gpt-image-2 と gpt-image-2-all のどちらを選ぶべきですか?
gpt-image-2 と gpt-image-2-all のどちらを選ぶべきですか?
公式の OpenAI SDK を直接使用できますか?
公式の OpenAI SDK を直接使用できますか?
base_url を https://api.apiyi.com/v1 に向け、api_key を APIYI の token に設定してください:進行中の生成をキャンセルすることはできますか?
進行中の生成をキャンセルすることはできますか?
gpt-image-2 は OpenAI の公式同期エンドポイントを使用しているため、リクエストが送信されると「キャンセル」シグナルなしで完了まで実行されます。クライアントが切断された場合でも、サーバーは生成を完了し、通常どおり課金されます。「切断 = 課金なし」と思い込まず、クライアント側のタイムアウトを慎重に設定してください。レート制限(RPM)はありますか?
レート制限(RPM)はありますか?
非同期呼び出しはサポートされていますか?
非同期呼び出しはサポートされていますか?
gpt-image-2 は OpenAI 公式 API を厳密にミラーリングしており、同期呼び出しのみです。リクエストは結果が返されるまでブロックされます(high + 4K では現実的に1〜2分かかります)。非同期キューやコールバックメカニズムが必要な場合:- ビジネス層のタスクキュー(Celery / BullMQ など)でご自身でラップしてください
- または
gpt-image-2-allをご使用ください — 30〜60秒で生成され、フロントエンドからのポーリングが容易です
プロンプトの長さに制限はありますか?なぜ ChatGPT Web アプリではもっと長く貼り付けられるのですか?
プロンプトの長さに制限はありますか?なぜ ChatGPT Web アプリではもっと長く貼り付けられるのですか?
gpt-image-2 および両方の 2.5 モデルで同一)。APIYI の公式リレーでもこの制限を厳しくすることはありません。これを超えると、プロバイダはエラーを返しません。プロンプト全体を警告なく無視して無関係な画像(多くの場合、リアルなポートレートやインテリア)を生成し、usage.input_tokens_details.text_tokens は1桁のカウント(テストでは 8)を報告します。ドキュメントには 32,000 文字と記載されています。32,000 英字は約 8K tokens であり、この2つはおおむね一致しますが、中国語は密度が高いため約 11,000 文字で上限に達します。生成された画像がプロンプトとまったく関係がない場合は、まずその呼び出しの text_tokens を確認してください。Web アプリが無制限に見えるのは、チャットモデルが貼り付けられた内容を読み取った後、画像ツール用に独自の短いプロンプトを作成するためであり、画像モデル自体はその元データを見ていないからです。ブランドブックやパッケージ仕様などの長い資料の場合は、まずテキストモデルを使用して 1,000〜3,000 文字の構造化プロンプトに要約してください。長いプロンプト を参照してください。露骨な表現ではないプロンプトで safety_violations=[sexual] の 400 が発生します。どうすればよいですか?
露骨な表現ではないプロンプトで safety_violations=[sexual] の 400 が発生します。どうすればよいですか?
moderation: low はプロンプト側のモデレーションを緩和するだけであり、ここでは効果がありません。最も一般的な原因は、キャラクターが雰囲気だけで描写され、服装が描写されていないため、モデルがアドリブで制限を超えてしまうことです。まずは明確な服装のフレーズを1つ追加し(他の部分は一切変更しないでください)、その後で1単語ずつ消去法で調整してください。完全な事例と20回の呼び出しログについては、セーフティによる拒絶 をご覧ください。生成に失敗した場合も課金されますか?
生成に失敗した場合も課金されますか?
400 エラーを返した場合、料金は発生しません。一般的なレスポンス:401(無効な token)、429(レート制限)。token 課金は、リクエストが実際にモデルの生成ステージに到達した(すなわち 200 + b64_json を受信した)場合にのみ適用されます。関連ドキュメント
- ⚖️ 公式 vs リバース比較 - 比較選定ガイド
- Text-to-Image プレイグラウンド -
/v1/images/generationsインタラクティブテスト - 画像編集プレイグラウンド -
/v1/images/edits複数画像の融合 + マスク - ディープダイブ:GPT-image-2.5 リリース、Flare はより高速に、Sunburst はより鮮明に - ニュース記事
- ディープダイブ:gpt-image-2 リリース - ニュース記事
- 完全統合ドキュメント - 完全な API リファレンス
- GPT-Image-2-All(リバースエンジニアリング版) - より安価で高速な代替手段
- コミュニティ:Luck GPT-Image 2 ComfyUI ノード - ComfyUI から
gpt-image-2/gpt-image-2.5-flare/gpt-image-2.5-sunburstを直接呼び出し(マスク / 16枚の参照画像 / 6段階の品質ティア / カスタムサイズ) - コミュニティ:APIYI GPT-Image 2 Skills - Codex CLI / Cursor / Gemini CLI などの AI コーディングツールから1文で呼び出し
- API マニュアル - 一般的な利用ガイド
gpt-image-2.5-flare / gpt-image-2.5-sunburst / gpt-image-2 は OpenAI の公式モデルであり、token 単位で課金されます。定額料金(1画像あたり $0.025)とより高速な生成(30〜60秒)を優先する場合は、gpt-image-2-all を参照してください。