

개요
gpt-image-2.5-all 및 gpt-image-2-all은 APIYI의 GPT 이미지 생성 역공학 모델(ChatGPT 웹 라인)입니다. ChatGPT 웹 앱이 전면적으로 Images 2.5로 전환되었으므로gpt-image-2-all은(는) 이미 2.5 이미지를 생성합니다. 새로운 gpt-image-2.5-all 명칭은 해당 업그레이드를 명확히 나타낸 것뿐이며, 두 명칭은 동일한 가격과 동작을 공유하므로 상호 교환이 가능합니다. 신규 프로젝트에는 gpt-image-2.5-all을(를) 사용하는 것이 좋습니다. 호출당 $0.025/이미지라는 매우 경쟁력 있는 가격(2026-10-10에 $0.03에서 인하됨)으로 약 30~60초 만에 이미지를 생성하며, 텍스트-투-이미지 / 단일 이미지 편집 / 다중 이미지 융합 / 자연어 편집을 지원합니다. 또한 텍스트 렌더링 충실도가 높고 중국어 prompt를 기본적으로 지원합니다.
/v1/images/generations(텍스트-투-이미지) 및 /v1/images/edits(이미지 편집)을(를) 사용합니다.출력 크기를 고정하거나 4K가 필요하신가요? 자매 모델인 gpt-image-2-vip(으)로 전환해 보십시오. 호출 형식은 동일하며 size 필드 하나만 추가하면 됩니다.텍스트-투-이미지 API
/v1/images/generations — 텍스트 prompt로부터 이미지를 생성합니다.이미지 편집 API
/v1/images/edits — 편집/융합 지침이 포함된 multipart 업로드입니다.AI 에이전트로 연동 작업 수행하기
이 prompt를 복사하여 Codex / Claude Code / Cursor에 붙여넣으십시오
먼저 이 페이지의 일반 텍스트 버전을 가져온 후(문서 URL 뒤에 .md 추가), 프로젝트의 자체 기술 스택에 맞춰 코드를 작성합니다. 타임아웃, base64 렌더링, 업로드 압축 및 이 모델에서 거부되는 매개변수 처리가 이미 요구사항에 반영되어 있습니다.
이 프로젝트에서 gpt-image-2-all의 텍스트-이미지 생성 및 이미지 편집 기능을 연동/트러블슈팅하십시오.
코드를 수정하기 전에 문서를 읽으십시오: 이 페이지의 일반 텍스트 버전을 확인하려면 https://docs.apiyi.com/en/api-capabilities/gpt-image-2-all/overview.md 를 가져오십시오. 더 자세한 매개변수 세부사항은 …에
.md을 추가하십시오.
- 타임아웃: 클라이언트 타임아웃을 360초로 늘리십시오. 이미지 API는 동기식으로 작동하므로 작업 ID가 없으며, 클라이언트 연결이 끊어지면 결과가 유실됩니다 …
총 6개의 요구사항이 있습니다. 아래 버튼을 사용하여 전체 prompt를 복사하십시오.
이 prompt를 통해 방지할 수 있는 문제들
이 prompt를 통해 방지할 수 있는 문제들
핵심 기능
높은 가격 경쟁력
고품질 텍스트 렌더링
중국어 prompt 친화적
다중 이미지 융합
더 빠른 출력
gpt-image-2-vip 및 공식 릴레이 gpt-image-2보다 더 빠릅니다R2 CDN 가속
response_format: "url"을(를) 명시적으로 전달합니다자연어 편집
표준 엔드포인트 지원
/images/generations 및 /images/edits와 호환됩니다요금 안내
- 단일 요금제 적용: 해상도, 화질, prompt 길이에 따른 차등 없음
- 실패한 요청은 과금되지 않습니다 (인증 실패, 매개변수 유효성 검사 오류)
- N장의 이미지가 필요한 경우, API를 N회 병렬로 호출하십시오
그룹 설정
gpt-image-2-all은(는) Default 그룹에 위치하며 — 추가 그룹이 필요하지 않습니다. 역방향 채널은 현재 공급이 안정적이므로, 공식 릴레이 gpt-image-2과 같은 엔터프라이즈 그룹 폴백 시나리오가 없습니다.
결정론적 URL 출력이 필요한 경우 → image2_OSS 그룹으로 전환
기본 그룹에서 2026년 7월에 측정한 결과에 따르면, gpt-image-2-all(및 gpt-image-2-vip)은 response_format을(를) 생략했을 때 b64_json을(를) 반환합니다. 이미지 URL을 받으려면 response_format: "url"을(를) 명시적으로 전달하십시오. 기본 그룹의 출력 형식은 보장되지 않습니다 — 과거에는 기본값이 url이었으며 부하 발생 시 b64_json(으)로 폴백되었고, 채널 버전에 따라 변경되어 왔습니다.
비즈니스가 URL 출력에 의존하는 경우(데이터베이스에 URL 직접 저장, URL을 통한 프론트엔드 렌더링, base64 사용 불가 등), token의 그룹을 image2_OSS(으)로 전환하십시오. 이는 결정론적 URL 출력을 위해 특수 제작된 그룹으로, **1배 요율 배수(추가 요금 없음)**가 적용되며 두 역방향 모델 gpt-image-2-all 및 gpt-image-2-vip 모두에 유효합니다. 응답에 항상 이미지 URL이 포함되도록 보장하며 base64로 절대 폴백되지 않습니다.
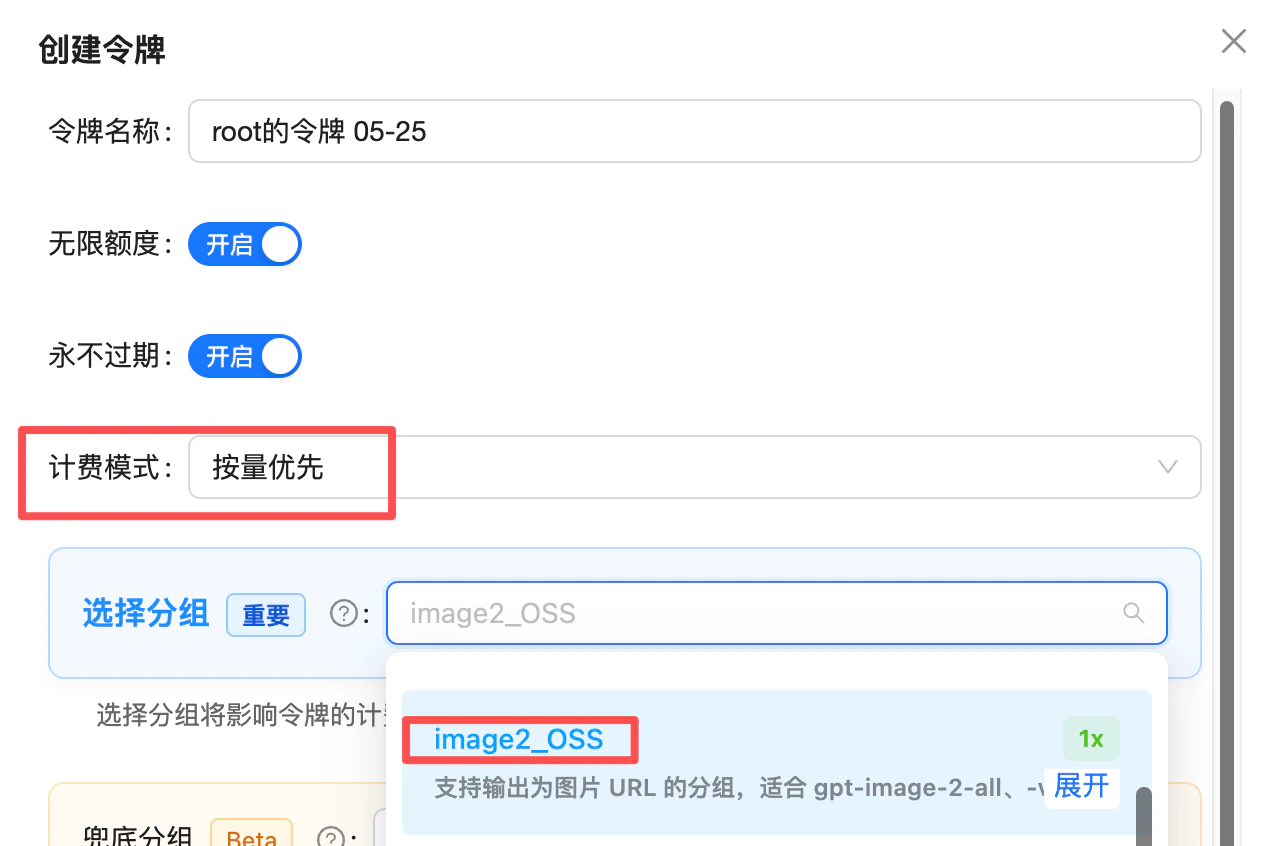
Token creation: set billing mode to "pay-as-you-go first" and pick the image2_OSS group (1x) — use it when you need deterministic URL output
image2Enterprise 그룹 관련 안내: /en/live/2026-04/image2-enterprise-stable
기술 사양
엔드포인트
size 파라미터로 출력 크기를 고정하고 싶으신가요? 자매 모델인 gpt-image-2-vip를 사용하십시오. 엔드포인트는 동일하며, size 필드 하나만 추가됩니다(4K를 포함한 30가지 명시적 크기 제공).크기 및 종횡비 제어(프롬프트에서 설명)
gpt-image-2-all에는 size 파라미터가 없습니다. 즉, 크기는 프롬프트에 설명합니다. 출력 크기를 엄격하게 고정해야 하는 경우(이커머스 히어로 이미지, 포스터 템플릿, 4K 배경화면 등)에는 대신 gpt-image-2-vip을 사용하십시오.
검증된 “프롬프트 표현 → 실제 해상도” 표
아래 8개의 표현은 실험적으로 안정적으로 재현됨이 검증되었습니다. 첫 번째 열의 표현을 프롬프트의 앞부분에 넣으면 두 번째 열에 표시된 해상도를 얻을 수 있습니다(모든 출력은 약 1.5K 픽셀 티어에 속합니다).- 모든 출력은 약 1.5K 픽셀 티어(긴 변이 1500~2000px)입니다. 이는 모델의 실효 상한이며, 진정한 의미의 “임의 해상도”는 아닙니다.
- 프롬프트에 표의 표현만 단독으로 포함될 때 재현성이 가장 높습니다. 다른 구성 관련 단어를 섞으면 결과가 흔들릴 수 있습니다.
- 중국어 문자열은 실제로 전송하는 값이므로, 번역하지 말고 그대로 유지하는 것을 권장합니다.
스타일 표현(고정 해상도 없음)
아래 표현에는 검증된 해상도가 없습니다. 위 표와 함께 스타일 수정어로만 사용하십시오.이 표를 최종 사용자에게 노출하기
gpt-image-2-all에는 size 파라미터가 없지만, 사용자에게 여전히 “크기 / 종횡비” 드롭다운을 제공할 수 있으며, 이는 마치 공식 size 필드처럼 느껴지게 만들 수 있습니다.
- 위 표의 프롬프트 표현을 옵션
value로 사용하십시오(예:横版 16:9) - 옵션 레이블에 예상 해상도를 표시하여(예:
Landscape 16:9 (1672×941)) 사용자가 어떤 결과를 얻게 될지 알 수 있게 하십시오 - 백엔드에서는 선택한 표현을 사용자의 원래 프롬프트 앞에 붙인 뒤 API로 전송하십시오
모범 사례
입력 이미지를 1.5MB 미만으로 압축합니다(이미지 편집 / 다중 이미지 융합)
4K / 8K을 프롬프트에 넣어도 고해상도 이미지는 만들어지지 않습니다. 더 큰 출력을 안정적으로 얻으려면 위의 “검증된 프롬프트 표현 → 실제 해상도” 표에 있는 검증된 표현을 사용합니다.크기를 프롬프트 앞에 배치합니다
텍스트 요소를 자신 있게 사용합니다
다중 이미지 순서를 표기합니다
image 필드를 반복하는 순서는 의미가 있습니다. 프롬프트에서 이를 “image1/image2/image3”로 명시적으로 참조합니다.필요에 따라 응답 형식을 선택합니다
b64_json을 사용하고; 서버 측 저장/전달에는 url를 사용합니다.300초 타임아웃을 사용합니다
거부되는 매개변수를 제거합니다
gpt-image-2-all는 size, n, quality, aspect_ratio를 거부합니다 — 이를 보내면 검증 오류가 발생할 수 있습니다. size를 통과하려면 gpt-image-2-vip로 전환합니다.오류 코드 및 재시도
- 요청 타임아웃은 300초부터 시작합니다(보수적 설정입니다. 일반적으로는 30–60초이지만, 이미지 업로드/다운로드와 리버스 채널 피크 꼬리 구간 때문에 편차가 큽니다 — 120초는 잘못된 타임아웃이 자주 발생합니다)
- 5xx와 타임아웃에는 지수 백오프를 사용합니다(2–3회 재시도 권장)
- 디버깅을 위해
request-id응답 헤더를 기록합니다
FAQ
gpt-image-2-all과 gpt-image-2-vip가 모두 보이는데, 어떤 것을 선택해야 합니까?
gpt-image-2-all과 gpt-image-2-vip가 모두 보이는데, 어떤 것을 선택해야 합니까?
size 지원 여부, 생성 시간 및 안정성입니다:- 엄격한 크기 제어가 필요 없고 더 빠르고 안정적인 출력을 원하는 경우 →
gpt-image-2-all(~30–60초, prompt에 크기 서술, 1K–1.5K 출력). - 출력 크기 고정 또는 4K가 필요한 경우 →
gpt-image-2-vip(~90–150초, 4K를 포함한 30가지 명시적 크기 제공). quality조절 기능이나 완벽한 OpenAI API 필드 호환성이 필요한 경우 → 공식gpt-image-2을 사용하십시오.
한 번에 여러 장의 이미지를 생성할 수 있습니까?
한 번에 여러 장의 이미지를 생성할 수 있습니까?
n 매개변수를 지원합니까? n=3을 전달하면 어떻게 됩니까?
n 매개변수를 지원합니까? n=3을 전달하면 어떻게 됩니까?
n=3을 전달하면 과금은 0.025 × 3 = $0.075가 되지만, 실제로는 1장의 이미지만 반환됩니다. 불필요한 과금을 방지하기 위해 요청에서 n 필드를 반드시 제거하십시오.콘텐츠가 거부되거나 모델이 '그렇게 할 수 없습니다'라고 응답하면 과금됩니까?
콘텐츠가 거부되거나 모델이 '그렇게 할 수 없습니다'라고 응답하면 과금됩니까?
- ✅ 사전 필터링 및 사용자 경고: 프론트엔드 또는 게이트웨이에서 키워드/시나리오 필터(실존 인물 이름, 저작권 캐릭터, 민감한 주제)를 추가하고, “유명인/IP 주제는 실패할 수 있으며 업스트림 정책에 따라 과금될 수 있습니다.”와 같은 UI 안내 문구를 표시하십시오. 이를 통해 불필요한 과금을 크게 줄일 수 있습니다.
- ✅ B2C 제품을 위한 월간 환급: 일반 사용자 대상 제품의 경우 사용자 입력을 완전히 차단하기 어렵다는 점을 잘 이해하고 있습니다. 월 사용 금액이 충분히 큰 경우(월 $1000 이상), 로그를 월 단위로 취합하여(지연 시간이 짧은 호출은 대개 소프트 거절에 해당함) 고객 지원팀에 일괄 수동 크레딧을 요청하실 수 있습니다. 호출 건마다 개별 이의를 제기할 필요가 없습니다.
b64_json에 data:image/png;base64, 접두사를 추가해야 합니까?
b64_json에 data:image/png;base64, 접두사를 추가해야 합니까?
b64_json은 data: 접두사가 없는 순수 base64입니다. 파일로 저장하려면 디코딩하고, 렌더링하려면 직접 접두사를 앞에 붙이십시오. 초기 버전에는 접두사가 포함되어 있었습니다. 코드에 startsWith('data:') 검사를 추가하십시오. 접두사가 존재하면 해당 값을 img src로 직접 사용하고, 없으면 디코딩하거나 접두사를 먼저 추가하십시오. 이렇게 하면 접두사가 중복되거나 접두사가 포함된 문자열을 디코딩하여 이미지가 손상되는 문제를 방지할 수 있습니다.prompt에 1024x1024라고 명시했는데 왜 다른 크기로 생성됩니까?
prompt에 1024x1024라고 명시했는데 왜 다른 크기로 생성됩니까?
cinematic, phone poster, square composition)와 조합하십시오.특정 해상도로 안정적으로 매핑되는 표현은 이 페이지 상단의 “검증된 prompt 문구 → 실제 해상도” 표(“크기 및 종횡비 제어” 항목)를 참조하십시오.입력 이미지를 압축해야 합니까? prompt에 4K / 8K를 작성하면 도움이 됩니까?
입력 이미지를 압축해야 합니까? prompt에 4K / 8K를 작성하면 도움이 됩니까?
4K / 8K을 채워 넣는다고 해서 실제로 고해상도 이미지가 생성되는 것은 아닙니다. 이러한 단어는 수식어일 뿐이며, 모델이 이를 이유로 해상도를 높이지 않습니다. 신뢰할 수 있는 대형 출력을 얻으려면 위의 “검증된 prompt 문구 → 실제 해상도” 표에 있는 검증된 표현(예: cinematic, phone poster, square composition)을 사용하십시오. 엄격한 크기 고정 또는 4K가 필요한 경우 gpt-image-2-vip(4K 포함 30가지 명시적 크기, 이미지당 일괄 $0.03)로 전환하십시오.참조 이미지의 최대 크기와 지원 형식은 무엇입니까?
참조 이미지의 최대 크기와 지원 형식은 무엇입니까?
png / jpg / webp입니다. 너무 큰 이미지는 게이트웨이 제한에 걸릴 수 있습니다. 다중 이미지 결합 시 각 이미지도 이 제한을 충족해야 합니다.반환된 이미지 URL의 유효 기간은 얼마나 됩니까? 이미지를 직접 다운로드해야 합니까?
반환된 이미지 URL의 유효 기간은 얼마나 됩니까? 이미지를 직접 다운로드해야 합니까?
url 모드 응답의 url 필드는 약 1일(24시간) 후 만료되는 R2 CDN 링크입니다. 그 이후의 요청은 404 오류를 반환합니다.강력히 권장합니다: 생성 직후 생성된 이미지를 자체 오브젝트 스토리지(S3 / OSS / R2), CDN 또는 데이터베이스로 다운로드하여 영구 저장하십시오. 반환된 URL을 장기간 직접 링크하지 마십시오.두 가지 권장 접근 방식:- 서버 측 프록시: 응답 후 즉시
requests.get(url)하여 자체 스토리지에 저장하고, 프론트엔드에 자체 URL을 반환합니다. b64_json사용: 요청에"response_format": "b64_json"을 추가하여 base64 이미지 데이터를 직접 수신합니다. 교차 출처 다운로드가 한 번 줄어들어 프론트엔드 렌더링이나 파일로 직접 저장하는 데 이상적입니다.
스트리밍을 지원합니까?
스트리밍을 지원합니까?
공식 OpenAI SDK를 사용할 수 있습니까?
공식 OpenAI SDK를 사용할 수 있습니까?
base_url을 https://api.apiyi.com/v1로 지정하고 api_key를 본인의 APIYI token으로 설정하십시오. 단, client.images.generate()는 기본적으로 size/n을 전송하며, 본 모델은 두 매개변수를 모두 거부하므로 /v1/images/generations 및 /v1/images/edits에 대해 requests / fetch을 사용하여 직접 HTTP 호출을 수행하는 것을 권장합니다.중국어 prompt와 영어 prompt 간에 유의미한 차이가 있습니까?
중국어 prompt와 영어 prompt 간에 유의미한 차이가 있습니까?
/v1/chat/completions를 통해 여전히 이미지를 생성할 수 있습니까?
/v1/chat/completions를 통해 여전히 이미지를 생성할 수 있습니까?
/v1/images/generations 및 /v1/images/edits를 사용하십시오(더 안정적이며 동일한 코드로 공식 릴레이 gpt-image-2에서도 작동합니다).대화형 방식은 다중 턴 반복 편집이나 온라인 이미지 URL을 직접 전달하는 두 가지 시나리오에서만 유용합니다. 이미지 생성 의도가 모호한 경우 모델이 이미지 대신 일반 텍스트를 반환할 수 있습니다(이를 보강하려면 prompt 앞에 “Generate an image:“와 같은 고정 접두사를 붙이십시오).전체 매개변수는 대화형 API 레퍼런스를 참조하십시오.관련 문서
- ⚖️ 공식 vs 리버스 비교 - 공식
gpt-image-2와 나란히 비교하는 선택 가이드 - 텍스트-이미지 플레이그라운드 -
/v1/images/generations호환 엔드포인트 - 이미지 편집 플레이그라운드 -
/v1/images/edits다중 이미지 융합 및 편집 - GPT-Image-2-VIP (동일 가격,
size및 4K 지원) - 30개의 명시적 크기(4K 포함)를 지원하는 동일 가격의 자매 모델; 호출 형식은 동일합니다 - GPT-Image-2 공식(token 과금) -
quality파라미터 / 마스크 기반 재페인팅 / 엄격한 OpenAI-API 필드 일치를 위한 용도 - GPT-Image 시리즈 개요 - 공식 GPT-Image 비교
- 커뮤니티: Luck GPT-Image 2 ComfyUI 노드 - ComfyUI에서
gpt-image-2-all를 직접 호출합니다(이중 엔드포인트: chat_completions / images_api) - 커뮤니티: APIYI GPT-Image 2 스킬 - 한 문장으로 Codex CLI / Cursor / Gemini CLI 및 기타 AI 코딩 도구에서 호출합니다
- API 매뉴얼 - 일반 호출 규약