

개요
이 페이지에서는 APIYI의 공식 릴레이를 통해 OpenAI의 GPT-Image 2.5 / 2 시리즈를 다룹니다:gpt-image-2.5-flare(속도 우선), gpt-image-2.5-sunburst(품질 및 편집 정밀도 우선), 그리고 이전 세대의 **gpt-image-2**입니다. 2.5 모델은 2026-09-08에 출시되었으며, gpt-image-2보다 높은 품질, 더 정밀한 편집, 두 가지 새로운 quality 등급(xhigh / max)을 제공하면서도 gpt-image-2와 가격 및 파라미터가 정확히 동일합니다. 시리즈 공통 기능: 모든 유효 해상도 지원(2K / 3840×2160 4K 포함), 참조 이미지 자동 고충실도 처리, token 단위 과금. APIYI의 게이트웨이는 OpenAI Images API와 완벽하게 호환됩니다. 코드 변경 없이 직접 연결하려면 공식 OpenAI SDK의 base_url를 여기로 지정하면 됩니다.
xhigh / max 품질 등급. 정밀한 크기/품질 제어가 필요하거나, OpenAI 공식 API와 완전히 동일해야 하거나, 4K 출력이 필요한 프로덕션 시나리오에 가장 적합합니다. 기본 텍스트-이미지는 gpt-image-2.5-flare, 편집은 gpt-image-2.5-sunburst를 사용합니다.텍스트-이미지 API
/v1/images/generations — 텍스트 prompt로 이미지를 생성하며 크기 / 품질 / output_format을 제어할 수 있습니다.이미지 편집 API
/v1/images/edits — 참조 이미지(최대 16개) 및 편집/융합 지침을 multipart로 업로드하며, 마스크 인페인팅을 지원합니다.AI 에이전트에게 연동 작업 맡기기
이 프롬프트를 복사하여 Codex / Claude Code / Cursor에 붙여넣으십시오
먼저 이 페이지의 일반 텍스트 버전을 가져온 후(모든 문서 URL 끝에 .md 추가), 프로젝트의 고유 기술 스택에 맞춰 코드를 작성합니다. 가장 빈번하게 발생하는 4가지 함정(타임아웃, base64 렌더링, 업로드 압축, 품질 등급)이 이미 요구사항에 반영되어 있습니다.
Integrate / troubleshoot GPT-Image 2.5 series text-to-image and image editing in this project: use
gpt-image-2.5-flarefor text-to-image andgpt-image-2.5-sunburstfor imag …Read the docs before you touch code: fetch https://docs.apiyi.com/en/api-capabilities/gpt-image-2/overview.md for the plain-text version of this page. For finer parameter detail, append
.mdto the …
- Timeout: raise the client timeout to 360 seconds. The image APIs are synchronous — there is no task ID, so if the client disconnects the result is lost …
총 7가지 요구사항입니다. 전체 프롬프트를 복사하려면 아래 버튼을 사용하십시오.
이 프롬프트가 방지해 주는 문제점
이 프롬프트가 방지해 주는 문제점
APIYI의 GPT-image-2 공식 릴레이를 선택해야 하는 이유
OpenAI의 공식 채널을 기반으로 구축되었으며, 신뢰성, 비용, 연동 경험 전반에 걸쳐 엔터프라이즈 프로덕션 워크로드에 맞게 대폭 최적화되었습니다:공식 채널 · 공식 서비스와 동일
동시 실행 수 제한 없음
동일한 가격 + 최대 15% 할인
전 세계 어디서나 장벽 없는 접속
api.apiyi.com에 바로 연결할 수 있으며, 국경 간 재구축 작업 없이 안정적인 지연 시간을 제공합니다.전체 모델 라인업 지원
gpt-image-2-all(이미지당 $0.025 단일가) 또는 비용 면에서 가장 유리한 Nano Banana Pro / 2로 원활하게 전환할 수 있으며, 시나리오에 따라 조합하여 사용할 수 있습니다.전문 엔터프라이즈 기술 지원
모델 선택: flare / sunburst / gpt-image-2
2026-09-08부터 이 문서 그룹에서는 세 가지 OpenAI GPT-Image 2.5 / 2 모델을 다룹니다. 세 모델은 모두 동일한 가격, 매개변수, 그룹 및 엔드포인트를 공유하며, 전환은 한 필드model만 변경하면 됩니다.
핵심 기능
모든 해상도 지원(4K 포함)
자동 고충실도
input_fidelity를 전달하지 마십시오(오류가 발생합니다).20-30% 더 저렴함
중국어 + 텍스트 렌더링
high 품질에서는 흐릿해지는 경우가 드뭅니다.다중 이미지 융합(최대 16장)
image[] 배열은 최대 16개의 참고 이미지를 허용합니다. prompt에서 “image 1 / image 2 / image 3”를 사용해 업로드 순서대로 참조할 수 있습니다.마스크 인페인팅
여러 출력 형식
output_compression를 설정하십시오.OpenAI SDK 직접 사용
base_url를 https://api.apiyi.com/v1로 지정하고 공식 OpenAI SDK로 바로 호출하십시오. 코드 변경 없이 마이그레이션할 수 있습니다.가격 정책
APIYI의gpt-image-2.5-flare / gpt-image-2.5-sunburst / gpt-image-2 (기본 그룹)은 OpenAI의 공식 요율과 정확히 일치하는 하나의 가격표를 공유합니다 — 할인은 대신 충전 보너스에서 제공됩니다. $100를 충전하면 10%의 보너스를 받을 수 있으며, 최대 20%까지 제공됩니다. 📖 충전 프로모션 알아보기.
토큰 요율(OpenAI의 목록과 동일)
토큰 기준 과금 — 요청 1건 = 입력 텍스트 + 입력 이미지 + 출력 이미지 token:이미지당 비용 참고(공식 표, gpt-image-2)
1K 사전 설정 크기에서gpt-image-2의 일반적인 이미지당 비용입니다(2.5 모델은 동일한 등급 이름에 대해 서로 다른 token 수를 사용합니다. 다음 섹션을 참조하십시오).
- 단가는 OpenAI의 정가와 동일합니다. 충전 보너스($100 충전 시 10%, 최대 20%)를 더하면 직접 이용하는 것보다 실제 비용이 낮아집니다.
- 2K / 4K에는 고정된 이미지당 가격이 없으며 실제 입력 + 출력 token을 기준으로 과금됩니다.
- 편집 요청은 고화질 충제가 적용되므로 텍스트-이미지 요청보다 입력 token이 눈에 띄게 많습니다.
- 스트리밍(
stream: true+partial_images: N)은 부분 결과마다 출력 이미지 token 100개가 추가로 부과됩니다. - 동일한 크기와 품질에서
gpt-image-1.5와 비교하면gpt-image-2가 약 20~30% 저렴합니다.
2.5 모델의 품질 단계 및 측정된 비용 (측정일: 2026-09-09)
동일한 티어 이름이 2.5와 gpt-image-2에서 동일한 token 수를 의미하지는 않습니다: 2.5에서는 품질 단계가 다시 분류됩니다.low는 변경되지 않고, 2.5의 high는 gpt-image-2의 medium와 같으며, 2.5의 max는 gpt-image-2의 high와 같습니다. 표에는 usage.output_tokens 및 1024×1024 텍스트-이미지 변환의 $30 / 1M 기준 출력 비용이 표시되어 있으며, 동일한 prompt로 각각 한 번씩 순차 실행한 결과입니다(flare와 sunburst는 티어별 token 수가 동일하고 지연 시간만 다릅니다).
여러 입력 이미지가 가격에 미치는 영향(2026년 7월 검증됨)
많은 고객이 묻는 질문입니다. “참조 이미지마다 정액 요금이 적용되나요, 아니면 더 큰 이미지일수록 더 많은 tokens가 드나요?” 답은 둘 다 영향을 미치며, 이미지 수는 엄격하게 선형적으로 누적됩니다.gpt-image-2는 모든 입력 이미지를 강제 고해상도로 처리하며(input_fidelity는 조정할 수 없습니다. 이를 전달하면 400이 반환됩니다), 각 참조 이미지는 크기와 종횡비에 따라 image token으로 변환됩니다. 통제된 측정값(편집 endpoint, 2026-07-15):
- 개수는 엄격하게 선형입니다: N개의 참조 이미지는 대략 N × 단일 이미지 tokens입니다. 1024² 해상도의 참조 이미지 16장은 ≈ 16384 tokens ≈ $0.13으로, 하나의
high출력($0.211)과 같은 자릿수이므로 여러 이미지 융합에서는 더 이상 무시할 수 없습니다. - 크기에는 하한과 상한이 모두 있습니다: 1024² 이하의 정사각형 이미지는 모두 1024 tokens로 과금됩니다(512로 줄여도 절약되는 것은 없습니다). 2048²와 4096²는 모두 1521 tokens가 듭니다(과도하게 큰 이미지는 변환 전에 축소되므로 상한이 적용됩니다). 단일 참조 이미지는 종횡비를 포함해 대략 800~1600 token 범위에 들어갑니다.
- tokens는 파일 크기가 아니라 픽셀 크기로 결정됩니다: 1.5MB로 압축하면 업로드 안정성과 속도는 좋아지지만 image tokens는 줄지 않습니다. 반대로 50MB 원본을 올려도 요금이 폭증하지는 않습니다(상한이 적용됩니다).
2K/4K 비용 추정치(픽셀 비율 외삽, ⚠️ 공식 고정 가격 아님)
OpenAI는 1K 크기에 대해서만 이미지당 고정 가격표를 공개합니다 — 2K/4K에 대한 공식적인 크기별 가격은 없습니다. 아래 표는 위의 1K 공식 요율을 기준으로 픽셀 수에 따라 스케일링한 APIYI의 자체 외삽이며, 예산 산정용일 뿐입니다:SaaS 구독 / 크레딧 기반 과금과의 차이
이미지 생성 도구 제공업체는 일반적으로 두 가지 방식으로 과금합니다.- 월간 구독 요금제: 월 정액으로 “월 N개 이미지” 쿼터를 제공하는 방식입니다. 이 쿼터는 과대 판매 가정을 바탕으로 가격이 책정됩니다. 즉, 제공업체는 대부분의 사용자가 할당량을 모두 사용하지 않을 것이라는 기대를 가격에 반영하므로, 광고되는 “이미지당 비용”은 실제로 개별 이미지를 생성하는 데 드는 비용이 아니라 요금제 가격을 쿼터 상한으로 나눈 값에 불과합니다.
- 크레딧 / 포인트 기반 계량: 품질이나 크기가 다른 작업을 불투명한 “크레딧”으로 환산합니다. 이는 사실상 내부적으로는 사용량 기반 과금이지만, 실제 token 소비를 가리는 크레딧 단위 뒤에 다시 포장한 것에 불과합니다.
각 호출의 실제 token 수를 확인하는 방법
/v1/images/generations과 /v1/images/edits 모두 usage 필드를 반환하며, 이미지 입력 token과 텍스트 입력 token은 별도의 필드로 반환됩니다. 추정할 필요 없이 해당 값을 읽으면 호출별 정확한 비용을 확인할 수 있습니다. 다음은 참조 이미지 한 장을 포함한 실제 편집 요청에서 실시간으로 캡처한 전체 usage 객체입니다.
그룹 설정
세 가지 GPT-Image 2.5 / 2 모델은 모두 동일한 공식 릴레이 그룹을 공유합니다. 대시보드에서 → token 설정 → 그룹으로 전환합니다.image2Enterprise로 전환하여 급증 상황을 안정적으로 넘길 수 있습니다.
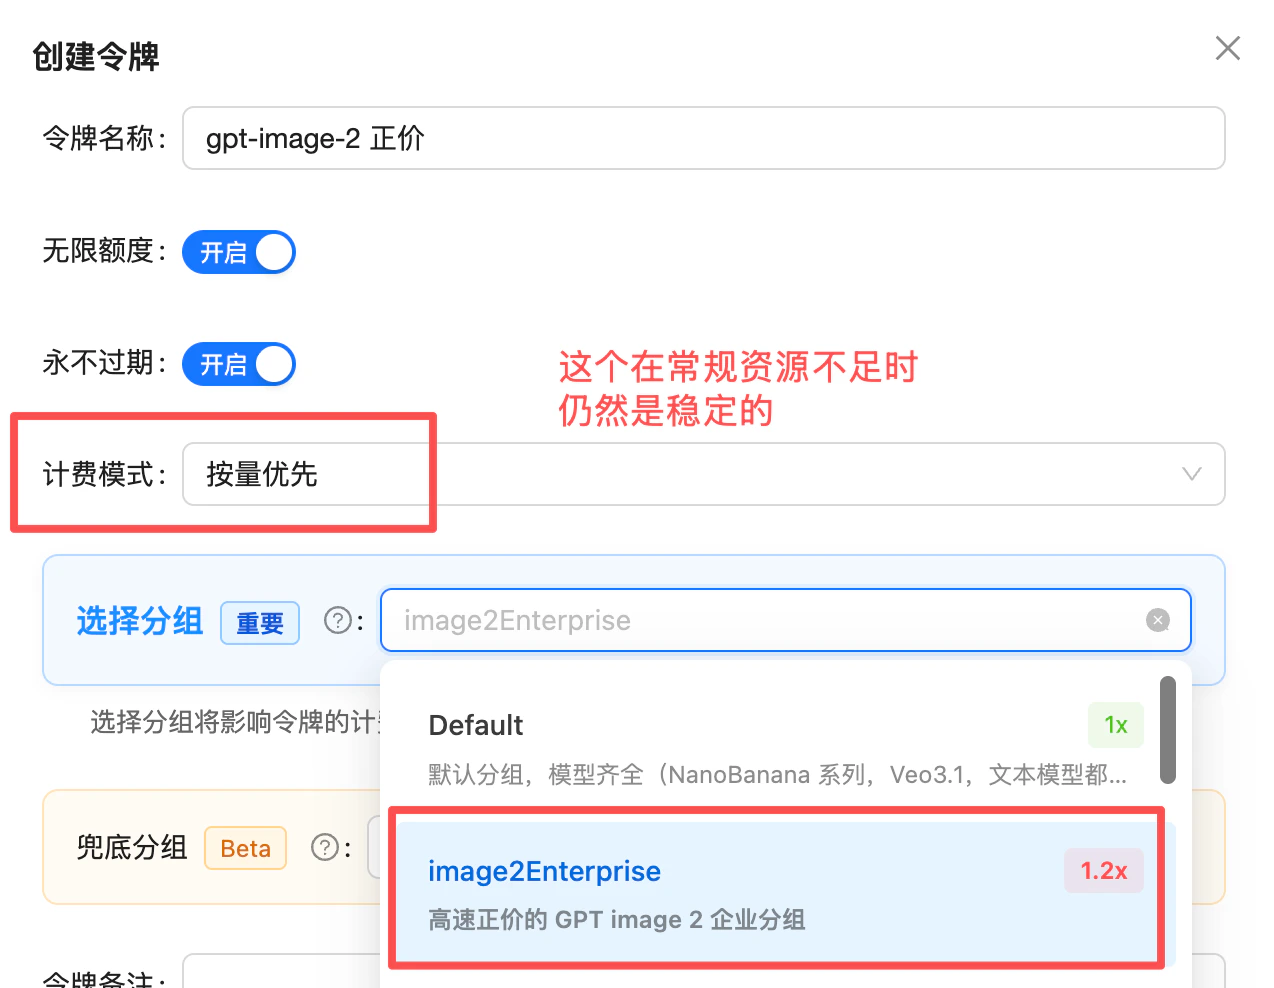
Token settings: pick the image2Enterprise group (1.2x) — stable when default capacity is tight
기술 사양
엔드포인트
크기 참조
사전 설정된 크기
사용자 지정 크기 제약
gpt-image-2은 다음 조건을 모두 만족하는 유효한 크기라면 무엇이든 허용합니다.
- 최대 변 ≤ 3840px
- 양쪽 변이 모두 16의 배수
- 가로세로 비율 ≤ 3:1
- 총 픽셀 수 ∈ [655,360, 8,294,400] (~0.65MP to ~8.3MP)
1600x1200, 1792x1024, 2048x1536, 3200x1800
유효하지 않은 예시: 1000x1000 (16의 배수가 아님), 4000x4000 (최대값 초과), 3840x1000 (비율 > 3:1)
품질 참고
사용 가능한 티어
quality는 가격에 가장 큰 영향을 미치며, size보다도 영향이 큽니다. 이미지 출력 token 수는 quality × size에 의해 결정되지만 quality의 영향이 훨씬 큽니다. 동일한 크기에서 low에서 high로 변경하면 이미지당 비용이 30배 이상 달라질 수 있습니다(위의 “이미지당 비용” 표를 참조하십시오. 1024×1024에서 gpt-image-2는 low $0.006부터 high $0.211까지이며, 2.5 모델은 low $0.006부터 max $0.211까지입니다). 먼저 quality로 비용을 추정한 다음 size의 영향을 반영하십시오.모범 사례
먼저 low로 연동하십시오
quality=low + 프리셋 크기로 시작하십시오. low은(는) high보다 몇 배 더 빠르므로, 기능적 문제가 긴 지연 시간에 가려지지 않고 신속하게 드러납니다.프리셋 크기를 우선 사용하십시오
시나리오에 맞춰 품질을 선택하십시오
low, 일상적인 용도 / 최종 결과물 → medium, 텍스트, 정교한 텍스처, 인쇄 → high. low ↔ high 간의 차이는 단순한 시각적 충실도 차이를 넘어 추론 복잡도의 근본적인 단계적 변화이므로, 지연 시간 또한 그에 맞춰 증가한다는 점에 유의하십시오.JPEG 출력을 선택하십시오
output_format=jpeg + output_compression=85이(가) PNG보다 빠르며 파일 크기도 약 절반 수준입니다.텍스트 시나리오에서는 high를 고정하십시오
quality=high(으)로 고정하십시오.참조 이미지를 준비하십시오
투명 배경: 파라미터를 전달하고, prompt에서 배경 장면을 제외하십시오
gpt-image-2.5-flare / gpt-image-2.5-sunburst만 투명 배경을 지원합니다(gpt-image-2은(는) 2026-09-30부터 OpenAI에서 400 오류로 거부됨). png / webp을(를) 사용한 background: "transparent"은(는) 알파 채널만 보장합니다. prompt나 참조 이미지가 전체 장면(숲, 방, 거리 등)을 묘사하고 있다면, 모델은 해당 장면을 그리며 파라미터가 이를 막지 못합니다. 이것이 바로 투명 배경이 “간헐적으로만 작동하는” 주된 이유이며, quality와(과)는 아무 관련이 없습니다(2026-09-11 측정 기준: 피사체 전용 prompt는 16/16 투명 생성, 장면 prompt는 0/3 투명 생성, medium 및 high 모두 동일). prompt의 끝에 isolated subject on a transparent background, no scenery, no ground을(를) 추가하십시오. 참조 이미지에 배경이 포함되어 있다면 편집 prompt에 remove the background entirely, keep only the subject을(를) 명시하십시오. 자세한 내용은 투명 배경 FAQ를 참조하십시오.클라이언트 타임아웃을 단계별로 설정하십시오 (high → 600초 안전 마진)
quality 및 **size**이며, 특히 quality이(가) 큰 영향을 미칩니다. 단계별로 클라이언트 타임아웃을 구성하십시오.high 모드에서는 안전 마진 타임아웃을 600초로 설정하십시오. UI에 진행 상태를 표시하고 서버 측에 작업 큐 도입을 고려하십시오.마이그레이션 참고 사항
gpt-image-1.5에서 마이그레이션하는 경우: input_fidelity을(를) 삭제하십시오(강제 고충실도로 설정되어 전달 시 오류 발생). 투명 배경의 경우 두 가지 2.5 모델 중 하나로 이전하십시오(gpt-image-2은(는) 2026-09-30부터 background: transparent을(를) 더 이상 허용하지 않습니다). 레거시 DALL·E 2/3 코드에서 마이그레이션하는 경우: response_format을(를) 삭제하십시오(GPT Image 모델은 400 Unknown parameter: 'response_format' 오류와 함께 이를 거부하며, 출력은 항상 b64_json입니다).오류 및 재시도
quality에 따라 요청 타임아웃을 단계별로 설정하십시오:low≥ 120초 /medium≥ 240초 /high≥ 600초(안전망 — 3~5분이 관찰됨, 120초/360초 정도로 설정하면 불필요한 타임아웃 오류가 다수 발생함)- 먼저
quality=low와(과) 연동한 후, 실제 품질 요구에 따라medium/high(으)로 전환하십시오. - 5xx 및 타임아웃에 대한 지수 백오프 적용(2회 재시도 권장)
- 기술 지원을 위해
x-request-id헤더 기록
FAQ
400 Unknown parameter: 'response_format' 오류는 어떻게 해결하나요?
400 Unknown parameter: 'response_format' 오류는 어떻게 해결하나요?
response_format 파라미터를 제거하십시오. 이는 현재 가장 흔히 발생하는 400 오류입니다. gpt-image-2(및 전체 GPT Image 시리즈)는 response_format을(를) 허용하지 않습니다. 출력 형식은 b64_json(으)로 고정되어 변경할 수 없습니다. 이를 전달하면 다음이 반환됩니다:url / b64_json을 제공하던 DALL·E 2/3 시대의 유산으로, 많은 기존 샘플 코드와 일부 서드파티 라이브러리에 여전히 기본값으로 포함되어 있습니다. gpt-image-2(으)로 마이그레이션할 때는 해당 필드를 삭제하고 data[0].b64_json을(를) 직접 읽으십시오(순수 base64 — 디코딩하여 이미지 파일을 가져옵니다). 이 오류는 입력 유효성 검사 단계에서 반환되므로 과금되지 않습니다.워크플로상 base64 대신 이미지 URL이 반드시 필요한 경우:- 공식
gpt-image-2은(는) URL 출력을 지원하지 않으므로, base64를 디코딩하여 자체 오브젝트 스토리지에 업로드하십시오. - 또는
response_format: "url"을(를) 지원하고 24시간 동안 유효한 CDN 링크를 반환하는 리버스 엔지니어링 모델gpt-image-2-all(으)로 전환하십시오.
b64_json에 data:image/png;base64, 접두사를 추가해야 하나요?
b64_json에 data:image/png;base64, 접두사를 추가해야 하나요?
gpt-image-2은(는) gpt-image-2-all과(와) 달리 순수 base64 문자열(접두사 없음)을 반환합니다. 클라이언트 패턴은 두 가지입니다:- 파일 저장:
base64.b64decode(b64_str)→ 디스크에 저장 - 브라우저 렌더링:
img.src = 'data:image/png;base64,' + b64_str(수동으로 접두사 추가)
input_fidelity를 전달할 때 400이 반환되는 이유는 무엇인가요?
input_fidelity를 전달할 때 400이 반환되는 이유는 무엇인가요?
gpt-image-2은(는) 참조 이미지의 고충실도 처리를 강제하며 더 이상 input_fidelity을(를) 허용하지 않습니다. 1.5에서 마이그레이션할 때는 대체할 필요 없이 이 필드를 제거하기만 하면 됩니다.투명 배경이 필요한 경우는 어떻게 해야 하나요?
투명 배경이 필요한 경우는 어떻게 해야 하나요?
gpt-image-2.5-flare 또는 gpt-image-2.5-sunburst을(를) 사용하고 output_format을(를) png 또는 webp(으)로 설정한 background: "transparent"을(를) 전달하십시오. 반환되는 결과물은 실제 알파 채널 이미지이므로 누끼 작업 등의 후처리가 필요하지 않습니다. 텍스트-투-이미지와 이미지 편집 모두 이를 지원합니다. gpt-image-2은(는) 지원하지 않습니다: OpenAI는 2026-09-30에 해당 투명 배경 기능을 종료했으며 현재는 400을 반환합니다. 다른 파라미터는 그대로 두고 모델 이름만 변경하십시오.두 가지 제한 사항이 있습니다: jpeg은(는) 알파 채널이 없으며 투명도와 상호 배타적입니다(400 반환). 또한 편집 엔드포인트에서 투명도는 원본 윤곽선의 정밀한 추적이 아닌 **재그리기(re-draw)**이므로 피사체의 세부 표현이 달라질 수 있습니다. 픽셀 단위로 정확한 추출을 원하신다면 rembg / PIL / sharp을(를) 직접 실행하십시오.세 번째 제한 사항은 많은 분들이 놓치는 부분입니다: prompt나 참조 이미지가 배경/장면을 묘사하고 있다면 모델은 그 장면을 그립니다. 파라미터로 이를 무시할 수 없으며, quality을(를) 올려도 도움이 되지 않습니다. 피사체만 묘사하고 isolated subject on a transparent background, no scenery, no ground(으)로 마무리하십시오.자세한 내용 및 모델별 지원 현황: 투명 배경 이미지 생성 방법.호출당 몇 개의 이미지가 생성되나요?
호출당 몇 개의 이미지가 생성되나요?
n=1). N개의 이미지를 생성하려면 N개의 병렬 요청을 실행하십시오. 각 요청마다 독립적으로 token 과금이 적용됩니다.2K/4K 해상도는 왜 이렇게 느린가요?
2K/4K 해상도는 왜 이렇게 느린가요?
quality=high + 고해상도 조합은 이미지당 약 235초(~4분)가 소요되는 것을 확인했으며, 3840×2160 + high의 롱테일은 5분 가까이 늘어날 수 있습니다. 권장 사항:- 먼저
quality=low(으)로 연동하여 호출 체인을 검증한 후 실제 품질 요구 사항에 맞춰 단계를 올리십시오. - 품질별로 클라이언트 타임아웃을 차등 설정하십시오:
low≥ 120초 /medium≥ 240초 /high≥ 600초(안전망) - UI에 “생성 중” 진행 상태를 표시하십시오.
- 4K가 필요하지 않은 경우 1024×1024 / 1536×1024 1K 프리셋을 사용하십시오.
입력 캐싱 할인 요금의 혜택을 실제로 받을 수 있나요?
입력 캐싱 할인 요금의 혜택을 실제로 받을 수 있나요?
편집 요청이 텍스트-투-이미지보다 비싼 이유는 무엇인가요?
편집 요청이 텍스트-투-이미지보다 비싼 이유는 무엇인가요?
gpt-image-2은(는) 참조 이미지의 고충실도 처리를 자동으로 활성화하므로, 참조 이미지 자체가 Vision 과금 규칙에 따라 대량의 입력 token 수로 환산됩니다. 편집 작업의 입력 tokens는 텍스트-투-이미지보다 눈에 띄게 많으므로 예산 수립 시 이를 반영하십시오.크기와 참조 이미지가 같은데 호출할 때마다 비용이 다르게 책정되는 이유는 무엇인가요?
크기와 참조 이미지가 같은데 호출할 때마다 비용이 다르게 책정되는 이유는 무엇인가요?
quality이(가) auto(으)로 설정되었거나 누락되었기 때문입니다. “크기, 해상도, 참조 이미지가 동일한데도 가격이 들쭉날쭉하다”는 문의를 받는 경우가 있습니다. 확인해 보면 size과(와) quality이 모두 auto(으)로 설정되어 있었습니다.원인은 바로 quality: auto입니다: auto 모드에서 모델은 각 생성 작업마다 요청을 해석하여 즉석에서 다른 품질 등급을 선택합니다. 등급이 다르면 출력 이미지 token 수가 달라지고, 이에 따라 비용도 달라집니다. 아래는 동일한 입력(각각 1061 input tokens) 임에도 비용이 몇 배씩 차이 나는 실제 과금 기록 세 건입니다:auto이(가) 더 높은 품질 등급으로 결정되어 출력 tokens가 5146으로 급증했고, 비용도 약 3.5배 상승했습니다.해결 방법: quality을(를) auto 상태로 두지 말고 low / medium / high을(를) 명시적으로 전달하십시오. 고정된 등급을 사용하면 동일한 입력에 대한 출력 token 수와 가격이 안정적이고 예측 가능해집니다. 위의 “품질 참조(Quality Reference)” 섹션을 확인하십시오.편집 엔드포인트의 이미지 수량 및 크기 제한은 어떻게 되나요?
편집 엔드포인트의 이미지 수량 및 크기 제한은 어떻게 되나요?
gpt-image-2 이미지 편집 엔드포인트(/v1/images/edits)는 최대 16장의 참조 이미지를 지원합니다:- multipart/form-data 파일 업로드: 각 이미지는 50MB 미만이어야 하며, 형식은
png/jpg/webp입니다. - base64 data URL: 필드 길이 제한은 약 20MiB이므로(스키마
maxLength: 20971520— 50MB multipart 제한과 다른 문자열 필드 제한임), 원본 이미지를 15MB 이내로 유지하십시오. - 마스크 파일: 별도로 4MB 미만의 PNG로 제한됩니다.
편집 엔드포인트에서 400 'Invalid image file or mode for image 1' 오류가 반환됩니다. 어떻게 해야 하나요?
편집 엔드포인트에서 400 'Invalid image file or mode for image 1' 오류가 반환됩니다. 어떻게 해야 하나요?
code: invalid_image_file)는 N번째 참조 이미지가 표준 png / jpg / webp 파일이 아님을 의미합니다(1부터 시작하는 인덱스 — 인덱스를 통해 문제가 발생한 이미지를 찾을 수 있습니다).가장 흔한 원인은 스마트폰 카메라의 MPO 형식입니다. 화웨이 Mate 시리즈 휴대폰에서 바로 촬영된 .jpg 파일은 HDR 게인 맵 서브프레임이 포함되어 실제로 다중 프레임 JPEG 컨테이너(MPO) 형식을 띱니다. 헤더는 동일하게 FFD8이며, 확장자와 file 명령어 모두 JPEG로 보고하므로 육안으로는 구별이 불가능합니다. 2026년 7월 검증 결과: MPO 파일은 항상 거부되지만, 동일한 이미지를 표준 JPEG/PNG로 다시 인코딩하면 원본 해상도 그대로 성공합니다(크기, image[] 필드 이름, quality/size 파라미터와는 무관함). 이 오류는 입력 유효성 검사 단계에서 반환되므로 과금되지 않습니다.해결 방법: 업로드하기 전에 Pillow를 사용하여 다시 인코딩하십시오(Image.open(f).format이(가) "MPO"을(를) 반환하면 변환이 필요합니다):마스크 파일은 어떻게 준비하나요?
마스크 파일은 어떻게 준비하나요?
- 원본과 동일한 크기, PNG 형식, 4MB 미만
- 알파 채널 필수: 투명(alpha=0) = 인페인팅 영역, 불투명 = 보존 영역
- 첫 번째 이미지에만 적용됨
- 마스크는 “유연한 가이드(soft guide)” 역할을 하므로, 모델이 마스크 영역 주변을 확장하거나 축소할 수 있습니다.
gpt-image-2와 gpt-image-2-all 중 어떤 것을 선택해야 하나요?
gpt-image-2와 gpt-image-2-all 중 어떤 것을 선택해야 하나요?
공식 OpenAI SDK를 직접 사용할 수 있나요?
공식 OpenAI SDK를 직접 사용할 수 있나요?
base_url을(를) https://api.apiyi.com/v1(으)로 지정하고 api_key을(를) 사용자의 APIYI token(으)로 설정하십시오:진행 중인 생성을 취소할 수 있나요?
진행 중인 생성을 취소할 수 있나요?
gpt-image-2은(는) OpenAI의 공식 동기식 엔드포인트를 사용합니다. 요청이 제출되면 “취소” 신호 없이 완료될 때까지 실행됩니다. 클라이언트 연결이 끊어지더라도 서버는 생성을 끝까지 완료하고 정상적으로 과금합니다. 클라이언트 측 타임아웃을 신중하게 구성하십시오. “연결 끊김 = 미과금”으로 가정해서는 안 됩니다.요청 제한(RPM)이 있나요?
요청 제한(RPM)이 있나요?
비동기 호출을 지원하나요?
비동기 호출을 지원하나요?
gpt-image-2은(는) OpenAI 공식 API를 엄격히 반영하므로 동기식으로만 동작합니다. 결과가 반환될 때까지 요청이 차단(block)됩니다(high + 4K의 경우 현실적으로 1~2분 소요). 비동기 큐 또는 콜백 메커니즘이 필요한 경우:- 비즈니스 레이어에서 작업 큐(Celery / BullMQ 등)로 직접 래핑하십시오.
- 또는
gpt-image-2-all을(를) 사용하십시오. 30~60초 만에 생성되므로 프론트엔드에서 폴링하기가 더 쉽습니다.
prompt 길이 제한이 있나요? ChatGPT 웹 앱에는 왜 더 길게 붙여넣을 수 있나요?
prompt 길이 제한이 있나요? ChatGPT 웹 앱에는 왜 더 길게 붙여넣을 수 있나요?
gpt-image-2 및 두 2.5 모델 모두 동일), APIYI의 공식 릴레이에서 이를 더 축소하지는 않습니다. 이를 초과할 경우 제공자는 오류를 반환하지 않습니다. 대신 전체 prompt를 조용히 무시하고 무관한 이미지(주로 사실적인 인물 사진이나 인테리어)를 생성하며, usage.input_tokens_details.text_tokens은(는) 한 자릿수(테스트 시 8)를 보고합니다. 공식 문서에는 32,000자로 명시되어 있으며, 영문 32,000자는 약 8K tokens이므로 두 기준이 대략 일치하지만, 중국어는 밀도가 높아 약 11,000자에서 제한에 도달합니다. 이미지가 prompt와 전혀 무관하게 생성되었다면 해당 호출의 text_tokens부터 확인하십시오. 웹 앱이 무제한처럼 보이는 이유는 채팅 모델이 사용자가 붙여넣은 내용을 먼저 읽은 뒤 이미지 도구용 짧은 prompt를 자체 작성하기 때문이며, 이미지 모델은 원본 자료를 전혀 보지 못합니다. 브랜드 가이드북이나 패키징 사양서와 같은 긴 자료의 경우 텍스트 모델을 사용해 1,000~3,000자의 구조화된 prompt로 먼저 요약하십시오. 자세한 내용은 긴 프롬프트를 참조하십시오.노골적이지 않은 prompt인데 safety_violations=[sexual]과 함께 400 오류가 발생합니다. 어떻게 해야 하나요?
노골적이지 않은 prompt인데 safety_violations=[sexual]과 함께 400 오류가 발생합니다. 어떻게 해야 하나요?
moderation: low은(는) prompt 측 조정만 완화할 뿐 여기에는 도움이 되지 않습니다. 가장 흔한 원인은 분위기 위주로 묘사되고 의상 묘사가 빠져 모델이 임의로 생성하다가 기준선을 넘는 경우입니다. 다른 부분은 건드리지 말고 먼저 명확한 의상 문구 하나를 추가해 보신 후, 한 단어씩 소거하며 테스트하십시오. 전체 사례 및 20회 호출 로그: 안전 검사 거부.실패한 생성 작업도 과금되나요?
실패한 생성 작업도 과금되나요?
400 오류로 거부하며, 비용은 청구되지 않습니다. 일반적인 응답 형태는 다음과 같습니다:401(잘못된 token), 429(요청 제한). Token 과금은 요청이 실제로 모델 생성 단계에 도달한 경우(즉, 200 + b64_json이(가) 수신된 경우)에만 적용됩니다.관련 문서
- ⚖️ 공식 vs 리버스 비교 - 나란히 비교하는 선택 가이드
- 텍스트-이미지 플레이그라운드 -
/v1/images/generations인터랙티브 테스트 - 이미지 편집 플레이그라운드 -
/v1/images/edits다중 이미지 합성 + 마스크 - 심층 분석: GPT-image-2.5 출시, 더 빨라진 Flare, 더 선명해진 Sunburst - 뉴스 기사
- 심층 분석: gpt-image-2 출시 - 뉴스 기사
- 전체 연동 문서 - 전체 API 레퍼런스
- GPT-Image-2-All (리버스 엔지니어링) - 더 저렴하고 빠른 대안
- 커뮤니티: Luck GPT-Image 2 ComfyUI 노드 - ComfyUI에서
gpt-image-2/gpt-image-2.5-flare/gpt-image-2.5-sunburst직접 호출 (마스크 / 참조 이미지 16장 / 6가지 품질 등급 / 사용자 지정 크기) - 커뮤니티: APIYI GPT-Image 2 Skills - Codex CLI / Cursor / Gemini CLI 및 기타 AI 코딩 도구에서 한 문장으로 호출
- API 매뉴얼 - 일반 사용 가이드
gpt-image-2.5-flare / gpt-image-2.5-sunburst / gpt-image-2은 OpenAI의 공식 모델이며, token 단위로 과금됩니다. 고정 요금($0.025/이미지)과 더 빠른 생성 속도(30–60초)를 원하신다면 gpt-image-2-all을 참고하십시오.