

接口概述
日志查询接口返回你账号下每一次 API 调用的明细记录,包括调用的模型、实际扣费、耗时、 是否流式、以及失败时的错误码。 它和余额查询 API 是互补的:余额查询告诉你「现在还剩多少钱」, 日志查询告诉你「钱花在哪了」。 三类典型用途:自动对账
按时间段、按模型统计实际消费,与自己的业务账单核对
故障自查
查失败请求的错误码,定位是参数问题还是上游问题
报障提工单
拿到
request_id 给客服,能精确定位到那一次调用控制台也能看日志(「日志」页面)。本接口是同一份数据的程序化入口,适合需要自动化对账、
定时导出、或接入自己监控系统的场景。手动查看请直接用控制台,见 如何查看我的调用记录。
如何获取系统令牌
日志接口用系统令牌认证,与 API Key 不是一回事(详见文末注意事项)。1
访问控制台
访问
api.apiyi.com/account/profile 个人中心页面2
找到系统令牌
在页面最下方找到「账号选项 - 系统令牌」部分
3
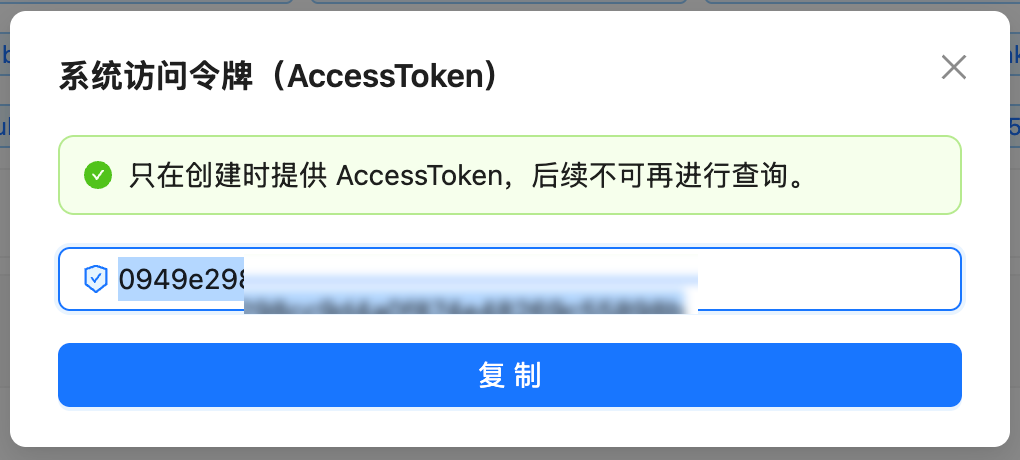
生成 AccessToken
输入当前的账户密码后,会得到一个 AccessToken,该密钥可用于后续接口的查询数据
接口信息
请求说明
请求 Headers
查询参数
把
pageSize 调大是这个接口最有效的一个优化。 按每页 10 条拉,
一个每天 50 万次调用的账号需要请求 5 万次;按每页 5000 条只要 100 次。
请求数少两个数量级,翻页深度也随之降下来 —— 参见下方「性能须知」。实测每页 5000 条的响应约 700 KB(gzip 后)、2.5 秒左右。
如果你的网络或内存吃紧,1000 是个稳妥的折中值。性能须知
单次请求的开销不是固定的,取决于三个因素。按这三条来用,这个接口很快; 反着用,会直接撞上服务端 60 秒的单条查询上限并返回错误。
四条实用规则:
- 一定要传
start_timestamp和end_timestamp。 不传时间窗是最贵的用法。 pageSize调大。 这是最省事的一条:每页 10 条改成每页 1000~5000 条, 请求数直接降两个数量级,偏移量也跟着降。- 窗口切小、而不是把偏移量翻深。 真正贵的不是「第几页」而是「跳过了多少条」—— 这个开销是超线性增长的。与其在一个大窗口里一路翻下去, 不如切成 24 个一小时的小窗口,每个窗口的偏移量都从 0 开始。
- 拉历史数据一次拉完就落库,之后只做增量。 老数据的查询成本比新数据高得多, 反复回查同一段历史是纯浪费。
如果某个窗口用
pageSize=1000 还翻了几十页才结束,说明这段时间你的调用量很大 ——
把窗口对半切开分别拉,比继续往深处翻页快得多。下方 Python 示例里的
MAX_PAGES 就是干这件事的。60 秒是硬上限,超了返回的是错误
服务端对单次查询有 60 秒的执行上限。超过这个时间,你拿到的不是一个慢响应, 而是一个错误 —— 已经花掉的时间不会给你任何数据。 以下三种用法很可能触发它,请直接避开,不要靠重试去碰运气:
重试同样的参数不会变快,只会再等 60 秒。正确的反应是把时间窗缩小、
或者把
pageSize 调大以减少翻页 —— 换句话说,让服务端每次要处理的数据量变小。
日志类型 type
响应说明
成功响应示例
关键响应字段
other 字段存的是一段 JSON 字符串而不是嵌套对象,取用前需要再解析一次
(Python 用 json.loads(),JavaScript 用 JSON.parse())。里面包含
billing_type(计费方式)、request_path(实际调用的端点)、group_ratio(分组倍率)、
model_ratio(模型倍率)、usage(用量明细)等。视频类异步任务的结算记录里另有 final_quota(该任务最终总额)、original_quota(提交时的预扣额)、
adjustment_quota(本条记录的差额)、actual_tokens(实际用量),见下方常见问题。额度换算
换算规则
500,000 额度 = $1.00 美金 (USD)
quota ÷ 500,000
示例:
quota: 7500→ $0.015 USDquota: 22500→ $0.045 USDquota: 18→ $0.000036 USD
错误响应
HTTP 401 - 认证失败
sk- 开头)当成系统令牌使用。
解决方法: 回控制台重新生成系统令牌,确认 Authorization 里填的是不带 Bearer 前缀的裸值。
代码示例
cURL 示例(单页,快速验证)
这条命令用来验证令牌配好了没有。真正的对账请用下面的每日同步脚本。
Python 示例:每日增量同步(可直接当定时任务用)
下面这段是推荐的标准用法:每天跑一次,只拉上次同步之后的新记录,写进本地 SQLite。 重复运行是安全的(按request_id 去重),中断之后重跑会从断点继续。
落库之后,按模型、按天、按令牌的各种统计都在你自己的库里做,不需要再回头查接口。
这既快得多,也避免了「日志保留期到了、想查的数据已经不在」的问题。
Node.js 示例(单个时间窗)
同样的思路:按小时切窗口、串行翻页、翻太深就把窗口切小。fetch 会自动处理 gzip 解压,Node.js 侧无需额外配置(Python 的 requests 同理)。
只有 curl 需要显式加 --compressed。典型场景
场景一:每日对账(推荐做法)
把上面的 Python 脚本挂成每天一次的定时任务,日志落到本地库; 统计花费、按模型分组、按令牌拆分这些事,全部在你自己的库里用 SQL 做。 这样做有三个好处:查询是本地的所以很快;不受日志保留期影响; 也不会因为反复回查历史数据而拖慢接口。 如果只想同步某个模型的记录,在请求参数里加model_name 即可。
场景二:找出失败的调用
落库之后直接查本地表:被网关拒绝的请求(参数错误等)
quota 为 0,不产生扣费。日志里能看到 error_code,
方便你区分「调用失败了」和「调用成功但结果不满意」。场景三:报障时提供 request_id
在日志里定位到出问题的那次调用,把request_id 提供给客服,可以精确查到该次请求的
完整链路。这比描述「大概几点调用 xx 模型失败了」高效得多。
常见问题
请求很慢,或者直接超时报错,怎么办?
请求很慢,或者直接超时报错,怎么办?
先检查这三件事,绝大多数慢查询都出在这里:
- 有没有传
start_timestamp/end_timestamp? 不传时间窗是最贵的用法, 服务端会在你的全部历史里回溯。 - 时间窗是不是太老或太宽? 查一个月前的数据比查昨天贵得多; 跨度也建议压到 1 天以内,量大的账号按小时切。
p是不是已经翻到几千页? 翻页开销是超线性增长的。 正确的做法是把时间窗切小、让每个窗口只翻几十页,而不是在一个大窗口里往深处翻。
为什么我只拿到 10 条记录?
为什么我只拿到 10 条记录?
十有八九是参数名写成了下划线的 最大 5000,超过会明确报错。数据量大时仍然需要翻页(
page_size。正确的写法是驼峰 pageSize。这是本接口唯一一个驼峰参数,其余(model_name、
token_name、start_timestamp 等)都是下划线,很容易顺手写错。
写错不会报错,服务端会当作没传、回落到默认的每页 10 条。p=0、p=1 …),
翻到返回空数组为止 —— 上面的 Python 与 Node.js 示例已经封装好这个逻辑。能不能按 request_id 直接查某一次调用?
能不能按 request_id 直接查某一次调用?
可以,传 排查某一次具体调用时,这比按时间段拉一堆记录再筛要快得多。
request_id 即可,命中时只返回那一条:响应里有些字段是空的,是不是出问题了?
响应里有些字段是空的,是不是出问题了?
不是。部分字段属于平台内部信息,普通账号视角下为空或 0,属正常现象,
不影响对账与排障需要的字段(
quota、model_name、error_code、request_id 等都是完整的)。token_group 的值和控制台显示的分组名不一样?
token_group 的值和控制台显示的分组名不一样?
接口返回的是分组的标识符,控制台显示的是分组的展示名,两者可能不同。
例如接口返回
default,控制台显示「Default」。完整的对应关系可以从公开接口 https://api.apiyi.com/api/pricing 的 usable_group
字段获取,它是一个「标识符 → 展示名」的映射表。如果你要让自己的报表和控制台显示一致,
需要自己做一次映射。quota 和 usage 里的 token 数对不上怎么办?
quota 和 usage 里的 token 数对不上怎么办?
以
quota 为准。quota 是本次调用实际扣除的额度,是唯一可用于对账的字段。
响应体里的 token 数在部分按次计费的模型(如出图、视频类)上可能是占位值,
不参与计价 —— 这类模型的计价方式在 other.billing_type 里会标为 by_count。日志能查多久以前的?
日志能查多久以前的?
请按「只有最近 30 天可查」来设计你的同步逻辑。实际可查询的范围通常比 30 天更长,但我们不对保留期做承诺 ——
它会随日志清理策略调整,而且不会单独通知。把 30 天当成规划下限,
你的对账流程就不会因为清理策略变化而断掉。另外,越老的时间窗查询成本越高,即使数据还在,查起来也慢得多。所以正确的用法是每天同步一次、把数据落到你自己的库里,历史统计在本地做。
需要长期留存的账单数据,请务必自行归档,不要依赖这个接口回查。
curl 返回乱码或 jq 报错怎么办?
curl 返回乱码或 jq 报错怎么办?
原因: API 返回的是 gzip 压缩内容(Python 的 requests 与 Node.js 的 fetch 会自动解压,无需额外配置。
Content-Encoding: gzip),curl 没有自动解压。解决方案: 添加 --compressed 选项:视频任务一条变两条日志,怎么对到 task_id、怎么知道一条视频花了多少?
视频任务一条变两条日志,怎么对到 task_id、怎么知道一条视频花了多少?
Seedance 等异步视频任务按「提交时预扣、完成后多退少补」计费,所以一条视频在日志里是两条记录:
预扣行(注意它的分页参数是下划线
completion_tokens 为 0、有 request_id)和结算行(completion_tokens 是实际用量、
request_id 为空、quota 只记差额)。两条记录里都没有 task_id,本接口没法按任务逐单配对。要查一条视频的真实消费,请用任务接口按 task_id 查,返回的 quota 就是两条之和:page_size、p 从 1 开始,与本接口相反。
失败的任务 quota 仍显示预扣额,真实消费为 0(日志里有 type=11 的负数退款行)。
完整说明见 如何按 task_id 查一条 Seedance 视频的真实消费。查询日志会消耗额度吗?
查询日志会消耗额度吗?
不会。日志查询接口不消耗任何配额。
注意事项
建议的调用节奏
- 每天同步一次即可,不需要更频繁;同步的是「上次之后的增量」
pageSize用 1000~5000,不要用默认的 10 —— 这一条比其它几条加起来都管用- 串行调用,页与页之间间隔 1 秒左右,不要并发
- 客户端超时设成 60 秒(服务端单条查询的上限也是 60 秒)
- 每个时间窗的跨度不超过 1 天;调用量大的账号按小时切
- 遇到超时先缩小时间窗再重试,原样重试不会变快
相关文档
- 余额查询 API —— 查账号剩余额度
- 令牌管理 API —— 程序化创建与管理 API Key
- 如何查看我的调用记录 —— 控制台手动查看
- 日志与账单怎么看 —— 计费字段解读