

Обзор API
API запроса логов возвращает подробную запись каждого API-вызова, выполненного в рамках вашей учётной записи, включая использованную модель, фактически списанную сумму, задержку, был ли вызов выполнен с потоковой передачей, и код ошибки, если вызов завершается ошибкой. Он дополняет API запроса баланса: запрос баланса показывает, сколько кредита осталось, а запрос логов — куда он ушёл. Три типичных сценария использования:Автоматическая сверка
Суммируйте фактические расходы по временному диапазону или по модели и сверяйте их с собственной тарификацией
Самостоятельная диагностика
Проверяйте коды ошибок в неудачных запросах, чтобы отличать проблемы с параметрами от проблем на стороне upstream
Обращения в поддержку
Передайте
request_id в поддержку, чтобы они могли точно определить вызовЖурналы также доступны для просмотра в консоли на странице Logs. Этот API — программная точка входа к тем же данным,
предназначенная для автоматической сверки, запланированного экспорта или передачи в вашу систему мониторинга.
Для ручного просмотра используйте консоль — см.
Как посмотреть мои записи вызовов.
Как получить персональный token доступа
Для аутентификации в Log Query API используется персональный token доступа (начинающийся сnap_), который отличается от API-ключа (см. раздел «Важные примечания» в конце этой страницы).
1
Откройте раздел персональных tokens доступа
Перейдите на страницу своего профиля по адресу
api.apiyi.com/account/profile. В разделе Параметры аккаунта нажмите Персональные tokens доступа → Создать token.2
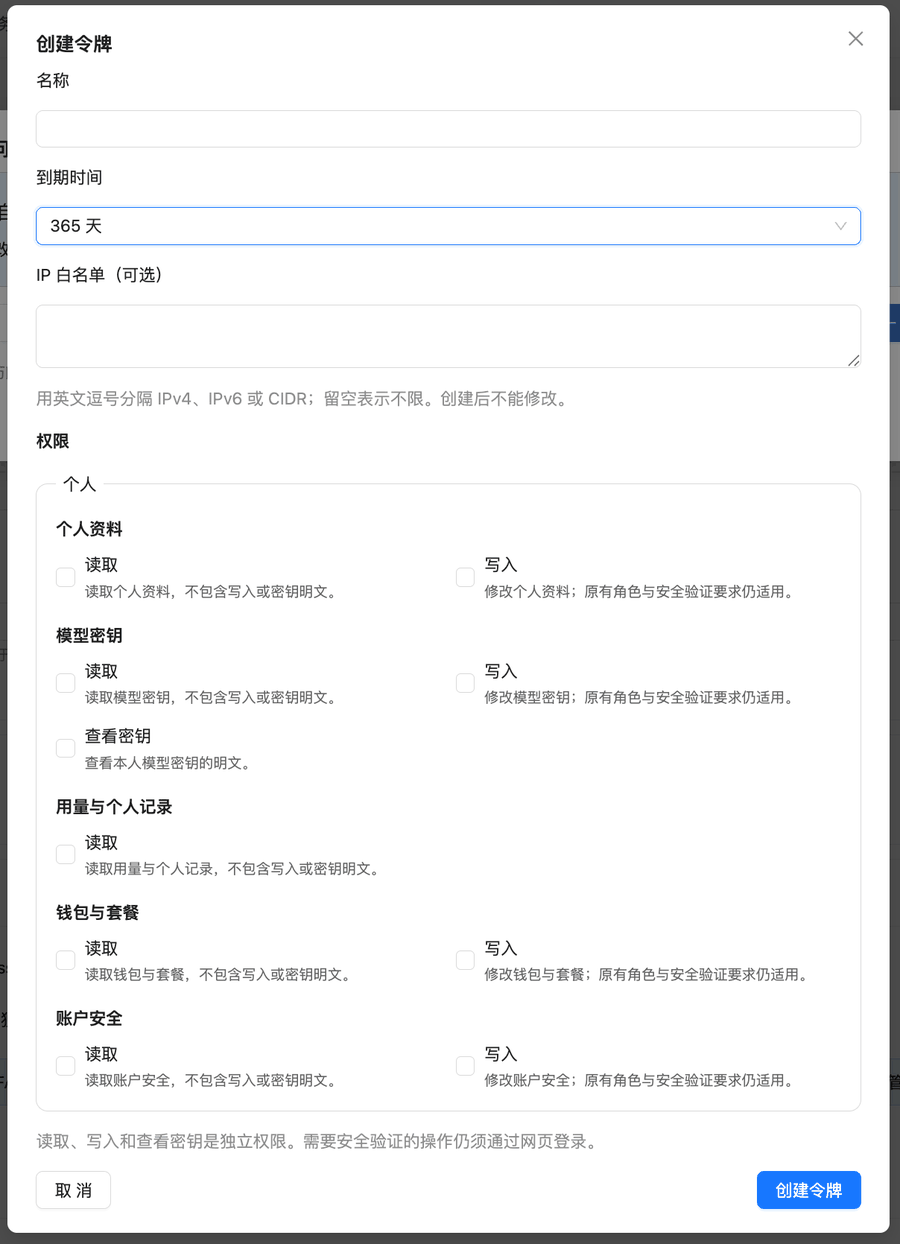
Выберите разрешения
Этому API требуется только разрешение Использование и личные записи · Чтение. Для ежедневного запланированного задания выберите более длительный срок действия. По умолчанию он составляет 30 дней, и после истечения срока действия token скрипт будет получать 401.
3
Настройте список разрешенных IP-адресов (необязательно)
Рекомендуется, если скрипт синхронизации работает на сервере со статическим IP-адресом. Список разрешенных IP-адресов нельзя изменить после создания. Сначала настройте работу скрипта без него, а затем создайте отдельный production-token со списком разрешенных IP-адресов.
Информация об API
Сведения о запросе
Заголовки запроса
Параметры запроса
Увеличение
pageSize — самая эффективная оптимизация для этого эндпоинта. При 10 записях
на страницу аккаунту, выполняющему 500,000 вызовов в день, потребуется 50,000 запросов; при
5000 на страницу — 100. Это на два порядка меньше запросов, и смещение пагинации
уменьшается вместе с ним — см. Примечания по производительности ниже.Страница на 5000 записей имеет размер примерно 700 KB в gzip и обрабатывается примерно за 2,5 секунды. Если пропускная способность или
память ограничены, 1000 — удобный компромисс.Примечания по производительности
Стоимость одного запроса не фиксирована. Она зависит от трёх факторов. Следуйте этим правилам, и API будет работать быстро; проигнорируйте их, и вы упрётесь в серверный лимит запроса в 60 секунд и получите ошибку.
Четыре практических правила:
- Всегда передавайте
start_timestampиend_timestamp. Не указывать окно — самый дорогостоящий способ вызвать этот API. - Увеличьте
pageSize. Это самый простой пункт: переход от 10 к 1000–5000 записей на страницу сокращает число запросов на два порядка, а вместе с ним падает и смещение. - Сужайте окно вместо того, чтобы углублять смещение. Платите вы не за «какая это страница», а за «сколько записей было пропущено, чтобы до неё дойти», и этот показатель растёт сверхлинейно. Вместо того чтобы проходить всё большое окно постранично, разбейте его на 24 часовых окна, чтобы каждое окно снова начиналось со смещения 0.
- Один раз выгрузите историю, сохраните её, а затем синхронизируйте только приращения. Старые данные обходятся намного дороже при запросе, чем недавние, поэтому повторное чтение одной и той же истории — это чистая трата ресурсов.
Если одно окно всё ещё занимает десятки страниц при
pageSize=1000, объём вызовов для этого периода
высокий — разбейте окно пополам и запросите каждую половину отдельно. Это намного быстрее, чем
уходить глубже по страницам. Константа MAX_PAGES в примере на Python ниже делает именно это.60 секунд — это жёсткий лимит, и его превышение возвращает ошибку
Сервер ограничивает любой отдельный запрос 60 секундами. После этого вы не получаете медленный ответ — вы получаете ошибку, а уже затраченное время не даёт вам никаких данных. С высокой вероятностью его вызовут эти три сценария. Избегайте их сразу, а не повторяйте запрос и надеетесь на удачу:
Повторная попытка с теми же параметрами не будет быстрее, она просто съест ещё 60 секунд. Правильная
реакция — сузить временное окно или увеличить
pageSize, чтобы было меньше постраничной навигации —
в любом случае дайте серверу меньше данных на обработку за один вызов.
Типы журналов
Детали ответа
Пример успешного ответа
Ключевые поля ответа
Поле
other содержит строку JSON, а не вложенный объект, поэтому требуется повторный разбор
(json.loads() в Python, JSON.parse() в JavaScript). Оно содержит billing_type,
request_path (фактически вызванный эндпоинт), group_ratio, model_ratio и usage.Записи о расчётах для асинхронных задач генерации видео также содержат final_quota (итоговую сумму задачи),
original_quota (авансовое списание при отправке), adjustment_quota (разницу для этой записи) и actual_tokens; см. раздел FAQ ниже.Конвертация квоты
Правило конвертации
500,000 квоты = $1.00 USD
quota ÷ 500,000
Примеры:
quota: 7500→ $0.015 USDquota: 22500→ $0.045 USDquota: 18→ $0.000036 USD
Ответы с ошибками
HTTP 401 - Ошибка аутентификации
sk-) был
по ошибке использован в качестве персонального access token. Изменение пароля аккаунта, двухфакторной аутентификации
или passkey отзывает каждый персональный access token.
Решение: Создайте новый персональный access token в консоли.
Два других ответа 401 содержат явное сообщение:
HTTP 403 - Доступ запрещен
Примеры кода
Пример cURL (одна страница, быстрая проверка)
Используйте это для проверки работоспособности вашего token. Для полноценной сверки используйте приведенный ниже скрипт ежедневной синхронизации.
Пример на Python: ежедневная инкрементальная синхронизация (готово для использования как задание cron)
Это рекомендуемый стандартный способ использования: запускайте его раз в день, получайте только то, что появилось с момента последней синхронизации, и записывайте это в локальную базу данных SQLite. Повторный запуск безопасен (записи дедуплицируются поrequest_id), а выполнение, прерванное на середине, возобновляется с места остановки.
Когда данные уже локально, любой нужный вам разбор — по модели, по дню, по token — выполняется на основе
вашей собственной базы данных, так что вам больше никогда не придется запрашивать для этого API. Это намного быстрее, и
это позволяет обойти проблему, когда нужны данные, которые уже вышли за пределы окна хранения.
Пример на Node.js (одно временное окно)
Та же идея: разбивайте по часам, последовательно обрабатывайте страницы и уменьшайте окно, если пагинация становится слишком глубокой.И библиотека requests для Python, и fetch API в Node.js автоматически распаковывают gzip,
так что дополнительная настройка там не нужна. Только curl требует явного флага
--compressed.Распространённые сценарии
Ежедневная сверка (рекомендуемый подход)
Настройте запуск приведённого выше Python-скрипта раз в день и сохраняйте журналы в локальную базу данных. Любую нужную вам детализацию — общие расходы, по модели, по token — затем можно получить с помощью SQL-запроса к вашей собственной базе данных. Есть три причины, почему это правильный вариант: локальные запросы выполняются быстро; вы не зависите от окна хранения журналов; и вы избегаете замедления API из-за повторного чтения старой истории. Чтобы синхронизировать записи только одной модели, добавьте параметрmodel_name в запрос.
Поиск неудачных вызовов
Когда данные находятся локально, выполняйте запрос непосредственно к своей таблице:Запросы, отклонённые шлюзом (неверные параметры и тому подобное), имеют
quota равный 0 и
не тарифицируются. error_code в журнале позволяет вам отделить «вызов завершился с ошибкой» от
«вызов завершился успешно, но мне не понравился результат».Предоставление request ID для поддержки
Найдите проблемный вызов в журналах и передайте поддержкеrequest_id. Это идентифицирует
точный запрос end to end, что гораздо эффективнее, чем описывать «вызов к какой-то модели
завершился с ошибкой примерно в определённое время».
Часто задаваемые вопросы
Мой запрос выполняется медленно или полностью завершается по тайм-ауту — что делать?
Мой запрос выполняется медленно или полностью завершается по тайм-ауту — что делать?
Сначала проверьте эти три пункта; почти каждый медленный запрос связан с одним из них:
- Передаёте ли вы
start_timestampиend_timestamp? Пропуск временного окна — самый затратный способ вызвать этот API: сервер выполняет поиск по всей вашей истории. - Окно слишком старое или слишком широкое? Запрос данных месячной давности обходится значительно дороже, чем запрос данных за вчера. Сохраняйте диапазон менее одного дня, а при больших объёмах разбивайте его по часам.
- Достигло ли
pнескольких тысяч? Стоимость пагинации растёт сверхлинейно. Решение — сузить временное окно так, чтобы для каждого окна требовалось лишь несколько десятков страниц, а не углублять пагинацию в рамках одного большого окна.
Почему я получаю только 10 записей?
Почему я получаю только 10 записей?
В девяти случаях из десяти параметр был записан как Максимальное значение — 5000, а при превышении возвращается понятная ошибка. При больших объёмах вам всё равно
нужно использовать пагинацию (
page_size в snake_case.Правильное написание — camelCase pageSize. Это единственный параметр camelCase в этом
эндпоинте: все остальные (model_name, token_name, start_timestamp, …) используют snake_case,
поэтому здесь легко ошибиться. Ошибка не возникает: сервер считает параметр
отсутствующим и использует 10 записей на страницу по умолчанию.p=0, p=1, …), пока ответ не вернёт пустой массив: примеры на Python и
Node.js выше уже включают эту логику.Можно ли найти один конкретный вызов по ID запроса?
Можно ли найти один конкретный вызов по ID запроса?
Да — передайте При исследовании одного конкретного вызова это значительно быстрее, чем загружать временной диапазон и
самостоятельно фильтровать его.
request_id, и будет возвращена только эта запись:Некоторые поля в ответе пусты — что-то не так?
Некоторые поля в ответе пусты — что-то не так?
Нет. Некоторые поля содержат внутреннюю информацию платформы и пусты или равны нулю с точки зрения
обычного аккаунта. Это ожидаемо и не влияет на поля, необходимые для
сверки или устранения неполадок:
quota, model_name, error_code и request_id
всегда полностью заполнены.Почему token_group отличается от названия группы, отображаемого в консоли?
Почему token_group отличается от названия группы, отображаемого в консоли?
API возвращает идентификатор группы, а консоль отображает метку группы.
Они могут различаться: например, API возвращает
default, а консоль показывает «По умолчанию».Полное сопоставление доступно в публичном эндпоинте https://api.apiyi.com/api/pricing
в поле usable_group, которое сопоставляет идентификатор с меткой. Если вы хотите, чтобы ваши отчёты
совпадали с консолью, примените это сопоставление самостоятельно.Количество tokens и квота, похоже, не совпадают — что является достоверным?
Количество tokens и квота, похоже, не совпадают — что является достоверным?
Используйте
quota. Это сумма, фактически списанная за вызов, и единственное поле,
подходящее для сверки. Для моделей с ценой за вызов, таких как генерация изображений и генерация видео,
количество tokens в ответе может быть значением-заполнителем, не участвующим в тарификации —
такие модели передают by_count в other.billing_type.Насколько далеко в прошлое можно выполнять запросы?
Насколько далеко в прошлое можно выполнять запросы?
Проектируйте логику синхронизации, исходя из того, что доступны для запроса только последние 30 дней.На практике доступный для запроса диапазон обычно больше, но мы не даём никаких гарантий по сроку хранения:
он меняется в зависимости от политики очистки журналов, и такие изменения отдельно не объявляются. Считайте 30 дней
минимальным ориентиром для планирования, и ваша сверка не сломается при изменении этой политики.Кроме того, чем старее окно, тем дороже запрос: даже если данные всё ещё
существуют, получить их значительно медленнее.Поэтому правильный подход — синхронизировать данные раз в день в собственную базу данных и выполнять исторический
анализ локально. Всё, что необходимо хранить в долгосрочной перспективе, архивируйте самостоятельно — не полагайтесь на этот
API для последующего получения этих данных.
curl возвращает искажённый текст или jq выдаёт ошибку
curl возвращает искажённый текст или jq выдаёт ошибку
Причина: API возвращает содержимое, сжатое gzip (Библиотека requests для Python и API fetch в Node.js распаковывают данные автоматически.
Content-Encoding: gzip), а curl
не распаковывает его.Решение: добавьте флаг --compressed:Задача генерации видео создала две записи журнала. Как сопоставить их с task_id и узнать стоимость видео?
Задача генерации видео создала две записи журнала. Как сопоставить их с task_id и узнать стоимость видео?
Асинхронные задачи генерации видео (Seedance и аналогичные) тарифицируются по принципу «предварительное списание при отправке, расчёт разницы после завершения»,
поэтому одно видео оставляет две записи: предварительное списание (Обратите внимание: параметры пагинации используют snake_case
completion_tokens равно 0, присутствует request_id) и расчёт
(completion_tokens — фактическое использование, request_id пусто, quota — только разница).
Ни одна из записей не содержит task_id, поэтому этот API не может сопоставить записи с задачами.Чтобы узнать фактическую стоимость видео, запросите API задач по task_id; его quota — это сумма двух записей:page_size, при этом p начинается с 1, в отличие от этого API.
Неудачная задача всё равно показывает предварительное списание в quota, но её фактическая стоимость равна 0 (журналы содержат отрицательную запись возврата type=11).
Подробное руководство: Как узнать фактическую стоимость видео Seedance по task_id.Расходует ли запрос журналов квоту?
Расходует ли запрос журналов квоту?
Нет. Эндпоинт запроса журналов не расходует квоту.
Важные примечания
Рекомендуемый паттерн вызовов
- Синхронизируйте раз в день — чаще не требуется; каждый запуск запрашивает только новые данные
- Используйте
pageSizeсо значением 1000–5000, а не 10 по умолчанию — это важнее всех остальных параметров, вместе взятых - Выполняйте запросы последовательно, с интервалом примерно в одну секунду между страницами, ни в коем случае не параллельно
- Установите клиентский тайм-аут на 60 секунд (лимит времени запроса на стороне сервера также составляет 60 секунд)
- Ограничивайте каждое временное окно одним днем или менее; разбивайте по часам для аккаунтов с большим объемом вызовов
- При возникновении тайм-аута уменьшите окно перед повторной попыткой — идентичный повторный запрос быстрее не выполнится
Связанная документация
- Balance Query API — проверка остатка средств на балансе аккаунта
- Token Management API — программное создание и управление API-ключами
- Как просмотреть записи моих вызовов — ручной просмотр в консоли
- Понимание логов и тарификации — как читать поля тарификации