

介面概述
日誌查詢介面返回你賬號下每一次 API 呼叫的明細記錄,包括呼叫的模型、實際扣費、耗時、 是否流式、以及失敗時的錯誤碼。 它和餘額查詢 API 是互補的:餘額查詢告訴你「現在還剩多少錢」, 日誌查詢告訴你「錢花在哪了」。 三類典型用途:自動對賬
按時間段、按模型統計實際消費,與自己的業務賬單核對
故障自查
查失敗請求的錯誤碼,定位是引數問題還是上游問題
報障提工單
拿到
request_id 給客服,能精確定位到那一次呼叫控制台也能看日誌(「日誌」頁面)。本介面是同一份資料的程式化入口,適合需要自動化對賬、
定時匯出、或接入自己監控系統的場景。手動檢視請直接用控制台,見 如何檢視我的呼叫記錄。
如何獲取系統令牌
日誌介面用系統令牌認證,與 API Key 不是一回事(詳見文末注意事項)。1
訪問控制台
訪問
api.apiyi.com/account/profile 個人中心頁面2
找到系統令牌
在頁面最下方找到「賬號選項 - 系統令牌」部分
3
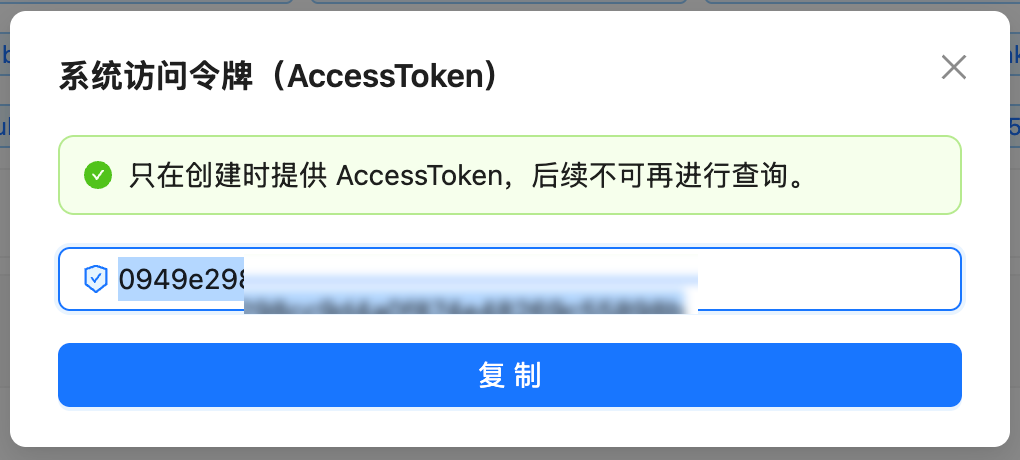
生成 AccessToken
輸入當前的賬戶密碼後,會得到一個 AccessToken,該金鑰可用於後續介面的查詢資料
介面資訊
請求說明
請求 Headers
查詢引數
把
pageSize 調大是這個介面最有效的一個最佳化。 按每頁 10 條拉,
一個每天 50 萬次呼叫的賬號需要請求 5 萬次;按每頁 5000 條只要 100 次。
請求數少兩個數量級,翻頁深度也隨之降下來 —— 參見下方「效能須知」。實測每頁 5000 條的響應約 700 KB(gzip 後)、2.5 秒左右。
如果你的網路或記憶體吃緊,1000 是個穩妥的折中值。效能須知
單次請求的開銷不是固定的,取決於三個因素。按這三條來用,這個介面很快; 反著用,會直接撞上服務端 60 秒的單條查詢上限並返回錯誤。
四條實用規則:
- 一定要傳
start_timestamp和end_timestamp。 不傳時間窗是最貴的用法。 pageSize調大。 這是最省事的一條:每頁 10 條改成每頁 1000~5000 條, 請求數直接降兩個數量級,偏移量也跟著降。- 視窗切小、而不是把偏移量翻深。 真正貴的不是「第幾頁」而是「跳過了多少條」—— 這個開銷是超線性增長的。與其在一個大窗口裡一路翻下去, 不如切成 24 個一小時的小視窗,每個視窗的偏移量都從 0 開始。
- 拉歷史資料一次拉完就落庫,之後只做增量。 老資料的查詢成本比新資料高得多, 反覆回查同一段歷史是純浪費。
如果某個視窗用
pageSize=1000 還翻了幾十頁才結束,說明這段時間你的呼叫量很大 ——
把視窗對半切開分別拉,比繼續往深處翻頁快得多。下方 Python 示例裡的
MAX_PAGES 就是幹這件事的。60 秒是硬上限,超了返回的是錯誤
服務端對單次查詢有 60 秒的執行上限。超過這個時間,你拿到的不是一個慢響應, 而是一個錯誤 —— 已經花掉的時間不會給你任何資料。 以下三種用法很可能觸發它,請直接避開,不要靠重試去碰運氣:
重試同樣的引數不會變快,只會再等 60 秒。正確的反應是把時間窗縮小、
或者把
pageSize 調大以減少翻頁 —— 換句話說,讓服務端每次要處理的資料量變小。
日誌型別 type
響應說明
成功響應示例
關鍵響應欄位
other 欄位存的是一段 JSON 字串而不是巢狀物件,取用前需要再解析一次
(Python 用 json.loads(),JavaScript 用 JSON.parse())。裡面包含
billing_type(計費方式)、request_path(實際呼叫的端點)、group_ratio(分組倍率)、
model_ratio(模型倍率)、usage(用量明細)等。影片類非同步任務的結算記錄裡另有 final_quota(該任務最終總額)、original_quota(提交時的預扣額)、
adjustment_quota(本條記錄的差額)、actual_tokens(實際用量),見下方常見問題。額度換算
換算規則
500,000 額度 = $1.00 美金 (USD)
quota ÷ 500,000
示例:
quota: 7500→ $0.015 USDquota: 22500→ $0.045 USDquota: 18→ $0.000036 USD
錯誤響應
HTTP 401 - 認證失敗
sk- 開頭)當成系統令牌使用。
解決方法: 回控制台重新生成系統令牌,確認 Authorization 裡填的是不帶 Bearer 字首的裸值。
程式碼示例
cURL 示例(單頁,快速驗證)
這條命令用來驗證令牌配好了沒有。真正的對賬請用下面的每日同步指令碼。
Python 示例:每日增量同步(可直接當定時任務用)
下面這段是推薦的標準用法:每天跑一次,只拉上次同步之後的新記錄,寫進本地 SQLite。 重複執行是安全的(按request_id 去重),中斷之後重跑會從斷點繼續。
落庫之後,按模型、按天、按令牌的各種統計都在你自己的庫裡做,不需要再回頭查介面。
這既快得多,也避免了「日誌保留期到了、想查的資料已經不在」的問題。
Node.js 示例(單個時間窗)
同樣的思路:按小時切視窗、序列翻頁、翻太深就把視窗切小。fetch 會自動處理 gzip 解壓,Node.js 側無需額外配置(Python 的 requests 同理)。
只有 curl 需要顯式加 --compressed。典型場景
場景一:每日對賬(推薦做法)
把上面的 Python 指令碼掛成每天一次的定時任務,日誌落到本地庫; 統計花費、按模型分組、按令牌拆分這些事,全部在你自己的庫裡用 SQL 做。 這樣做有三個好處:查詢是本地的所以很快;不受日誌保留期影響; 也不會因為反覆回查歷史資料而拖慢介面。 如果只想同步某個模型的記錄,在請求引數里加model_name 即可。
場景二:找出失敗的呼叫
落庫之後直接查本地表:被閘道拒絕的請求(引數錯誤等)
quota 為 0,不產生扣費。日誌裡能看到 error_code,
方便你區分「呼叫失敗了」和「呼叫成功但結果不滿意」。場景三:報障時提供 request_id
在日誌裡定位到出問題的那次呼叫,把request_id 提供給客服,可以精確查到該次請求的
完整鏈路。這比描述「大概幾點呼叫 xx 模型失敗了」高效得多。
常見問題
請求很慢,或者直接超時報錯,怎麼辦?
請求很慢,或者直接超時報錯,怎麼辦?
先檢查這三件事,絕大多數慢查詢都出在這裡:
- 有沒有傳
start_timestamp/end_timestamp? 不傳時間窗是最貴的用法, 服務端會在你的全部歷史裡回溯。 - 時間窗是不是太老或太寬? 查一個月前的資料比查昨天貴得多; 跨度也建議壓到 1 天以內,量大的賬號按小時切。
p是不是已經翻到幾千頁? 翻頁開銷是超線性增長的。 正確的做法是把時間窗切小、讓每個視窗只翻幾十頁,而不是在一個大窗口裡往深處翻。
為什麼我只拿到 10 條記錄?
為什麼我只拿到 10 條記錄?
十有八九是引數名寫成了下劃線的 最大 5000,超過會明確報錯。資料量大時仍然需要翻頁(
page_size。正確的寫法是駝峰 pageSize。這是本介面唯一一個駝峰引數,其餘(model_name、
token_name、start_timestamp 等)都是下劃線,很容易順手寫錯。
寫錯不會報錯,服務端會當作沒傳、回落到預設的每頁 10 條。p=0、p=1 …),
翻到返回空陣列為止 —— 上面的 Python 與 Node.js 示例已經封裝好這個邏輯。能不能按 request_id 直接查某一次呼叫?
能不能按 request_id 直接查某一次呼叫?
可以,傳 排查某一次具體呼叫時,這比按時間段拉一堆記錄再篩要快得多。
request_id 即可,命中時只返回那一條:響應裡有些欄位是空的,是不是出問題了?
響應裡有些欄位是空的,是不是出問題了?
不是。部分欄位屬於平臺內部資訊,普通賬號視角下為空或 0,屬正常現象,
不影響對賬與排障需要的欄位(
quota、model_name、error_code、request_id 等都是完整的)。token_group 的值和控制台顯示的分組名不一樣?
token_group 的值和控制台顯示的分組名不一樣?
介面返回的是分組的識別符號,控制台顯示的是分組的展示名,兩者可能不同。
例如介面返回
default,控制台顯示「Default」。完整的對應關係可以從公開介面 https://api.apiyi.com/api/pricing 的 usable_group
欄位獲取,它是一個「識別符號 → 展示名」的對映表。如果你要讓自己的報表和控制台顯示一致,
需要自己做一次對映。quota 和 usage 裡的 token 數對不上怎麼辦?
quota 和 usage 裡的 token 數對不上怎麼辦?
以
quota 為準。quota 是本次呼叫實際扣除的額度,是唯一可用於對賬的欄位。
響應體裡的 token 數在部分按次計費的模型(如出圖、影片類)上可能是佔位值,
不參與計價 —— 這類模型的計價方式在 other.billing_type 裡會標為 by_count。日誌能查多久以前的?
日誌能查多久以前的?
請按「只有最近 30 天可查」來設計你的同步邏輯。實際可查詢的範圍通常比 30 天更長,但我們不對保留期做承諾 ——
它會隨日誌清理策略調整,而且不會單獨通知。把 30 天當成規劃下限,
你的對賬流程就不會因為清理策略變化而斷掉。另外,越老的時間窗查詢成本越高,即使資料還在,查起來也慢得多。所以正確的用法是每天同步一次、把資料落到你自己的庫裡,歷史統計在本地做。
需要長期留存的賬單資料,請務必自行歸檔,不要依賴這個介面回查。
curl 返回亂碼或 jq 報錯怎麼辦?
curl 返回亂碼或 jq 報錯怎麼辦?
原因: API 返回的是 gzip 壓縮內容(Python 的 requests 與 Node.js 的 fetch 會自動解壓,無需額外配置。
Content-Encoding: gzip),curl 沒有自動解壓。解決方案: 新增 --compressed 選項:影片任務一條變兩條日誌,怎麼對到 task_id、怎麼知道一條影片花了多少?
影片任務一條變兩條日誌,怎麼對到 task_id、怎麼知道一條影片花了多少?
Seedance 等非同步影片任務按「提交時預扣、完成後多退少補」計費,所以一條影片在日誌裡是兩條記錄:
預扣行(注意它的分頁引數是下劃線
completion_tokens 為 0、有 request_id)和結算行(completion_tokens 是實際用量、
request_id 為空、quota 只記差額)。兩條記錄裡都沒有 task_id,本介面沒法按任務逐單配對。要查一條影片的真實消費,請用任務介面按 task_id 查,返回的 quota 就是兩條之和:page_size、p 從 1 開始,與本介面相反。
失敗的任務 quota 仍顯示預扣額,真實消費為 0(日誌裡有 type=11 的負數退款行)。
完整說明見 如何按 task_id 查一條 Seedance 影片的真實消費。查詢日誌會消耗額度嗎?
查詢日誌會消耗額度嗎?
不會。日誌查詢介面不消耗任何配額。
注意事項
建議的呼叫節奏
- 每天同步一次即可,不需要更頻繁;同步的是「上次之後的增量」
pageSize用 1000~5000,不要用預設的 10 —— 這一條比其它幾條加起來都管用- 序列呼叫,頁與頁之間間隔 1 秒左右,不要併發
- 客戶端超時設成 60 秒(服務端單條查詢的上限也是 60 秒)
- 每個時間窗的跨度不超過 1 天;呼叫量大的賬號按小時切
- 遇到超時先縮小時間窗再重試,原樣重試不會變快
相關文件
- 餘額查詢 API —— 查賬號剩餘額度
- 令牌管理 API —— 程式化建立與管理 API Key
- 如何檢視我的呼叫記錄 —— 控制台手動檢視
- 日誌與賬單怎麼看 —— 計費欄位解讀