

moderation: low 为什么没用,以及一套 20 次调用就能定位触发词的方法。
案例复盘:网页版能出、API 报 sexual
客户用gpt-image-2.5-sunburst 生成一张角色设定图(左侧脸部特写、右侧正面 / 侧面 / 背面三视图)。请求体:
我理解是内容安全,但我在 ChatGPT 网页版又能成功,你得告诉我,为啥网页版能成。提示词里没有任何露骨内容,只是「美艳女主 + 三视图 + 纯白背景」。这类「我没写什么却被拦」的工单,排查思路和「我写了什么被拦」完全不同。
先分清拦截发生在哪一层
出图模型的内容安全有两道关,触发的层不同,排查方法也不同:
判据就看耗时。本案例失败请求耗时 42 到 51 秒,成功请求 46 到 57 秒,两者没有区别,说明图已经生成完了,是输出侧分类器判了 sexual。后面的消融实验也印证了这一点:同一句提示词跑 3 次,出现过 1 过 2 拒。
提示词层拦截和参数错误一样几乎秒回。如果你的 400 等了半分钟以上才来,先按「输出层拦截」来查,别急着删提示词里的词。
为什么网页版能成
这和 如何生成满意的图片 里讲的是同一件事:网页版是 Agent,API 是单次原子调用。- ChatGPT 网页版不会把你这段话原样喂给出图模型。中间的对话模型会先改写、扩充提示词,通常会自己补上服装、场景、光线等细节。等于替你做了下文「加服装」那一步。
- API 是原文直达。你没写穿什么,模型就自由发挥;在「美艳 + 全身三视图 + 纯白背景」这个组合下,它倾向画成贴身或少衣的角色设定图,成图就容易越线。
- 再叠加输出层审核本身的随机性,网页版跑一次成功、API 跑一次失败并不矛盾。
分词消融法:一次只动一个词
提示词里有十几个形容词和构图约束,靠猜哪个词有问题效率很低。有效的办法是消融:每次只删或替换一个词块,其余一字不动,看哪一次结果翻转。1
列出可疑词块
分三类:人物形容词(美艳、性感、妩媚……)、身体相关动词(露出、展示、贴身……)、构图约束(全身、三视图、纯白背景……)。构图约束单独看没问题,但会和形容词组合出效果。
2
每次只动一个词块
删掉或换成中性词,其余原样。同时也跑一组「不动词、只加约束」的变体,比如给人物加一句明确的服装描述。
3
翻转后回归 2 到 3 次
输出层拦截有随机性,单次通过不算数。命中的变体至少再跑 2 次,全过才算找到。
4
取最小改动
目标不是「能过」,而是「改意最小地能过」。优先选不动原词、只加约束的方案。
从表里能直接读出三件事:触发词是「美艳」(删「妈感」没用、删「美艳」就过);「露出」不是原因;「面容精致」那组 1 过 2 拒,证明审核对象是每次都不同的成图而不是文本。
结论与推荐改法
触发机制:「美艳」让模型把人物往性感方向渲染,「全身三视图 + 纯白背景」又是典型的设定图构图,两者叠加,成图容易被输出侧分类器判为 sexual。提示词本身没有一个字违规。 推荐改法:保留全部原文,只在人物描述后加一句明确的服装。实测 3/3 通过,人物气质和构图都和原意一致: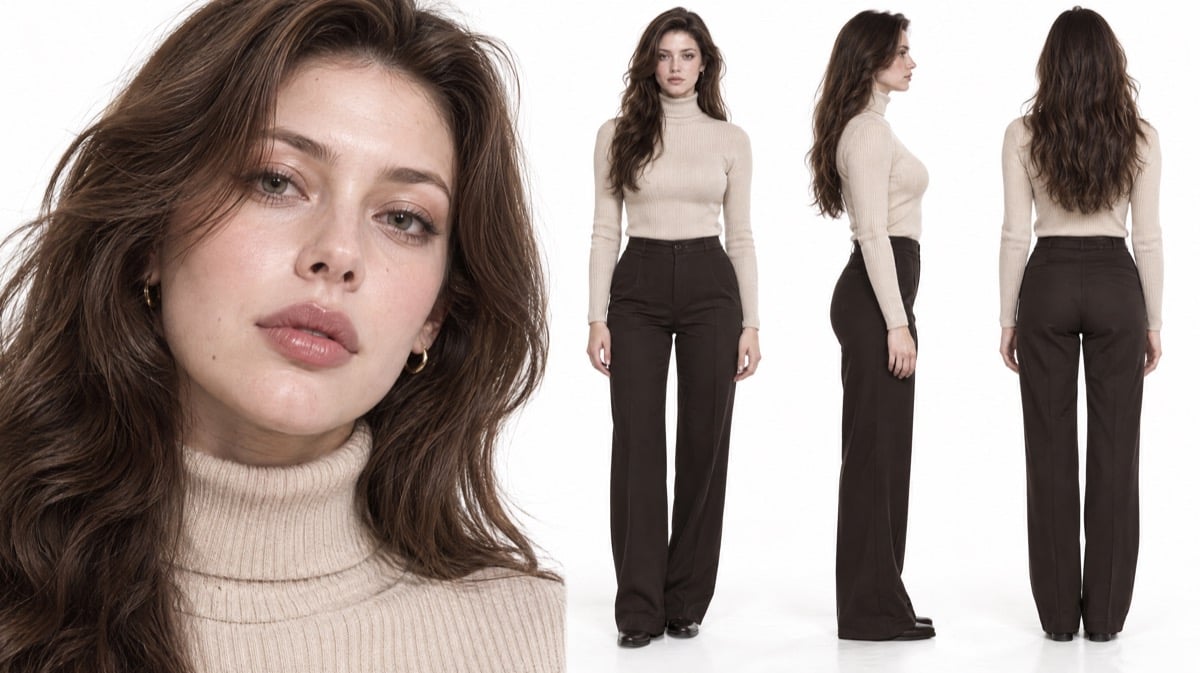
同一段提示词,只加了一句服装描述:3 次调用全部通过,脸部特写与正 / 侧 / 背三视图按要求出齐
moderation: low 为什么没用
moderation 参数(见 文生图参数表)取值 auto / low,作用是降低提示词侧的审核强度。本案例传了 low 照样 400,因为拦截发生在输出层,这个参数管不到成图的 sexual 分类。
在网关之外无法区分「参数没透传」和「参数透传了但不生效」,但对结论没有影响:遇到输出层拦截,改参数没用,得改提示词。
通用排查清单
报错是秒回还是等了很久?
报错是秒回还是等了很久?
秒回是提示词层,等了和正常出图差不多的时间是输出层。前者删明显违规词;后者用分词消融法找「推过线」的那个词,并接受同一提示词会有随机性。
提示词里有没有把「穿什么」交给模型?
提示词里有没有把「穿什么」交给模型?
人物类提示词只写气质、不写服装,是输出层拦截最常见的来源。加一句明确的服装描述,往往一步就解决,而且不动原意。
一次只改一个词了吗?
一次只改一个词了吗?
同时改三个词,过了也不知道是哪个起作用,下次换个提示词又要从头猜。每次只动一个词块,命中后回归 2 到 3 次。
被拦的请求会扣费吗?
被拦的请求会扣费吗?
按 token 计费的 gpt-image 系列触发审核返回 400 时不计费,口径见 gpt-image-2 常见问题「生成失败会扣费吗」。所以消融实验本身不花钱,只花时间。
速查总结
- 看耗时判层级:400 秒回是提示词层;等了和出图一样久才 400,是成图被输出层分类器拦下。
- 输出层拦截有随机性:同一提示词时过时不过,单次结果不能下结论,要回归 2 到 3 次。
- 网页版能过不代表 API 更严:网页版会先改写扩充提示词(补服装、场景),API 是原文直达。
- 分词消融法:一次只动一个词块,并行跑变体,取改意最小的方案。本案例触发词是「美艳」。
- 人物提示词写清服装:只加一句服装描述、其余不动,实测 3/3 通过;
moderation: low对输出层拦截无效。