

moderation: low は何もしないのか、そして約20回の呼び出しでトリガーワードを見つける方法を説明します。
事例:Webアプリでは表示されるが、APIでは性的コンテンツが返される
ある顧客がgpt-image-2.5-sunburstを使用して、キャラクターシート(左側に顔のクローズアップ、右側に正面/側面/背面のターンアラウンド)を生成しました。リクエストは次のとおりです。
コンテンツセーフティであることは理解していますが、同じ内容がChatGPTのWebアプリでは機能します。なぜWebアプリでは通るのか説明してください。プロンプトには露骨な内容は何もありません。単に「魅力的な女性+ターンアラウンド+白い背景」です。「悪いことは何も書いていないのにブロックされた」という形式のチケットには、「悪いことを書いたためブロックされた」というケースとはまったく異なるアプローチが必要です。
まず:どのレイヤーがブロックしていますか?
画像モデルには2つの安全ゲートがあります。これらは異なる形で失敗し、デバッグ方法も異なります。
レイテンシが手掛かりです。 このケースでは、失敗した呼び出しは42~51秒、成功した呼び出しは46~57秒かかりました。差がないため、画像は完全にレンダリングされてから、出力側の分類器によって性的コンテンツとしてフラグ付けされました。以下のアブレーションでもこれが確認できます。1つのpromptを3回実行したところ、1回成功 / 2回拒否となりました。
promptレベルのブロックは、パラメータエラーとほぼ同じ速さで返されます。400が30秒以上経ってから返された場合は、まず出力画像のブロックとして扱い、まだ単語の削除を始めないでください。
Webアプリが通過する理由
これは満足のいく画像を得る方法で説明したものと同じポイントです。Webアプリはエージェントであり、APIは単一のアトミック呼び出しです。- ChatGPTのWebアプリは、あなたのテキストをそのまま画像モデルに渡しているわけではありません。まずチャットモデルがプロンプトを書き換えて拡張し、通常は衣服、設定、ライティングを独自に補完します。これは、以下で説明する「衣服を追加する」ステップそのものであり、Webアプリが代わりに行ってくれています。
- APIはプロンプトをそのまま送信します。彼女が何を着ているかを指定しなかったため、モデルが判断します。「華やか + 全身のターンアラウンド + 白い背景」という条件では、タイトな衣装や最小限の衣装に傾きます。これはキャラクターシートでよく見られる表現であり、レンダリングが基準を超えてしまいます。
- さらに出力側のモデレーションによるランダム性も加わるため、「Webアプリは一度通過し、APIは一度失敗した」という結果は矛盾ではありません。
単語アブレーション:一度に1つだけ変更する
このような prompt には、十数個の形容詞やレイアウト制約が含まれています。どれが原因かを推測するのは時間がかかります。効果的なアプローチはアブレーションです。各バリアントで単語ブロックを正確に1つだけ削除または置換し、それ以外はすべてバイト単位で同一に保ち、どのバリアントで結果が反転するかを確認します。1
疑わしい単語ブロックを列挙する
3つのバケットに分けます。キャラクターの形容詞(glamorous、sexy、alluring など)、身体に関連する動詞(reveal、show、form-fitting など)、レイアウト制約(full body、turnaround、white background など)です。レイアウト制約は単独では無害に見えますが、形容詞と組み合わさると影響します。
2
各バリアントで正確に1ブロックだけ変更する
そのブロックを削除するか、中立的な単語に置き換え、それ以外は変更しないでください。また、単語は変更せず、キャラクターの明示的な服装などの制約だけを追加するバリアントも実行します。
3
反転した結果は2~3回再実行する
出力側のブロックは確率的であるため、1回の実行だけでは何も証明できません。勝ったバリアントを少なくともさらに2回再実行し、すべての実行に合格した場合にのみ採用します。
4
最小限の編集を選ぶ
目標は「合格すること」ではなく、「意図の変更を最小限に抑えて合格すること」です。元の単語を維持し、制約だけを追加するバリアントを優先してください。
この表から、3つのことがすぐに分かります。トリガーは「glamorous」です(「mature-looking」を削除しても変化せず、「glamorous」を削除すると合格する)。「reveal」は原因ではありません。また、「refined features」の行が1回の実行では合格し、2回は拒否されたことから、分類器は毎回異なるレンダリング結果を判定しており、テキスト自体を判定しているわけではないことが分かります。
結論と推奨される修正
仕組み: 「glamorous」はモデルを官能的な描画へと誘導し、「full-body turnaround + white background」は典型的なキャラクターシートのレイアウトです。これらが合わさることで、出力側の分類器が性的と判定する描画になります。プロンプト内の単語自体に違反となるものは1つもありません。 推奨される修正: 元のプロンプト全体を維持し、キャラクターの説明の直後に衣服を明示するフレーズを1つ追加します。これで3回中3回通過し、顧客が求めていた見た目とレイアウトの両方を維持できました。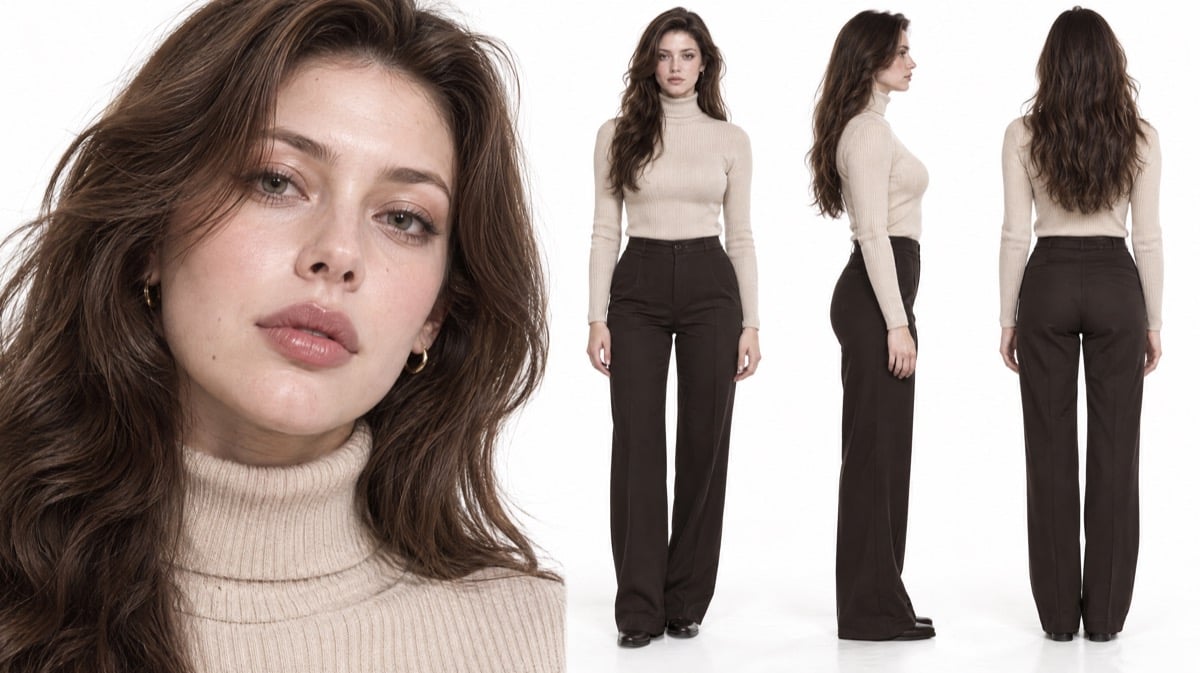
Same prompt with one clothing phrase added: 3 of 3 calls passed, with the face close-up and the front / side / back turnaround all delivered
モデレーションを low にしても解決しなかった理由
moderation パラメータ(text-to-image パラメータテーブルを参照)は、auto / low を受け付け、プロンプト側のモデレーションの厳格さを下げます。ここで low を渡しても 400 が返されたのは、ブロックが出力側で発生しており、このパラメータでは制御できないためです。
ゲートウェイの外部からは「パラメータが転送されなかった」のか「転送されたものの効果がなかった」のかを判別できませんが、どちらの場合も結論は同じです。出力側のブロックに対しては、パラメータを変更しても何も変わりません。プロンプトを変更してください。
一般チェックリスト
エラーはすぐに返ってきましたか、それとも長時間待った後でしたか?
エラーはすぐに返ってきましたか、それとも長時間待った後でしたか?
すぐに返ってきた場合はプロンプトレベル、通常のレンダリングと同程度に待った場合は出力レベルを意味します。前者の場合は、明らかに違反している単語を削除してください。後者の場合は、レンダリングを制限超過にしている要素を見つけるために単語アブレーションを実行し、同じプロンプトでもある程度ランダム性があることを想定してください。
服装をモデルに任せていませんか?
服装をモデルに任せていませんか?
雰囲気は説明していても服装を説明していないキャラクタープロンプトは、出力側のブロックの最も一般的な原因です。明示的な服装のフレーズを1つ追加するだけで、元の意図を変えずに通常は1回で解決できます。
一度に変更する単語を1つだけにしましたか?
一度に変更する単語を1つだけにしましたか?
一度に3つの単語を変更すると、どの単語が影響したのか分からなくなるため、次のプロンプトは最初からやり直しになります。バリエーションごとに1回ブロックを実行し、うまくいったものはその後2~3回再実行してください。
ブロックされたリクエストにも課金されますか?
ブロックされたリクエストにも課金されますか?
token 課金の gpt-image モデルでは、モデレーションが400を返した場合、課金されません。生成失敗については、gpt-image-2 FAQの項目を参照してください。したがって、アブレーションで必要になるのは費用ではなく時間です。
クイックリファレンス
- レイテンシーでレイヤーを特定する: 即座に返る 400 は prompt レベルです。レンダリングと同じくらい時間がかかった 400 は、出力側の分類器が画像を拒否しています。
- 出力側のブロックは確率的です: 同じ prompt が通る場合もあれば失敗する場合もあるため、1 回の結果だけでは何も証明できません。2~3 回再実行してください。
- Web アプリで通っても、API のほうが厳格とは限りません: Web アプリは prompt を書き換えて拡張し(衣服や設定を追加します)、API はそのまま送信します。
- ワードアブレーション: バリアントごとに 1 つのブロックだけを変更し、バリアントを並列で実行して、意図の変更が最も少ない編集を採用します。ここでのトリガーは「glamorous」でした。
- キャラクター prompt では衣服を具体的に記述する: それ以外をすべて変更せず、衣服に関するフレーズを 1 つ追加したところ、3 回中 3 回成功しました。
moderation: lowは出力側のブロックには何の効果もありません。