

モデルカード
価格の完全な比較、リクエストごとの課金とtokenベースの課金の違い、token選択のアドバイスについては、Nano Bananaシリーズの料金をご覧ください。
サンプル結果
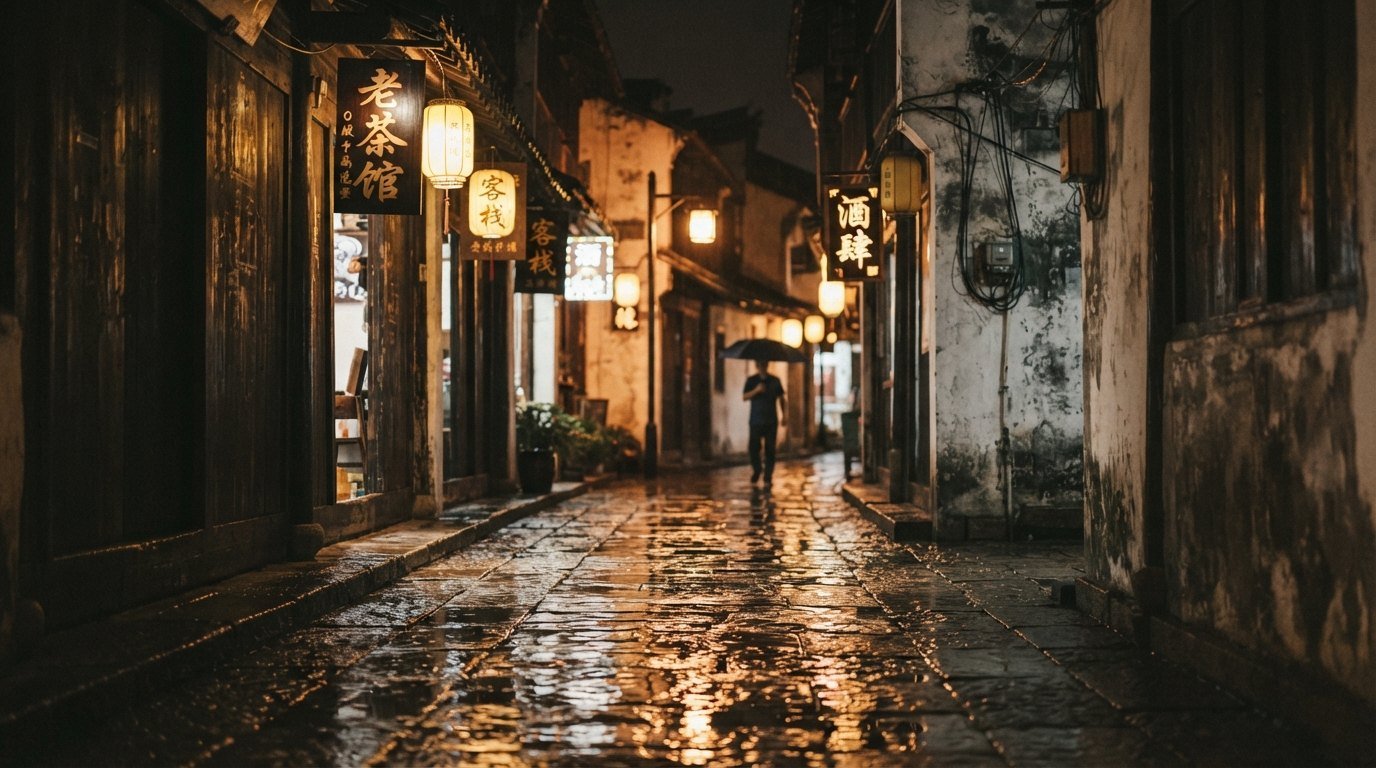
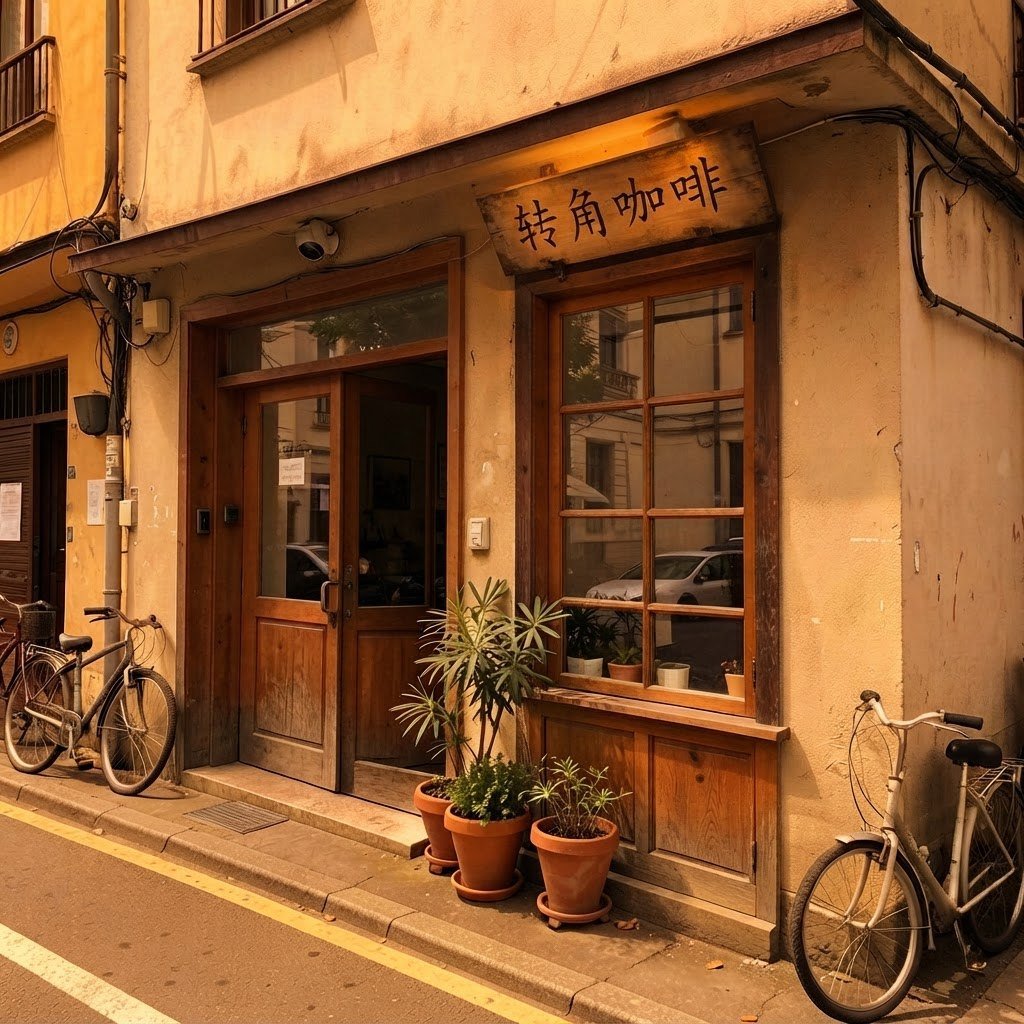
以下の2枚の画像は、Nano Banana 2 Lite(gemini-3.1-flash-lite-image)で生成したもので、テキストから画像への生成と画像編集の結果を示しています。これらはこのモデルとこれらのプロンプトのみを対象とした結果であり、シリーズ内の他のモデルの性能を保証するものではありません。
テキストから画像への生成 · 16:9の街並み(プロンプトのみ:雨上がりの古い街並みの路地、濡れた敷石に映る暖色の街灯、傘を差して歩く人、16:9の構図):8.3秒、aspectRatio: 16:9が適用され、「老茶馆」「客栈」「酒肆」と書かれた看板はすべて判読できます。
サイズの指定
- 元画像の比率に合わせる:
aspectRatioを省略するだけです。複数画像を編集する場合は、最後の画像のサイズが優先されます - 解像度
imageSize:1K/2K/4Kに対応しています- Nano Banana(第1世代)は1Kのみ対応
- Nano Banana 2は512pxに対応
- Nano Banana 2 Liteは1Kのみ対応(2K / 4K / 512pxには非対応)
統合方法
公式ドキュメント
- Google公式ドキュメント:
ai.google.dev/gemini-api/docs/image-generation - APIYIと統合するには、リクエストURL + KEYをAPIYIのものに置き換えるだけです。それ以外のパラメーターは公式のものと同じです
公式ステータスの確認(上流の問題の診断)
Nano Bananaシリーズは、GoogleのAIStudio / Gemini API上で動作します。まれに、2K / 4K出力がぼやけたり失敗したりする問題が、統合レイヤーではなくGoogle側で発生している場合があります。Googleの公式ステータスページを確認できます(自分でコピーしてアクセスしてください):aistudio.google.com/status。
たとえば、2026年6月19日、このページには「Nano Bananaに関する問題」と報告されていました。Gemini APIとAI Studio上のNano Banana 2 / Proで、2Kまたは4K解像度に問題が発生していました。同様の症状が見られた場合は、まず公式ステータスページと照らし合わせることで、上流の障害かどうかをすばやく判断できます。
APIYIでは、冗長性を確保するため、Nano BananaシリーズをAIStudio + Vertexのデュアルチャネルで提供しています。片方の公式チャネルに問題が発生した場合は、もう片方に切り替えてサービスを継続できます。
エンドポイントのサポート
- 推奨エンドポイント(Geminiネイティブ):
https://api.apiyi.com/v1beta/models/gemini-3-pro-image:generateContent - OpenAI互換モードでの呼び出しに対応しています(
/v1/chat/completions; Base64または公開リンクをimage_url経由で渡します) /v1/image/generationsには対応していません
開発形式(デフォルトの推奨)
- [推奨] Googleネイティブのエンドポイント形式を使用します
- 画像: Base64としてアップロードし、ダウンロードして再ホストします
- 呼び出し方法: 同期マルチスレッド呼び出し。非同期呼び出しにはまだ対応していません
入力画像の要件
- 単一画像は 7MB を超えられません(Google のルールです);Google Cloud Storage 経由で取り込む場合は、1ファイルあたりの上限は 30MB です
- 1 prompt あたり最大 14 枚の画像
- 対応 MIME type:
image/png,image/jpeg,image/webp,image/heic,image/heif(jpg形式はすでに APIYI でサポートされています) - Base64 のサイズ増加: 画像を Base64 に変換すると、サイズは約 33.3% 増加します(7MB の画像は約 9.3MB になります)
- APIYI の制限: 1 回のリクエストでアップロードされる画像の総量は 100MB 未満 である必要があります。すべての呼び出しは同期実行であり、過大なペイロードはメモリの急増を引き起こす可能性があります
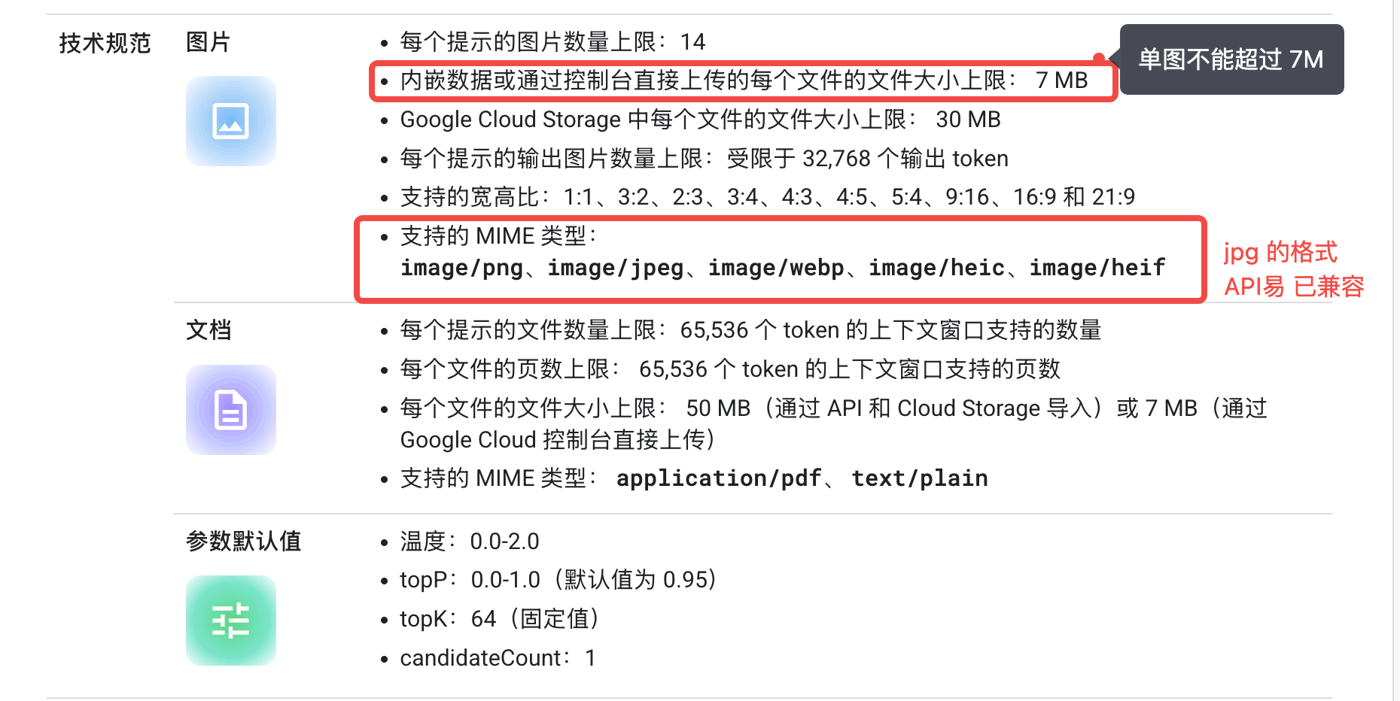
Google official technical specs: inline / console upload per-file limit is 7MB, supporting png/jpeg/webp/heic/heif
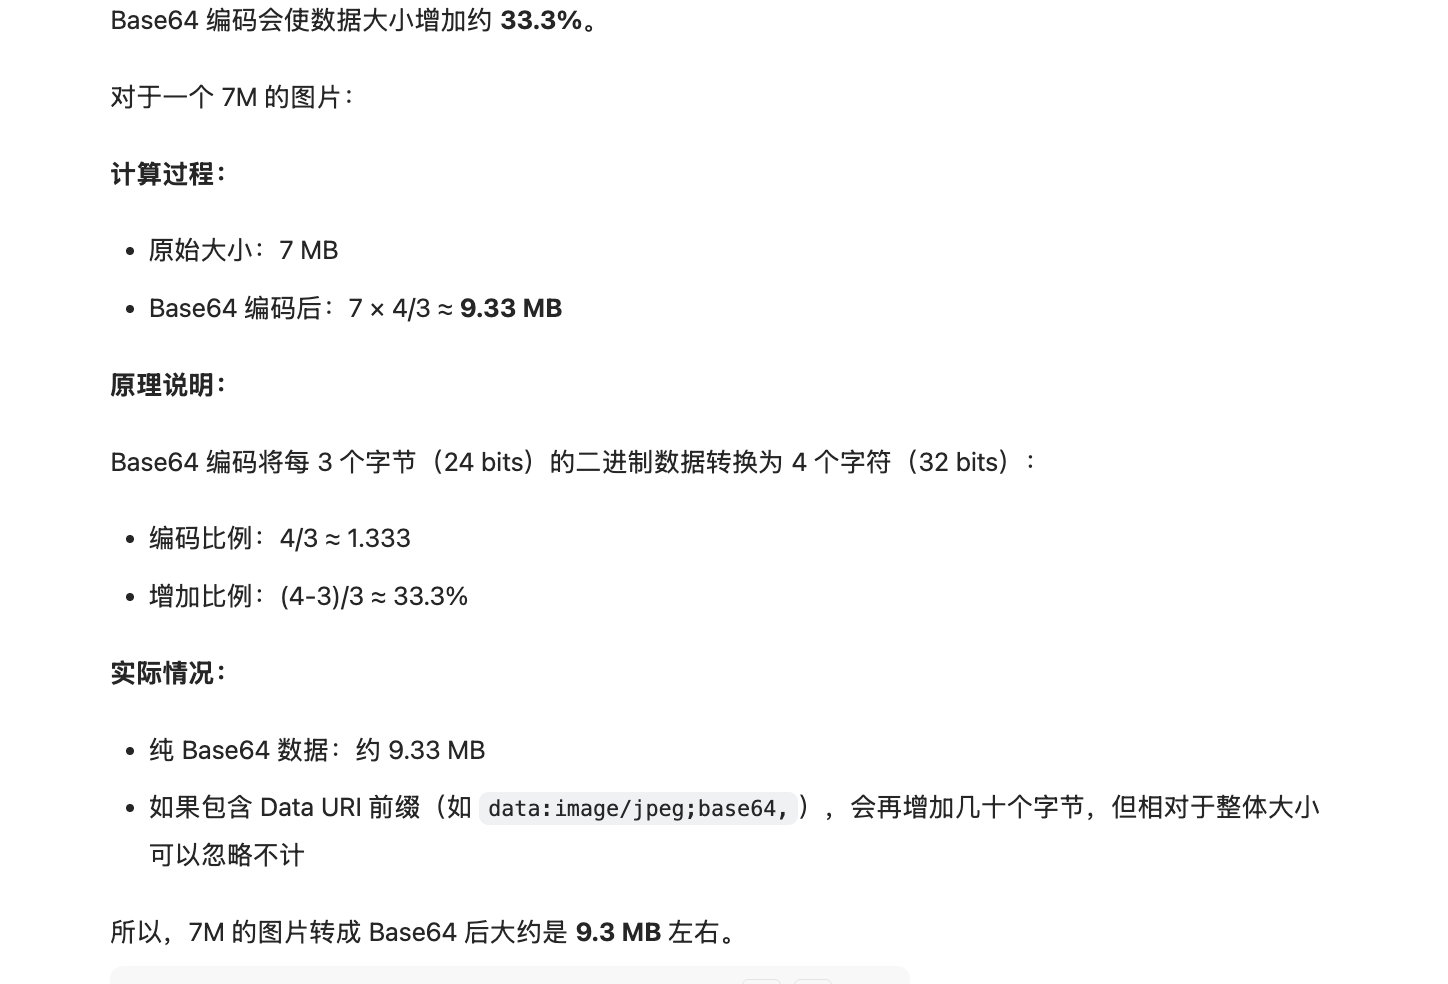
Base64 encoding increases size by about 33.3%: a 7MB image is roughly equal to 9.3MB
docs.cloud.google.com/vertex-ai/generative-ai/docs/models/gemini/3-pro-image
URL画像入力
Base64に加えて、GeminiネイティブエンドポイントはfileData.fileUriを通じて画像URLを直接受け付けます。これにより、リクエストボディを小さく抑え、自身で画像をダウンロードしてエンコードする手間を省くことができます。
URL入力の場合、APIYIではなくGoogleのサーバーが画像をダウンロードします。 正常に動作するかどうか、またその速度は、自身のブラウザでリンクが開けるかどうかではなく、Googleが画像ホストへいかに容易にアクセスできるかに依存します。以下の要件とトラブルシューティング手順は、実際のサポートチケットおよび弊社独自のテスト(2026-10-16、NB2 / Pro、3ルート)に基づいています。
利用可能なリンクの条件
テストでは、
http:// と https:// のリンクは両方とも正常に動作しました。gs://(Google Cloud Storage)は一部のルートでしか読み取れないため、APIYI 経由での利用は推奨されません。リクエスト形式
- 複数画像: 画像1枚につき1つの
fileDataを指定し、parts内に順番に並べます。inlineDataと混在させることも可能です。弊社の検証では、1回のリクエスト内に2つのURL画像と1つのBase64画像を含めた場合でも正常に生成されました mimeType: 画像の実際のフォーマットを指定してください。弊社の検証では、誤っていたり指定がなかったりしても現在のルートでは画像を読み取れましたが、この挙動には依存しないでください- フィールド名: Googleの公式ドキュメントに合わせて、キャメルケース(camelCase)の
fileData/fileUri/mimeTypeを使用してください。現在、スネークケース(snake_case)のfile_data/file_uriも受け付けられています
参照画像が実際に読み込まれたことを確認する
一部のルートでは、フェッチに失敗してもエラーが返されません。200を返し、通常どおり画像を生成して課金されますが、生成結果では指定した画像が完全に無視されます。そのため、ステータスコードだけに頼らないでください。レスポンス内のusageMetadata.promptTokensDetails を確認してください:
IMAGE エントリがある場合は画像が読み込まれたことを意味します(デフォルト設定では、Nano Banana 2 で画像1枚あたり約1120 tokens、Pro で約560 tokens を計測しました)。TEXT のみの場合は Google が画像を取得できておらず、結果にも画像は反映されません。以下の Python の例には、このチェックが含まれています。
取得失敗時の症状
タイムアウトの詳細なケーススタディについては、よく混同される空のbase64エラーについても取り上げている画像編集で「Unable to Process Input Image」が返される場合を参照してください。
Curl Example (fileUri)
Pythonの例 (fileUri)
OpenAI互換エンドポイントでURLを使用できますか?
はい、可能です。image_url として公開リンクを /v1/chat/completions で渡します。テストでは、Nano Banana 2とProの両方で画像が読み込まれ、正常に生成が行われました。同様のリンク要件が適用されます。マルチターンの編集や正確な解像度制御を行う場合は、ネイティブエンドポイントを引き続き推奨します。
課金の基本(重要)
- 同期呼び出しの所要時間: Pro / 2 の 4K では、通常、約 30〜150秒 の妥当な生成時間がかかります
- タイムアウト後の切断でも課金されます: たとえば、生成に 120秒 かかる一方で、クライアント側がタイムアウトを 100秒 に設定して切断した場合でも、課金は発生します
- 429 / 503 は課金されません: 失敗したリクエストは課金対象外です(お客様を待たせたり、画像なしのまま行き詰まらせたりしないようにしています)
- コンテンツ安全性による拒否でも課金されます: 顧客の入力にコンテンツ安全性の問題があり、Google が画像の生成を拒否した場合でも、ステータスコード 200 は課金対象です — 下記のエラー処理と保証プランをご覧ください
Google Search のグラウンディングは、1回ごとの価格に加算されます
Pro はgoogleSearch ツールをサポートしています(3/3 のテスト実行でグラウンディングが発動し、完全な groundingMetadata を返しました)。これは、天気カード、株価チャート、その他リアルタイム情報が必要なあらゆる用途に役立ちます。
ただし、検索呼び出し料金は 1回ごとの価格 $0.09 に上乗せされ、含まれていません:
Image Search のグラウンディング(
searchTypes.imageSearch)は Pro では動作しません — 0/2 回の実行で発動せず、imageSearchQueries は groundingMetadata に一度も表示されませんでした。これは Nano Banana 2(gemini-3.1-flash-image)専用です。Nano Banana 2 · 課金に影響する 3 つのパラメータ をご覧ください。thinkingLevel は Pro では効果がありません — NB2 からコピーしないでください
generationConfig.thinkingConfig.thinkingLevel は Nano Banana 2 シリーズ専用 です。Pro に high を渡しても:
- エラーにはなりません — リクエストは通常どおり 200 を返します
- しかし効果はありません: 測定された
thoughtsTokenCountは 108〜156 の範囲で、パラメータなしで見られた 130〜159 の範囲と完全に重なっていました - Pro の thinking は常に有効で、Google の公式ドキュメントにあるとおり調整できません
タイムアウト設定(重要)
4K画像生成は全体として時間がかかり、画像のアップロード、API 処理、Base64 画像のダウンロードなどの段階を含みます(当社のバックエンドは API 処理時間 に基づいて課金します)。通常の条件では、4K は(ポーリングを除いて)約 50秒 かかりますが、クライアント側のタイムアウト設定が短すぎると、生成完了前に 早期に切断 され、次のエラーが報告されます: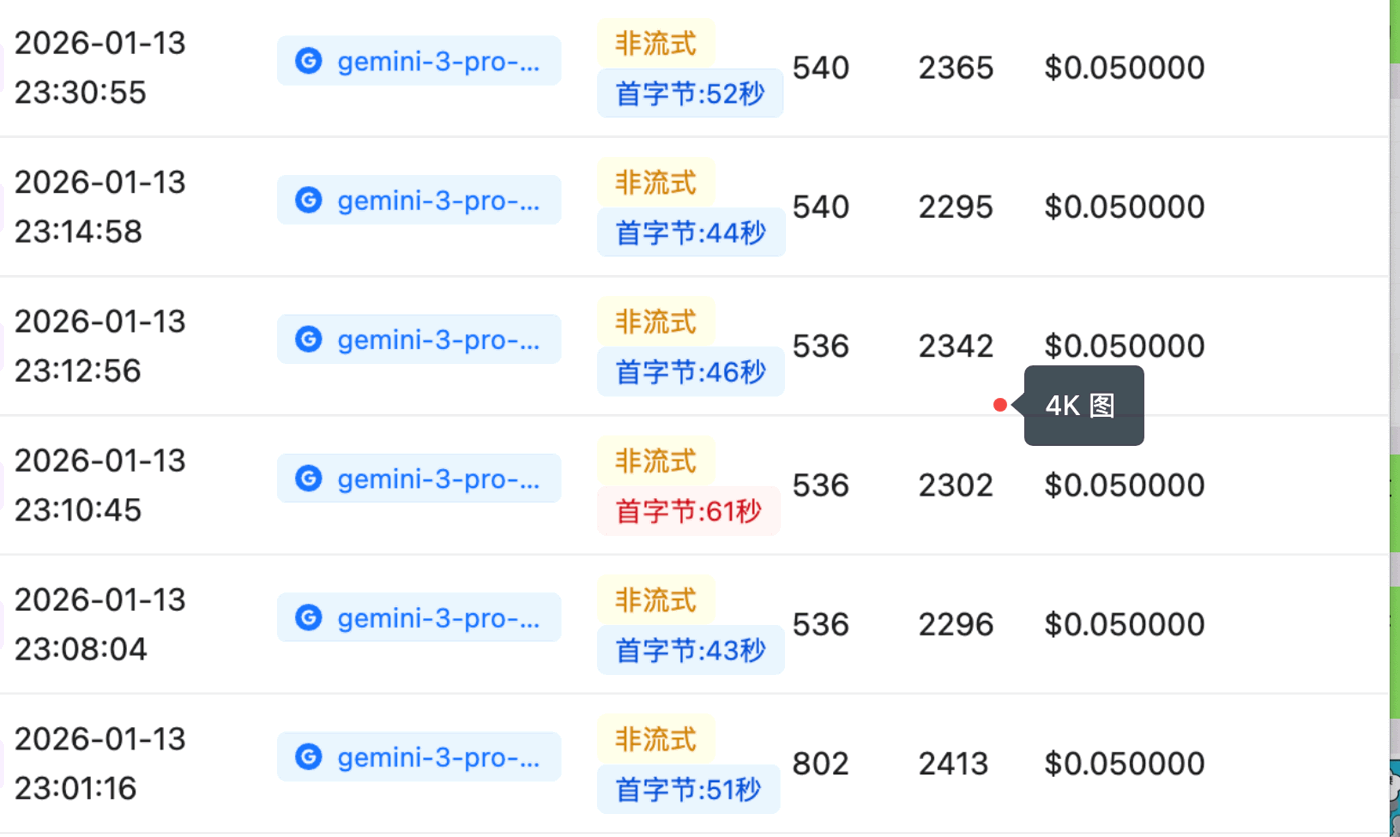
Call logs: time-to-first-byte for 4K generation is about 43–61s, so the default 120s timeout is too tight
マルチターン会話型編集(ネイティブ対応、リバースモデルは非対応)
Nano Banana シリーズはGemini ネイティブ形式を使用し、真の会話型マルチターン編集に対応しています。各ターンで生成された画像をcontentsに**role: "model" inlineDataとして追加してから、次のユーザー指示を送信します。モデルは会話履歴全体に基づいて編集し、変更を積み重ねていきます**(例:まずソファの色を変え、次にアクセサリーを追加すると、先に行った変更が維持されます)。
これは「リバース」画像モデルとは根本的に異なります。統合する前に、この違いを明確に把握してください。
テストでは、前の画像を
modelロールのターンとして追加すると、Nano Banana 2(gemini-3.1-flash-image)は正しく編集を続け、変更を積み重ねられることを確認しました。一方、リバースモデルは最後のユーザーメッセージの参照画像のみを読み取るため、会話履歴を保持してもマルチターン編集には対応できません。contentsに追加します):
画像を取得するには parts を必ず反復処理する — インデックス参照はしない
parts は 異種配列 です。画像セグメントだけを含むこともあれば、テキストと画像セグメントが交互に入ることもあり、長さも順序も保証されません。したがって、parts[0] / parts[1] のようなハードコードされたアクセスは、断続的に必ず失敗します。
テストでは、次の 3 つの構成が確認されています。
テキストセグメントが発生する理由は 1 つではありません。
TEXT を responseModalities に含める場合も、モデルに自己説明させるような prompt でも、画像と一緒にテキストが返されます。そして、そのテキストが画像の前後どちらに来るかも固定ではありません。つまり、画像が入るインデックスは一定ではありません。そのため、同じコードでもリクエストごとに異なる構造を受け取ることがあります。
正しい方法は、位置ではなくフィールドの形状で選択することです。最初の inlineData ではなく、最後の inlineData を取ることに注意してください。複雑なタスクでは複数の画像が返され、最後のものが最終版です(次のセクションを参照):
レスポンスに複数の画像が含まれることがあるのはなぜですか
gemini-3-pro-image を呼び出すと、まれに 1 回のレスポンスに複数の画像パートが含まれる(テストでは 2〜10 件を確認)ことがあり、ログに散発的に 6000+(極端な場合は 5 桁)output-token エントリが記録されることがあります。これは異常ではありません。Google の公式ドキュメントでは、Gemini 3 の画像モデルはデフォルトで「Thinking」が有効(API では無効化できない)で、モデルは構図とロジックを検証するために途中の画像を生成し、これらの下書きは最終版と並んで parts に表示され、さらに「Thinking 内の最後の画像が、最終的にレンダリングされる画像でもある」(公式ドキュメント: ai.google.dev/gemini-api/docs/image-generation)とされています。2026 年 7 月に実施したテスト(Google ネイティブgenerateContent形式)に基づくと:
トリガーは prompt のタスクの複雑さ であり、「画像編集」そのものではありません。複数の画像は依然として 1 つの候補(複数の候補ではありません)内にあり、各画像は完全な画像です。つまり、同じデザイン(同じ構図で、細部が少しずつ異なる)の連続した下書きであり、最後のパートが最終版 です。これらの下書きは通常の画像パートとして返されます(
thoughtSignature フィールドはありますが、thought: true フラグはありません)。Google のドキュメントでは Thinking は最大 2 枚の途中画像を生成するとされていますが、複雑なタスクでは最大 10 枚を確認しました。
課金への影響: 各画像は固定の token 数で課金されます(1K/2K 解像度では画像 1 枚あたり 1120 token、4K では 2000 token)ので、output token は画像数に比例して厳密に直線的に増加します。ログに散発的に 6000+(極端な場合は約 13.5k)と記録されている output-token エントリは、単に 4〜10 枚の画像レスポンスであり、課金の異常ではありません。
推奨する後続コード:
- 常にパートを順に処理する — 1 回のレスポンスにつき 1 画像と決めつけないでください。画像ごとのカウントや保存ロジックは、実際のパート数に基づいて行う必要があります
- 1 枚だけ必要な場合は最後の画像を使う: 先頭の下書きは細部が未完成で品質もわずかに低いため、最初の画像は使わないでください
- prompt で画像枚数を制御するのはほとんど効果がありません(テストでは「1 枚だけ出力して」という指示は無視されました)— コード側で処理してください
- 複数画像のレスポンスは 35〜142 秒かかります(1K 解像度で、画像数が多いほど長くなります)。単一画像のレスポンスよりかなり長いです — 上記のタイムアウト推奨(5 分以上)を維持してください
よくある質問
エラー処理ガイド
生成失敗、コンテンツモデレーションポリシー、親しみやすい prompt 戦略を診断するための3つの重要な指標
必読の開発者向けよくある質問
生成失敗のトラブルシューティングとよくある質問
生成失敗保証プラン
入力に起因しない失敗については、失敗したリクエスト数に応じてクレジットを返還します
なぜ connection reset by peer / write_response_body_failed (500) が発生するのですか?
なぜ connection reset by peer / write_response_body_failed (500) が発生するのですか?
完全なエラーは次のようになります:これは通常、画像アップロードのサイズが大きすぎることが原因です — リクエストボディが大きくなりすぎて接続が切断されます。以下のベストプラクティスに従ってください。
- 画像数を制限する: 公式ルールの範囲内に収めてください(prompt あたり最大14枚 — 上記の公式仕様を参照してください)。
- 画像1枚あたりのサイズを制限する: 画像1枚ごとに5MB未満にしてください — 公式の1枚あたり上限は7MBで、base64 エンコーディングによりサイズは約3分の1増加するため、余裕を持たせてください。
- アップロード前にフロントエンドで圧縮する: API に送信する前に、フロントエンド(またはサーバーサイドのリレー)で画像を圧縮してください — 一般的には、長辺を制限し、JPEG/WebP に変換し、品質パラメータを調整します。
- URL入力に切り替える: Gemini のネイティブ形式では、
fileData.fileUriを介して画像 URL を渡せるため、大きすぎる base64 のリクエストボディを完全に回避できます — 上記の URL画像入力 を参照してください。
利用例
- AI チャットクライアント: Cherry Studio などのクライアントを、APIYI 経由で直接画像を生成するように設定できます
- 生成テスト: チャットクライアントまたはコンソールでモデルの性能をすばやく確認できます
高度なニーズ
- URL経由で画像をアップロードしたいですか? Gemini ネイティブエンドポイントでは
fileData.fileUriを、OpenAI 互換エンドポイントではimage_urlを使用します。Google のサーバーが画像をダウンロードするため、ホスト環境が重要になります。リンク要件、取得失敗の検知方法、およびコード例については、上記のURL画像入力を参照してください。 - (Base64 ではなく)ダウンロード URL を直接取得したいですか? NB-OSS グループをご利用ください — 詳細はNano Banana OSS グループを参照してください。