

Обзор
Grok Imagine 2 — это новейшая модель генерации изображений второго поколения от xAI, представляющая собой полноценный шаг вперед по сравнению с первым релизом как в контроле параметров, так и в редактировании: соотношение сторон и разрешение действительно применяются, доступен уровень 2K, один вызов возвращает до 10 изображений, а редактирование по референсу по-настоящему сохраняет исходное изображение. APIYI предлагает два варианта:grok-imagine-image (стандартный) и grok-imagine-image-quality (высокое качество). Оба используют одни и те же эндпоинты и параметры — они различаются только детализацией результата и ценой.
2. Продукт называется Grok Imagine 2, но имена моделей для вызова — grok-imagine-image и grok-imagine-image-quality. Не указывайте grok-imagine-2-image: такой модели не существует, и запрос вернет 503.API генерации изображений по тексту
API редактирования изображений
Доверьте интеграцию ИИ-агенту
Скопируйте этот prompt и вставьте его в Codex / Claude Code / Cursor
Сначала он загрузит текстовую версию этой страницы (добавьте .md к любому URL документации), а затем напишет код под стек вашего проекта: таймаут, немедленное сохранение URL-результатов в свое хранилище, эндпоинт, который незаметно отбрасывает референсные изображения, но всё равно списывает средства, а также тот факт, что size ничего не делает, — всё это уже заложено в требования.
Выполните интеграцию / устранение неполадок Grok Imagine 2 (генерация изображений по тексту и редактирование изображений) в этом проекте.
Прежде чем писать код, изучите документацию: запросите https://docs.apiyi.com/en/api-capabilities/grok-imagine-image/overview.md для получения текстовой версии этой страницы. Для более подробной информации о параметрах добавьте
.md…
- Названия моделей: стандартный уровень —
grok-imagine-image, а уровень высокой детализации —grok-imagine-image-quality. Обратите внимание, что идентификатор модели не содержит ц …
Всего 9 требований. Используйте кнопку ниже, чтобы скопировать полный prompt.
От каких проблем защищает этот prompt
От каких проблем защищает этот prompt
Почему Grok Imagine 2 на APIYI
Формат, совместимый с OpenAI
/v1/images/generations и /v1/images/edits эндпоинты. Тела запросов и поля ответов совпадают с OpenAI Images API, поэтому официальный OpenAI SDK работает напрямую — без усилий по миграции.Без ограничений на параллельные запросы
Фиксированная цена, предсказуемая стоимость
Глобальный доступ без барьеров
api.apiyi.com.Полная экосистема моделей
Профессиональная поддержка
Ключевые особенности
Два уровня разрешения
1k — около 1 мегапикселя, 2k — 4,2–4,5 мегапикселя (2816x1584 при соотношении сторон 16:9): цена одинаковая, поэтому 2K выгоднее5 соотношений сторон
1:1 / 16:9 / 9:16 / 4:3 / 3:4; фактические размеры в пикселях точно соответствуют заявленнымДо 10 изображений за запрос
n принимает от 1 до 10 изображений и возвращает их одним запросом — идеально для пакетного отбораБыстрая генерация
Точное редактирование по референсу
Объединение нескольких изображений
Два формата ответа
url прямые ссылки или b64_json исходные данные base64 поддерживаются обоими эндпоинтамиСовместимость с OpenAI SDK
client.images.generate() и client.images.edit() работают сразу — настройка HTTP вручную не требуетсяПримеры результатов
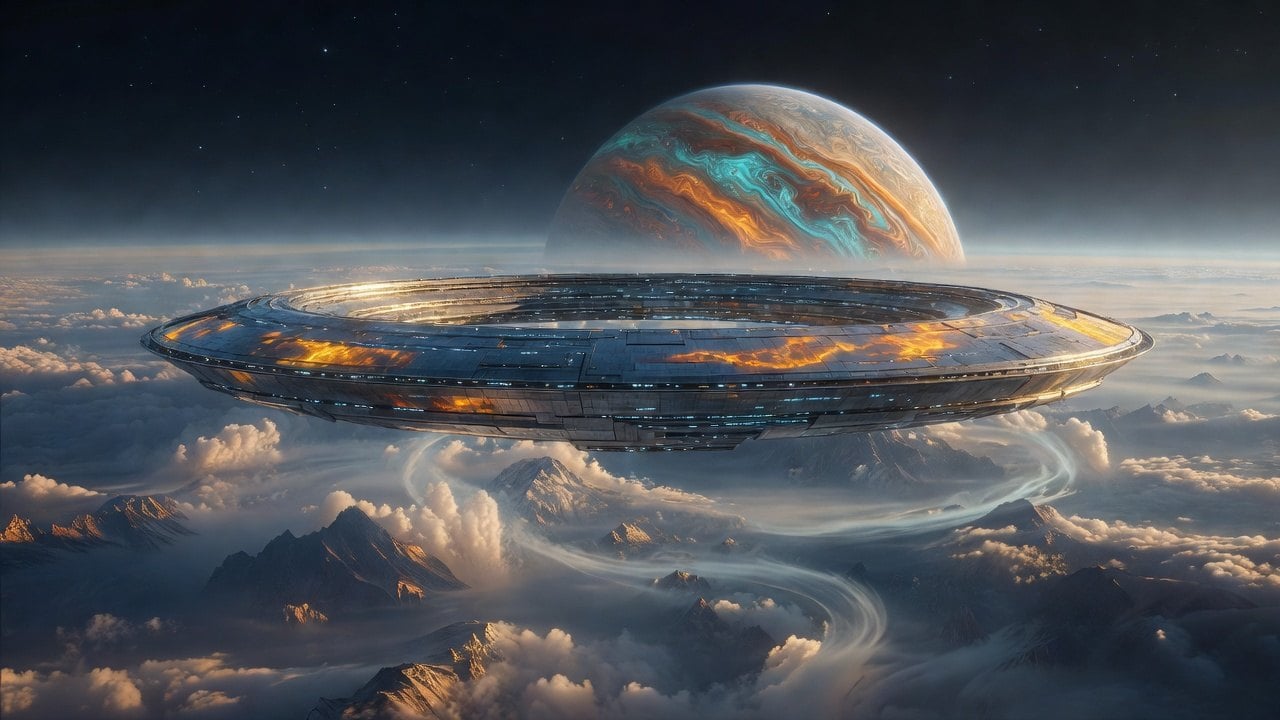
Преобразование текста в изображение · научно-фантастическая сцена (grok-imagine-image; только промпт: кольцевая обсерватория парит над морем облаков, её металлический корпус отражает золотистый свет заката, вдали видна гигантская газовая планета, широкоформатная композиция): 10,5 с; выразительные отражения на металле, убедительный объём облаков, цельная и хорошо проработанная композиция.
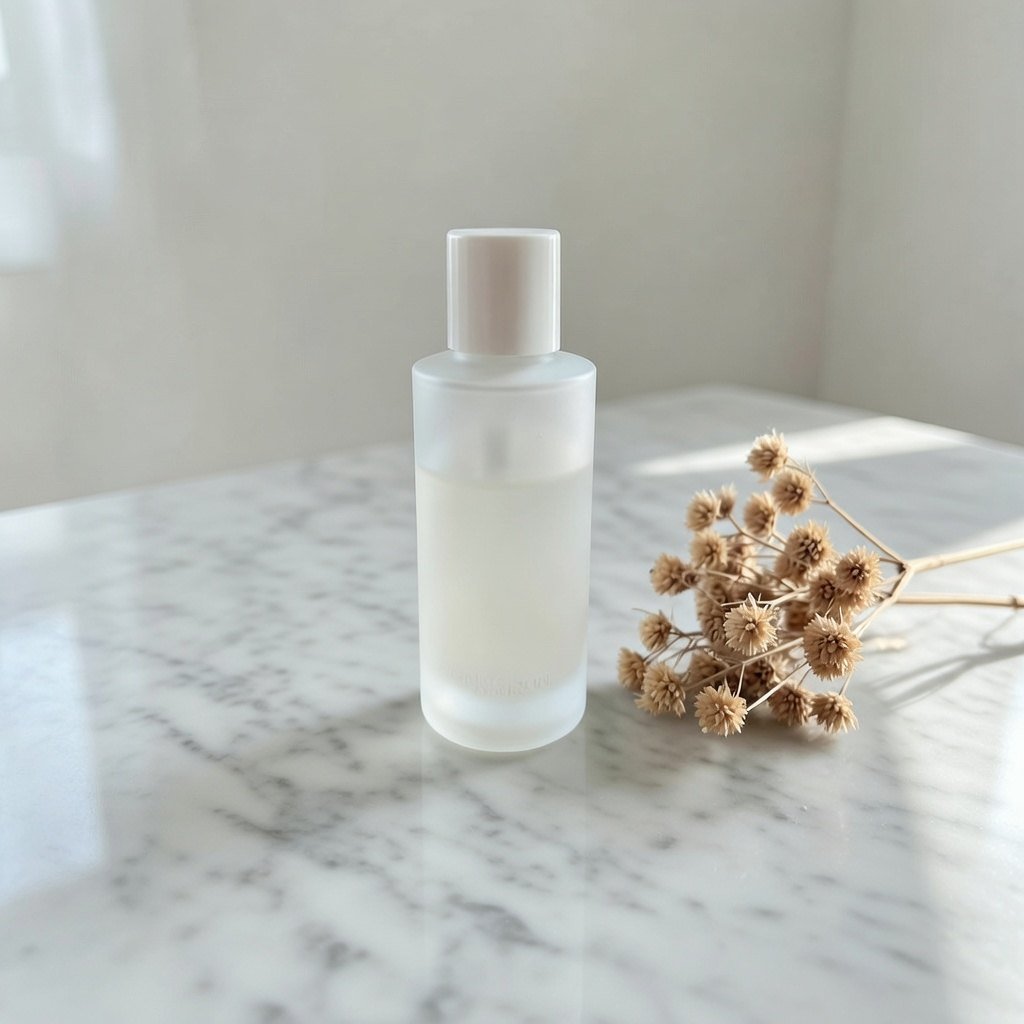
grok-imagine-image; на референсе флакон средства по уходу за кожей на деревянном столе, промпт: замените дерево белой мраморной столешницей, оставив флакон и сухие цветы без изменений): 13,9 с; прожилки мрамора соответствуют направлению света из окна, контур флакона и форма цветов не искажены — среди рассматриваемых семейств здесь лучше всего сохранён объект.
Цены
- Мы игнорируем разрешение; xAI — нет. У xAI уровень качества указан по $0.05 для 1K и $0.07 для 2K, тогда как APIYI взимает фиксированные $0.045 — поэтому чем выше разрешение, тем больше экономия, достигающая примерно 64% от прайс-листа на 2K.
- За изображение:
n=4тарифицируется как 4 изображения, независимо от длины prompt. - Редактирование стоит столько же, сколько и text-to-image — для
/v1/images/editsне предусмотрена наценка. - Блок
usageнельзя использовать для сверки:prompt_tokensвсегда1000 x n, это заполнитель. Вместо этого используйте записи тарификации в консоли.
Эффективная стоимость с бонусами за пополнение
Эти скидки суммируются с многоуровневым бонусом за пополнение (рассчитывается для каждого отдельного пополнения, а не суммарно). Если брать уровень качества 2K:Настройка группы
Об имени группы: в консоли эта группа отображается какGrok_imagine_Reverse (ранее Grok_imagine). Для Tokens, у которых уже есть доступ, изменений не требуется — тарификация и вызовы остаются без изменений.
Почему отдельная группа: политика безопасности контента этого семейства существенно отличается от других моделей на платформе, и некоторые категории не фильтруются. Чтобы снизить комплаенс-риски, мы не включаем его в группу по умолчанию, доступную всем аккаунтам, а предоставляем доступ выборочно.
Кто может получить доступ
Как подать заявку
Свяжитесь со службой поддержки WeCom
Опишите ваш сценарий использования и механизмы модерации
Переключите свой Token на эту группу
Grok_imagine_Reverse для вашего аккаунта. Перейдите на страницу Token в консоли и переключите Token, используемый для этого семейства, на Grok_imagine_Reverse, указав модель тарификации Pay-as-you-go Priority или Pay-per-request.Grok_imagine_Reverse возвращает 503 (нет доступного канала в текущей группе). Повторные попытки не помогут — сначала необходимо активировать группу.Рекомендуемая модель тарификации Token: Pay-as-you-go Priority. Это семейство тарифицируется за каждый запрос, и маршрутизация работает корректно как для «Pay-as-you-go Priority», так и для «Pay-per-request» — при выборе «Pay-as-you-go Priority» один и тот же Token можно использовать и для моделей с тарификацией по token на остальной части платформы.Технические характеристики
Эндпоинты
Миграция с GPT-Image-2
Если вы уже интегрировали GPT-Image-2, эндпоинты и соглашение о вызовах идентичны (/v1/images/generations + /v1/images/edits, совместимо с OpenAI SDK), однако система параметров отличается, поэтому простая замена имени модели не сработает. Ниже описано, что необходимо изменить.
Сопоставление параметров
В таблице GPT-Image-2 используется в качестве основы;gpt-image-2.5-flare / gpt-image-2.5-sunburst используют те же параметры, поэтому сопоставление применимо и к ним.
Три самые распространённые ошибки
До и после
Ключевые параметры
aspect_ratio и resolution (размер вывода)
Вместе они определяют фактическое количество пикселей вывода. Измеренные значения точно соответствуют запросу:
aspect_ratio (например, 5:7, 21:9) или resolution (например, 1K, 1024x1024) молча откатываются к значению по умолчанию и всё равно возвращают image. Неверный response_format аналогично откатывается к url. Поэтому, если результат не соответствует ожиданиям, сначала проверьте написание параметров.Единственное исключение — resolution: "4k", который возвращает 503 model_service_unavailable. Это означает, что уровень не поддерживается, а не что канал недоступен — переключитесь обратно на 1k / 2k.n (изображений за вызов)
Принимает 1-10; длина возвращаемого массива data равна n, и каждое image тарифицируется. 0 молча интерпретируется как 1; 11 или выше возвращает 400.
Лучшие практики
Сразу решите: генерация или редактирование?
/v1/images/generations. Любое опорное изображение, даже для изменения на один пиксель → /v1/images/edits. Если выбрать неверный эндпоинт, ошибки не будет — только неожиданное изображение.Установите тайм-аут клиента на 360 секунд
Контролируйте композицию с помощью aspect_ratio, а не prompt
aspect_ratio: "16:9" гораздо надёжнее, чем просить в prompt «пейзажную композицию».Выбирайте уровень разрешения с учётом пропускной способности
Говорите «оставьте всё остальное без изменений» при редактировании
Явно указывайте изображения при объединении
image[] — это то, что означает «изображение 1 / изображение 2 / изображение 3». Формулировка «поместите объект из изображения 1 в сцену из изображения 2» гораздо надёжнее, чем позволять модели угадывать.Не полагайтесь на seed для воспроизводимости
seed; один и тот же prompt даёт разные результаты при разных вызовах. Сохраняйте изображения, которые хотите оставить, вместо того чтобы ожидать их повторной генерации.Просто используйте параллельную обработку для пакетных задач
Коды ошибок и повторные попытки
400 и 415 детерминированы — повторять запросы бессмысленно, вместо этого отправляйте оповещение. Повторять запросы имеет смысл только для 429 и таймаутов сетевого уровня, используя экспоненциальную задержку и максимум 3 попытки.Обратите внимание, что 400 invalid_request охватывает как «неверный параметр», так и «контент заблокирован», причем по телу ответа их различить невозможно. Практический эвристический метод — оценка задержки: блокировки модерации возвращаются примерно за 5–6 секунд (быстрее успешной генерации, занимающей ~9 с), поскольку блокировка происходит до начала генерации.Часто задаваемые вопросы
Каждый вызов возвращает 503 — канал недоступен? Как получить доступ?
Каждый вызов возвращает 503 — канал недоступен? Как получить доступ?
resolution: "4k" означает, что данный уровень не поддерживается (см. пункт ниже). Если параметры в порядке, а 503 возвращается постоянно, то у token практически наверняка отсутствует группа Grok_imagine_Reverse.Это семейство моделей недоступно по умолчанию: его политика безопасности контента существенно отличается от других моделей на платформе, и некоторые категории не фильтруются. Поэтому для снижения регуляторных рисков мы выделили его в отдельную группу Grok_imagine_Reverse и предоставляем доступ выборочно. Действующие клиенты с суммарными расходами от $1,000+ могут запросить подключение, описав свой сценарий использования службе поддержки; всем остальным необходимо подать заявку через поддержку WeCom с описанием сценария использования и применяемых мер модерации контента.Полная инструкция приведена выше в разделе Настройка группы.Почему отправка JSON на /v1/images/edits возвращает 400, если в документации провайдера указан JSON?
Почему отправка JSON на /v1/images/edits возвращает 400, если в документации провайдера указан JSON?
multipart/form-data, в то время как в исходной документации провайдера описано тело JSON с публичным URL изображения. Они различаются — ориентируйтесь на документацию нашего сайта.Корректный формат — загрузка файла:Я отправил референсное изображение в генерацию по тексту и получил 200, но результат никак с ним не связан?
Я отправил референсное изображение в генерацию по тексту и получил 200, но результат никак с ним не связан?
/v1/images/generations молча игнорирует image / image_url / images, генерирует изображение исключительно по prompt и тарифицирует запрос в обычном режиме.Из-за отсутствия ошибки легко сделать ложный вывод, что «редактирование не работает». Любой рабочий процесс с референсным изображением должен использовать /v1/images/edits.Почему resolution / aspect_ratio не влияют на эндпоинт редактирования?
Почему resolution / aspect_ratio не влияют на эндпоинт редактирования?
resolution или aspect_ratio в данном случае не вызывает ошибки, но ни на что не влияет.Чтобы изменить размер выходного изображения, кадрируйте или измените размер референсного изображения перед загрузкой.Почему в ответе нет поля revised_prompt?
Почему в ответе нет поля revised_prompt?
revised_prompt, а также такие поля, как respect_moderation или model. Каждый элемент data[] содержит либо url, либо b64_json в зависимости от response_format — но никогда оба одновременно.Не рассчитывайте на наличие этих полей при парсинге ответов.Можно ли сверить тарификацию по количеству token в usage?
Можно ли сверить тарификацию по количеству token в usage?
usage.prompt_tokens всегда равно 1000 x n независимо от фактической длины prompt — это плейсхолдер.Это семейство тарифицируется за запрос по фиксированной ставке за каждое изображение. Для проверки фактических списаний используйте записи о тарификации в консоли APIYI.Почему разрешение 1K возвращается в формате JPEG, а 2K — в PNG? Их размеры сильно отличаются
Почему разрешение 1K возвращается в формате JPEG, а 2K — в PNG? Их размеры сильно отличаются
resolution: 1k возвращает JPEG (~220–300 КБ), а resolution: 2k — PNG без потерь (~5–6 МБ), разница примерно в 20 раз.Расширение в URL, HTTP-заголовок Content-Type и фактические байты согласованы между собой, поэтому вы можете безопасно ветвить логику по Content-Type.Для сценариев, чувствительных к пропускной способности сети (мобильные устройства, массовая передача), отдавайте предпочтение 1k — оба уровня стоят одинаково, поэтому выбор зависит исключительно от требований к качеству. И наоборот, если вам нужно качество, 2k не требует доплаты и предоставляется со значительно большей скидкой относительно базовой цены.Параметр resolution: 4k возвращает 503 — канал недоступен?
Параметр resolution: 4k возвращает 503 — канал недоступен?
4k не поддерживается в этом семействе моделей, и шлюз возвращает 503 model_service_unavailable. Код ошибки выглядит как сбой канала, но на самом деле проблема в параметре, поэтому повторные попытки не помогут — вернитесь к 1k или 2k.Поддерживаются только 1k и 2k.Почему неверные параметры приводят к генерации некорректного изображения вместо ошибки?
Почему неверные параметры приводят к генерации некорректного изображения вместо ошибки?
aspect_ratio (например, 5:7), resolution (например, 1K, 1024x1024) и response_format (например, base64) молча сбрасываются до значений по умолчанию и возвращают изображение вместо ошибки 400.Поэтому, если результат не соответствует ожиданиям, сначала проверьте написание параметров — в частности, значения resolution должны быть в нижнем регистре: 1k / 2k.Сколько изображений можно получить за один вызов?
Сколько изображений можно получить за один вызов?
n принимает значения от 1 до 10, а длина возвращаемого массива data равна n. Каждое изображение тарифицируется.Значение 0 неявно интерпретируется как 1; передача 11 или больше возвращает 400 invalid_request.Поддерживается ли воспроизводимость результатов с помощью seed?
Поддерживается ли воспроизводимость результатов с помощью seed?
seed не вызывает ошибки, но ни на что не влияет: один и тот же prompt с тем же seed при повторных вызовах будет возвращать разные изображения.Сохраняйте изображение, если оно может понадобиться в дальнейшем, вместо попыток сгенерировать его заново.Можно ли вызывать это через официальный SDK OpenAI?
Можно ли вызывать это через официальный SDK OpenAI?
base_url на https://api.apiyi.com/v1:aspect_ratio и resolution не являются стандартными полями SDK OpenAI, поэтому передавайте их через extra_body.Есть ли ограничения на параллельные запросы? Будет ли замедляться пакетная генерация?
Есть ли ограничения на параллельные запросы? Будет ли замедляться пакетная генерация?
timeout: API генерации изображений синхронны, поэтому задайте таймаут клиента на уровне 360 секунд, чтобы не прерывать запросы, которые все еще штатно обрабатываются (и за которые по-прежнему списывается плата).Как работает модерация контента и как распознать блокировку?
Как работает модерация контента и как распознать блокировку?
400 invalid_request с точно таким же кодом ошибки и сообщением, как при ошибке в параметрах, поэтому по телу ответа различить их невозможно.Практический ориентир — это время задержки: блокировки модерации возвращаются примерно через 5–6 секунд (проверка выполняется до генерации), тогда как успешная генерация изображения занимает около 9 секунд. Результаты модерации также содержат элемент случайности, поэтому пограничный контент может обрабатываться по-разному при повторных попытках — не делайте выводов на основе одного запроса.Если параметры проверены и корректны, а ошибки 400 продолжают возникать, вероятнее всего, prompt был заблокирован модерацией; скорректируйте формулировку.Можно ли генерировать изображения через /v1/chat/completions?
Можно ли генерировать изображения через /v1/chat/completions?
content представляет собой ссылку на изображение в формате markdown:/v1/images/generations и /v1/images/edits) — здесь доступен более широкий набор параметров, более стабильная структура ответа и полное соответствие данной документации.Связанная документация
- Grok Imagine 2 Текст-в-изображение API - справочник по эндпоинту с Playground
- Grok Imagine 2 Редактирование изображений API - справочник по редактированию и объединению нескольких изображений
- Руководство по модели Grok - текстовые модели xAI
- Лучшие практики Image API - тайм-ауты, разрывы соединения, сжатие
- Руководство по API
- Акции на пополнение