

Обзор
На этой странице рассматривается серия GPT-Image 2.5 / 2 от OpenAI через официальный релей APIYI:gpt-image-2.5-flare (с приоритетом скорости), gpt-image-2.5-sunburst (с приоритетом качества и точности редактирования) и gpt-image-2 предыдущего поколения. Модели 2.5 выпущены 2026-09-08 и обеспечивают более высокое качество по сравнению с gpt-image-2, более точное редактирование и два новых уровня quality (xhigh / max) при абсолютно тех же цене и параметрах, что и у gpt-image-2. Для всей серии общими являются: любое допустимое разрешение (включая 2K / 3840×2160 4K), автоматическое высокоточное качество при работе с эталонными изображениями, тарификация по token. Шлюз APIYI полностью совместим с API изображений OpenAI — укажите base_url официального SDK OpenAI здесь для прямого подключения без изменений в коде.
xhigh / max в версии 2.5. Оптимально для производственных сценариев, требующих точного управления размером и качеством, полной совместимости с официальным API OpenAI или вывода в 4K; по умолчанию для преобразования текста в изображение используйте gpt-image-2.5-flare, а для редактирования — gpt-image-2.5-sunburst.API преобразования текста в изображение
/v1/images/generations — генерация изображений из текстовых промптов с управлением размером, качеством и output_format.API редактирования изображений
/v1/images/edits — загрузка эталонных изображений в формате multipart (до 16 изображений) и инструкций по редактированию или объединению с поддержкой дорисовки по маске.Доверьте интеграцию ИИ-агенту
Скопируйте этот prompt и вставьте его в Codex / Claude Code / Cursor
Сначала он загрузит текстовую версию этой страницы (добавьте .md к любому URL документации), а затем напишет код под стек вашего проекта — четыре самые частые ошибки (тайм-аут, рендеринг base64, сжатие при загрузке, уровень качества) уже учтены в требованиях.
Выполните интеграцию / устранение неполадок генерации изображений по тексту и редактирования изображений серии GPT-Image 2.5 в этом проекте: используйте
gpt-image-2.5-flareдля генерации по тексту иgpt-image-2.5-sunburstдля редактир …Прочитайте документацию перед тем, как писать код: получите текстовую версию этой страницы по адресу https://docs.apiyi.com/en/api-capabilities/gpt-image-2/overview.md. Для более подробной информации о параметрах добавьте
.mdк …
- Тайм-аут: увеличьте тайм-аут клиента до 360 секунд. API генерации изображений синхронны — здесь нет ID задачи, поэтому при отключении клиента результат теряется …
Всего 7 требований. Используйте кнопку ниже, чтобы скопировать весь prompt.
От каких проблем избавляет этот prompt
От каких проблем избавляет этот prompt
Почему стоит выбрать официальный релей GPT-image-2 от APIYI?
Построен на базе официального канала OpenAI и глубоко оптимизирован для корпоративных рабочих нагрузок в продакшене по параметрам надежности, стоимости и удобства интеграции:Официальный канал · Идентично официальному
Без ограничений на параллельные запросы
Та же цена + скидка до 15%
Глобальный доступ без барьеров
api.apiyi.com из локальных дата-центров, домашнего интернета или зарубежных узлов — стабильная задержка, никакой трансграничной перестройки архитектуры.Полная линейка моделей
gpt-image-2-all (фиксированная цена $0.025/изображение) или на лидера по стоимости Nano Banana Pro / 2 — комбинируйте под свои сценарии.Профессиональная корпоративная поддержка
Выбор модели: flare / sunburst / gpt-image-2
С 2026-09-08 эта группа документации охватывает три модели OpenAI GPT-Image 2.5 / 2. Все три используют одинаковые цены, параметры, группы и эндпоинты; переключение выполняется изменением одного поляmodel:
Основные возможности
Любое разрешение (вкл. 4K)
Автоматическая высокая точность
input_fidelity (иначе будет ошибка).На 20-30% дешевле
Китайский + рендеринг текста
high.Слияние нескольких изображений (до 16)
image[] массив принимает до 16 референсных изображений. Используйте «image 1 / image 2 / image 3» в prompt, чтобы сослаться на них по порядку загрузки.Маскирование inpainting
Несколько форматов вывода
output_compression для jpeg/webp, чтобы управлять размером файла.Прямой доступ через OpenAI SDK
base_url на https://api.apiyi.com/v1 и вызывайте напрямую с официальным OpenAI SDK — миграция без кода.Тарификация
gpt-image-2.5-flare / gpt-image-2.5-sunburst / gpt-image-2 APIYI (группа по умолчанию) используют единый прайс-лист, который в точности соответствует официальным тарифам OpenAI — скидка предоставляется за счёт нашего бонуса за пополнение: пополните счёт на $100 и получите бонус 10%, вплоть до 20%. 📖 Подробнее об акциях пополнения.
Тарификация по количеству token (как в прайс-листе OpenAI)
Token-metered — один запрос = токены входного текста + входного изображения + выходного изображения:Справочник стоимости за изображение (официальная таблица, gpt-image-2)
Типичная стоимость одного изображения дляgpt-image-2 при предустановленных размерах 1K (модели 2.5 используют другое количество tokens для тех же названий уровней; см. следующий раздел):
- Цены за единицу соответствуют прайс-листу OpenAI; добавьте бонус за пополнение (10% при пополнении на $100, до 20%), и итоговая стоимость будет ниже, чем при прямой оплате
- Для 2K / 4K нет фиксированной цены за изображение — тарификация выполняется по фактическому количеству входных и выходных tokens
- Запросы на редактирование имеют заметно больше входных tokens, чем преобразование текста в изображение, из-за принудительного режима высокой точности
- Потоковая передача (
stream: true+partial_images: N) стоит дополнительно 100 выходных tokens изображения за каждый частичный результат - По сравнению с
gpt-image-1.5при одинаковых размере и качестве,gpt-image-2примерно на 20–30% дешевле
Уровни качества и измеренная стоимость для моделей 2.5 (измерено 2026-09-09)
Одинаковое название уровня не означает одинаковое число token в 2.5 и gpt-image-2: 2.5 заново калибрует шкалу качества.low не изменяется, high у 2.5 соответствует medium у gpt-image-2, а max у 2.5 соответствует high у gpt-image-2. В таблице показаны usage.output_tokens и стоимость вывода при тарифе $30 / 1 млн token для преобразования текста в изображение размером 1024×1024, с одинаковым prompt и одним последовательным запуском для каждой модели (flare и sunburst дают одинаковое число token для каждого уровня; различается только задержка):
Как несколько входных изображений влияют на цену (проверено в июле 2026)
Частый вопрос от клиентов: «Каждое референсное изображение стоит фиксированную сумму, или большие изображения расходуют больше tokens?» Ответ: важны оба фактора, и количество изображений суммируется строго линейно.gpt-image-2 обрабатывает каждое входное изображение в принудительном режиме высокой детализации (input_fidelity не настраивается — при его передаче возвращается 400), и каждое референсное изображение преобразуется в image tokens в зависимости от его размеров и aspect ratio. Контролируемые измерения (эндпоинт edits, 2026-07-15):
- Количество строго линейно: N референсных изображений ≈ N × tokens одного изображения. 16 референсных изображений при 1024² ≈ 16384 tokens ≈ $0.13 — тот же порядок величины, что и один вывод
high($0.211), так что в случае слияния нескольких изображений этим уже нельзя пренебрегать. - Размер имеет и нижний предел, и потолок: квадратные изображения размером 1024² и меньше тарифицируются как 1024 tokens (уменьшение до 512 ничего не экономит); 2048² и 4096² оба стоят 1521 tokens (слишком большие изображения перед преобразованием уменьшаются — потолок действует). Одно референсное изображение обычно попадает примерно в диапазон 800-1600 tokens с учетом соотношения сторон.
- Tokens определяются размерами в пикселях, а не размером файла: сжатие до 1.5MB помогает со стабильностью и скоростью загрузки, но не уменьшает image tokens; наоборот, загрузка исходника на 50MB тоже не раздует ваш счет (действует потолок).
Оценка стоимости 2K/4K (экстраполяция по соотношению пикселей, ⚠️ не официальная фиксированная цена)
OpenAI публикует только фиксированную таблицу цены за изображение для размеров 1K — для 2K/4K нет официальной помодельной цены по размеру. Приведенная ниже таблица — это собственная экстраполяция APIYI на основе официальных ставок 1K выше, масштабированная по числу пикселей, и она предназначена только для планирования бюджета:Чем это отличается от SaaS-подписки / тарификации на основе credit
Вендоры инструментов генерации изображений обычно тарифицируют по одной из двух схем:- Ежемесячные планы подписки: фиксированная ежемесячная плата за квоту «N изображений в месяц». Эта квота рассчитывается исходя из предположения о сверхпродаже — вендор закладывает ожидание, что большинство пользователей не израсходует весь лимит, поэтому рекламируемая «стоимость за изображение» — это просто цена плана, деленная на верхний предел квоты, а не то, сколько на самом деле стоит сгенерировать для вас одно изображение.
- Учёт на основе credit / point: задачи разного качества и размера переводятся в неочевидные «credits». По сути это тарификация по фактическому использованию, просто переупакованная в единицу credit, которая скрывает реальное потребление token.
Как проверить фактическое количество token для каждого вызова
И/v1/images/generations, и /v1/images/edits возвращают поле usage, а token изображений и token текста возвращаются в отдельных полях — ничего оценивать не нужно, просто считайте их для точного расчёта стоимости каждого вызова. Ниже приведён полный объект usage из реального запроса на редактирование с одним эталонным изображением (получен в реальном времени):
Настройка группы
Все три модели GPT-Image 2.5 / 2 используют одни и те же группы официального релея. Переключение выполняется в панели управления → Настройки token → Группа:image2Enterprise, чтобы переждать всплеск нагрузки.
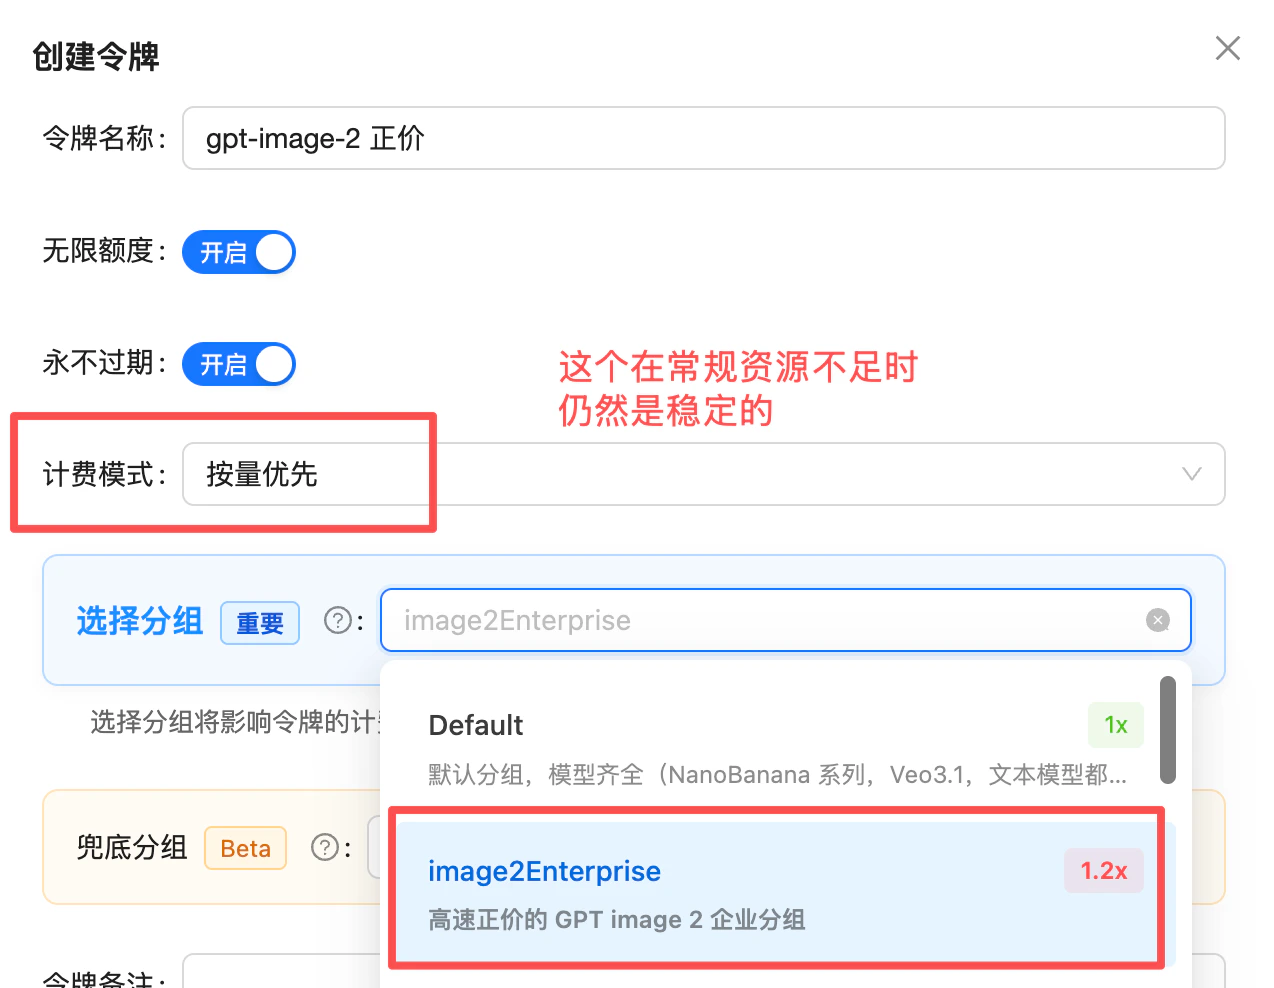
Token settings: pick the image2Enterprise group (1.2x) — stable when default capacity is tight
Технические характеристики
Эндпоинты
Справка по размерам
Предустановленные размеры
Ограничения пользовательского размера
gpt-image-2 принимает любой допустимый размер, который соответствует всем условиям:
- Макс. сторона ≤ 3840px
- Обе стороны кратны 16
- Соотношение сторон ≤ 3:1
- Общее число пикселей ∈ [655,360, 8,294,400] (~0.65MP до ~8.3MP)
1600x1200, 1792x1024, 2048x1536, 3200x1800
Недопустимые примеры: 1000x1000 (не кратно 16), 4000x4000 (выше максимума), 3840x1000 (соотношение > 3:1)
Справочник качества
Доступные уровни
quality оказывает наибольшее влияние на цену — больше, чем size. Количество токенов выходного изображения определяется параметром quality × size, но quality имеет гораздо больший вес: при одинаковом размере переход от low к high может изменить стоимость одного изображения более чем в 30 раз (см. приведённую выше таблицу «стоимость изображения»: для gpt-image-2 при размере 1024×1024 она варьируется от low $0.006 до high $0.211; для моделей версии 2.5 — от low $0.006 до max $0.211). Сначала оценивайте стоимость по параметру quality, а затем учитывайте влияние size.Рекомендации
Сначала интегрируйте с low
quality=low + предустановленного размера, чтобы проверить всю цепочку вызовов (аутентификация, параметры, таймауты, обработка ошибок). low работает в несколько раз быстрее, чем high, поэтому функциональные проблемы выявятся быстрее и не будут маскироваться длительной задержкой.Отдавайте предпочтение предустановленным размерам
Подбирайте качество под сценарий
low; повседневные задачи / финал → medium; текст, мелкие текстуры, печать → high. Обратите внимание, что разница между low и high заключается не только в визуальной детализации — это также скачкообразное изменение сложности инференса, поэтому задержка растет пропорционально.Выбирайте вывод в формате JPEG
output_format=jpeg + output_compression=85 работает быстрее PNG и занимает примерно вдвое меньше места.Фиксируйте high для сценариев с текстом
quality=high для вывесок и постеров.Подготавливайте референсные изображения
Прозрачный фон: передавайте параметр и исключайте сцены из prompt
gpt-image-2.5-flare / gpt-image-2.5-sunburst (gpt-image-2 отклоняется OpenAI с ошибкой 400 с 2026-09-30). background: "transparent" со значениями png / webp гарантирует только наличие альфа-канала. Если prompt или референсное изображение описывает полноценную сцену (лес, комната, улица), модель отрисует эту сцену, и параметр ее не остановит — именно поэтому прозрачность «срабатывает через раз», и это никак не связано с quality (замеры от 2026-09-11: prompt только с объектом — 16/16 прозрачных, prompt со сценой — 0/3, одинаково для medium и high). Завершайте prompt фразой isolated subject on a transparent background, no scenery, no ground; если у референсного изображения есть фон, укажите remove the background entirely, keep only the subject в prompt редактирования. См. FAQ по прозрачному фону.Дифференцируйте клиентские таймауты (high → страховочный таймаут 600 с)
quality и size (особенно quality). Настройте клиентские таймауты для каждого уровня:high установите 600 с в качестве страховочного таймаута, чтобы компенсировать очереди, дисперсию «длинного хвоста» и колебания на стороне апстрима. Отображайте прогресс в интерфейсе; рассмотрите возможность использования очереди задач на стороне сервера.Примечания по миграции
gpt-image-1.5: удалите input_fidelity (высокая точность принудительна, передача параметра приведет к ошибке); для прозрачного фона перейдите на одну из двух моделей 2.5 (gpt-image-2 больше не принимает background: transparent с 2026-09-30). Миграция с устаревшего кода DALL·E 2/3: удалите response_format (модели GPT Image отклоняют его с ошибкой 400 Unknown parameter: 'response_format'; результатом всегда является b64_json).Ошибки и повторные попытки
- Разделяйте таймаут запросов по уровням в зависимости от
quality:low≥ 120 секунд /medium≥ 240 секунд /high≥ 600 секунд (страховочный интервал — наблюдаемое время 3–5 минут; установка около 120s/360s приводит к частым ложным таймаутам) - Сначала выполните интеграцию с
quality=low, затем переходите наmedium/highпо мере возникновения реальной потребности в качестве - Экспоненциальная задержка для ошибок 5xx и таймаутов (рекомендуется 2 повторные попытки)
- Логируйте заголовок
x-request-idдля обращения в поддержку
FAQ
Как исправить ошибку 400 Unknown parameter: 'response_format'?
Как исправить ошибку 400 Unknown parameter: 'response_format'?
response_format — в настоящее время это самая частая ошибка 400. gpt-image-2 (и вся серия GPT Image) не принимает response_format: формат вывода жестко зафиксирован как b64_json и не может быть изменен. При его передаче возвращается:url / b64_json), и во многих старых примерах кода, а также в некоторых сторонних библиотеках он до сих пор включен по умолчанию. При миграции на gpt-image-2 удалите это поле и считывайте data[0].b64_json напрямую (исходный base64 — декодируйте его, чтобы получить файл изображения). Ошибка возвращается на этапе валидации входных данных и не тарифицируется.Если в вашем рабочем процессе действительно требуется URL изображения вместо base64:- Официальный
gpt-image-2не поддерживает вывод URL — декодируйте base64 и загружайте в собственное объектное хранилище - Или переключитесь на реверс-инжиниринговый
gpt-image-2-all, который поддерживаетresponse_format: "url"и возвращает ссылку CDN, действительную в течение 24 часов
Нужно ли добавлять префикс data:image/png;base64, к b64_json?
Нужно ли добавлять префикс data:image/png;base64, к b64_json?
gpt-image-2 возвращает чистую строку base64 (без префикса), в отличие от gpt-image-2-all. Два сценария на клиенте:- Запись в файл:
base64.b64decode(b64_str)→ запись на диск - Отображение в браузере:
img.src = 'data:image/png;base64,' + b64_str(добавить префикс вручную)
Почему передача input_fidelity возвращает 400?
Почему передача input_fidelity возвращает 400?
gpt-image-2 принудительно включает высокоточную обработку референсных изображений и больше не принимает input_fidelity. При миграции с версии 1.5 просто удалите это поле — замена не требуется.Что делать, если нужен прозрачный фон?
Что делать, если нужен прозрачный фон?
gpt-image-2.5-flare или gpt-image-2.5-sunburst и передайте background: "transparent" со значением output_format, установленным в png или webp. На выходе получается изображение с настоящим альфа-каналом — пост-обработка с вырезанием фона не требуется. Это поддерживается как для генерации по тексту, так и для редактирования изображений. gpt-image-2 это не поддерживает: OpenAI отключила прозрачный фон 30.09.2026, и теперь модель возвращает 400 — измените название модели и сохраните остальные параметры.Два ограничения: jpeg не имеет альфа-канала и несовместим с прозрачностью (возвращает 400); а на эндпоинте редактирования прозрачность формируется повторной перерисовкой, а не точной обводкой исходного контура, поэтому детали объекта могут измениться. Для попиксельно точного вырезания выполните rembg / PIL / sharp самостоятельно.Третье ограничение часто упускают из виду: если промпт или референсное изображение описывают сцену, модель нарисует сцену — параметр не может это переопределить, и увеличение quality не поможет. Описывайте только сам объект и завершайте промпт фразой isolated subject on a transparent background, no scenery, no ground.Подробности и поддержка по моделям: Как генерировать изображения с прозрачным фоном.Сколько изображений генерируется за один вызов?
Сколько изображений генерируется за один вызов?
n=1). Для получения N изображений отправьте N параллельных запросов. Каждый запрос тарифицируется по токенам независимо.Почему генерация в 2K/4K выполняется так долго?
Почему генерация в 2K/4K выполняется так долго?
quality=high + высокое разрешение занимало ≈ 235 секунд (~4 минуты) на одно изображение, а длительность единичных долгих запросов для 3840×2160 + high может доходить почти до 5 минут. Рекомендации:- Сначала выполните интеграцию с
quality=low, чтобы проверить цепочку вызовов, а затем повышайте параметры по мере реальной необходимости в качестве - Настройте тайм-аут клиента по уровням качества:
low≥ 120s /medium≥ 240s /high≥ 600s (для подстраховки) - Отображайте статус «генерация» в интерфейсе
- Используйте пресеты 1K (1024×1024 / 1536×1024), когда 4K не требуется
Даст ли кэширование входных данных реальную экономию?
Даст ли кэширование входных данных реальную экономию?
Почему запросы на редактирование стоят дороже, чем генерация по тексту?
Почему запросы на редактирование стоят дороже, чем генерация по тексту?
gpt-image-2 автоматически включает обработку референсных изображений с высокой детализацией, сами референсы преобразуются в большой объем входных токенов по правилам тарификации Vision. Количество входных токенов при редактировании заметно выше, чем при генерации по тексту — учитывайте это при планировании бюджета.Одинаковый размер и референсные изображения — почему каждый вызов стоит по-разному?
Одинаковый размер и референсные изображения — почему каждый вызов стоит по-разному?
quality было установлено значение auto (или параметр был опущен). Клиенты обращались с вопросом: «размер, разрешение и референсные изображения идентичны, но цена постоянно колеблется». При анализе выяснилось, что и size, и quality были установлены в auto.Виновник — quality: auto: в автоматическом режиме модель анализирует запрос и на лету выбирает уровень качества для каждой генерации. Другой уровень означает другое количество выходных токенов изображения, что влечет за собой другую цену. Ниже приведены три реальные записи тарификации с идентичными входными данными (по 1061 входному токену), стоимость которых отличается в несколько раз:auto выбрал более высокий уровень качества, выходные токены подскочили до 5146, а цена выросла примерно в 3,5 раза.Решение: не оставляйте quality в значении auto — передавайте low / medium / high явно. При фиксированном уровне количество выходных токенов и цена для одинаковых входных данных становятся стабильными и предсказуемыми. См. раздел «Справочник по качеству» выше.Каковы ограничения по количеству и размеру изображений для эндпоинта редактирования?
Каковы ограничения по количеству и размеру изображений для эндпоинта редактирования?
gpt-image-2 (/v1/images/edits) поддерживает до 16 референсных изображений:- Загрузка файлов multipart/form-data: каждое изображение должно быть менее 50MB, форматы
png/jpg/webp - data URL в base64: ограничение на длину поля составляет около 20MiB (схема
maxLength: 20971520— это ограничение на строковое поле, а не то же самое, что лимит 50MB для multipart), поэтому держите размер исходных изображений в пределах 15MB - Файл маски: отдельное ограничение — PNG менее 4MB
Эндпоинт редактирования возвращает ошибку 400 'Invalid image file or mode for image 1' — что делать?
Эндпоинт редактирования возвращает ошибку 400 'Invalid image file or mode for image 1' — что делать?
code: invalid_image_file) означает: N-е референсное изображение не является стандартным файлом png / jpg / webp (нумерация с 1 — используйте индекс, чтобы найти проблемное изображение).Самая частая причина — формат MPO со смартфонов: файлы .jpg прямо с телефонов серии Huawei Mate содержат дополнительный подкадр HDR gain-map и фактически являются многокадровыми контейнерами JPEG (MPO). Заголовок у них тот же FFD8, и расширение, и команда file определяют их как JPEG — визуально это выявить невозможно. Проверено в июле 2026 года: файлы MPO всегда отклоняются, тогда как те же изображения, перекодированные в стандартный JPEG/PNG, успешно обрабатываются в полном исходном разрешении (это не связано с размерами, именем поля image[] или параметрами quality/size). Ошибка возвращается на этапе валидации входных данных и не тарифицируется.Решение: перекодируйте изображение с помощью Pillow перед отправкой (если Image.open(f).format возвращает "MPO", требуется конвертация):Как подготовить файл маски?
Как подготовить файл маски?
- Тот же размер, что и у оригинала, формат PNG, размер менее 4MB
- Обязателен альфа-канал: прозрачная область (alpha=0) = область для inpaint, непрозрачная = сохраняемая область
- Применяется только к первому изображению
- Маска служит «мягким ориентиром» — модель может немного выходить за границы маскированной области или сужать ее
gpt-image-2 или gpt-image-2-all: что выбрать?
gpt-image-2 или gpt-image-2-all: что выбрать?
Можно ли напрямую использовать официальный SDK OpenAI?
Можно ли напрямую использовать официальный SDK OpenAI?
base_url на https://api.apiyi.com/v1 и укажите ваш токен APIYI в api_key:Можно ли отменить запущенную генерацию?
Можно ли отменить запущенную генерацию?
gpt-image-2 использует официальный синхронный эндпоинт OpenAI: после отправки запрос выполняется до полного завершения без возможности отправить сигнал отмены. Даже если клиент разрывает соединение, сервер завершает генерацию и списывает средства в обычном режиме. Тщательно настраивайте клиентские тайм-ауты — не рассчитывайте на логику «разрыв соединения = нет списания».Существует ли лимит запросов (RPM)?
Существует ли лимит запросов (RPM)?
Поддерживается ли асинхронный вызов?
Поддерживается ли асинхронный вызов?
gpt-image-2 строго повторяет официальный API OpenAI — только синхронный режим. Запрос блокируется до возврата результата (для high + 4K это реально занимает 1–2 минуты). Если вам нужен асинхронный механизм очереди или обратных вызовов:- Реализуйте обертку самостоятельно с помощью очереди задач (Celery / BullMQ и т. д.) на уровне бизнес-логики
- Либо используйте
gpt-image-2-all— генерация длится 30–60 секунд, такой опрос проще выполнять с фронтенда
Есть ли ограничение на длину промпта? Почему в веб-приложении ChatGPT помещается больше текста?
Есть ли ограничение на длину промпта? Почему в веб-приложении ChatGPT помещается больше текста?
gpt-image-2 и обеих моделей 2.5); официальный релей APIYI его не занижает. При превышении провайдер не возвращает ошибку: он просто игнорирует весь промпт и генерирует несвязанное изображение (часто реалистичный портрет или интерьер), а в usage.input_tokens_details.text_tokens возвращается однозначное число токенов (8 в наших тестах). В документации заявлено 32 000 символов; 32 000 английских символов — это примерно 8K токенов, так что эти лимиты приблизительно совпадают, однако китайский текст плотнее и упирается в ограничение примерно на 11 000 символов. Если сгенерированное изображение не имеет ничего общего с промптом, первым делом проверьте text_tokens для этого вызова. В веб-приложении ChatGPT ограничение кажется бесконечным только потому, что чат-модель считывает вставленный текст и сама составляет краткий промпт для инструмента генерации, поэтому модель генерации изображений исходные материалы даже не видит. Для объемных материалов (брендбуки, спецификации упаковки) предварительно сожмите их с помощью текстовой модели в структурированный промпт объемом от 1K до 3K символов, см. Длинные промпты.Ошибка 400 с safety_violations=[sexual] для промпта без откровенного содержания. Что делать?
Ошибка 400 с safety_violations=[sexual] для промпта без откровенного содержания. Что делать?
moderation: low снижает модерацию только на этапе входного промпта и здесь не помогает. Самая частая причина: персонаж описан через эмоции и настроение, но без описания одежды, поэтому модель импровизирует и выходит за рамки правил: сначала добавьте одну явную фразу с описанием одежды (не меняя ничего остального), и только затем убирайте спорные слова по одному. Подробный разбор кейса и лог 20 вызовов: Отклонения модерацией безопасности.Тарифицируются ли неудачные попытки генерации?
Тарифицируются ли неудачные попытки генерации?
400, и списание средств не производится. Типичный ответ:401 (недействительный токен), 429 (лимит запросов). Тарификация по токенам начинается только тогда, когда запрос фактически доходит до этапа генерации моделью (то есть получены 200 + b64_json).Связанная документация
- ⚖️ Сравнение: официальный релей против реверса - Сравнительное руководство по выбору
- Песочница Text-to-Image -
/v1/images/generationsинтерактивное тестирование - Песочница Image Edit -
/v1/images/editsобъединение нескольких изображений + маска - Подробный разбор: запуск GPT-image-2.5, Flare стал быстрее, Sunburst — четче - Новостная статья
- Подробный разбор: запуск gpt-image-2 - Новостная статья
- Полное руководство по интеграции - Полный справочник по API
- GPT-Image-2-All (реверс-инжиниринг) - Более дешевая и быстрая альтернатива
- Сообщество: ноды Luck GPT-Image 2 для ComfyUI - Вызов
gpt-image-2/gpt-image-2.5-flare/gpt-image-2.5-sunburstнапрямую в ComfyUI (маска / 16 референсных изображений / шесть уровней качества / произвольные размеры) - Сообщество: APIYI GPT-Image 2 Skills - Вызов одной фразой из Codex CLI / Cursor / Gemini CLI и других инструментов разработки на базе ИИ
- Руководство по API - Общее руководство по использованию
gpt-image-2.5-flare / gpt-image-2.5-sunburst / gpt-image-2 — это официальные модели OpenAI с тарификацией за token. Если для вас в приоритете фиксированная цена ($0.025/изображение) и более быстрая генерация (30–60 с), см. gpt-image-2-all.