

Обзор
gpt-image-2.5-all и gpt-image-2-all — это реверс-инжиниринговые модели генерации изображений GPT от APIYI (веб-линейка ChatGPT). Веб-приложение ChatGPT полностью перешло на Images 2.5, поэтомуgpt-image-2-all уже создает изображения версии 2.5; новое название gpt-image-2.5-all лишь делает это обновление явным — оба названия имеют одинаковую цену и поведение и взаимозаменяемы; для новых проектов следует использовать gpt-image-2.5-all. Благодаря исключительно выгодной цене $0.025 за изображение за вызов (снижена с $0.03 от 2026-10-10), модель генерирует изображения примерно за 30–60 секунд и поддерживает генерацию изображений по тексту / редактирование одного изображения / объединение нескольких изображений / редактирование на естественном языке — с высокой точностью рендеринга текста и нативной поддержкой prompt на китайском языке.
/v1/images/generations (генерация изображений по тексту) и /v1/images/edits (редактирование изображений).Нужно зафиксировать выходной размер или получить 4K? Переключитесь на родственную модель gpt-image-2-vip — тот же формат вызова, только с дополнительным полем size.API генерации изображений по тексту
/v1/images/generations — генерация изображений по текстовым prompt.API редактирования изображений
/v1/images/edits — загрузка multipart с инструкциями по редактированию/объединению.Поручите интеграцию ИИ-агенту
Скопируйте этот prompt и вставьте его в Codex / Claude Code / Cursor
Сначала он запросит текстовую версию этой страницы (добавьте .md к любому docs URL), а затем напишет код под стек вашего проекта — таймаут, рендеринг base64, сжатие перед загрузкой и параметры, которые отклоняются этой моделью, уже заложены в требования.
Интегрируйте / выполните отладку генерации изображений по тексту (text-to-image) и редактирования изображений с помощью gpt-image-2-all в этом проекте.
Прочитайте документацию перед тем, как писать код: запросите https://docs.apiyi.com/en/api-capabilities/gpt-image-2-all/overview.md для получения текстовой версии этой страницы. Для более подробной информации о параметрах добавьте
.mdк …
- Таймаут: увеличьте клиентский таймаут до 360 секунд. API изображений являются синхронными — task ID отсутствует, поэтому при отключении клиента результат будет потерян …
Всего 6 требований. Используйте кнопку ниже, чтобы скопировать prompt целиком.
От каких проблем защищает этот prompt
От каких проблем защищает этот prompt
Ключевые особенности
Высококонкурентная цена
Качественный рендеринг текста
Поддержка prompt на китайском языке
Объединение нескольких изображений
Более быстрая генерация
gpt-image-2-vip и официальный релей gpt-image-2Ускорение через R2 CDN
response_format: "url" для получения ссылок R2 CDN с низкой задержкой доставки по всему мируРедактирование на естественном языке
Поддержка стандартных эндпоинтов
/images/generations и /images/editsТарифы
- Фиксированная цена; без градации по разрешению, качеству или длине prompt
- Неудачные запросы не тарифицируются (ошибки аутентификации, ошибки валидации параметров)
- Чтобы получить N изображений, вызовите API N раз параллельно
Настройка групп
gpt-image-2-all находится в группе Default — дополнительная группа не требуется. Обратный канал в настоящее время стабилен, поэтому сценарий переключения на корпоративную группу, как у официального релея gpt-image-2, здесь отсутствует.
Нужен детерминированный вывод URL → переключитесь на группу image2_OSS
По замерам за июль 2026 года в группе по умолчанию gpt-image-2-all (и gpt-image-2-vip) возвращают b64_json, если response_format не указан; передайте response_format: "url" явно, чтобы получить URL изображения. Формат вывода в группе по умолчанию не гарантируется — исторически по умолчанию возвращался url с переключением на b64_json под нагрузкой, а также менялся в разных версиях канала.
Если ваши сценарии зависят от вывода в формате URL (прямая запись URL в базу данных, рендеринг на фронтенде по URL, base64 не подходит), переключите группу вашего token на image2_OSS — группу, специально созданную для детерминированного вывода URL, с коэффициентом тарифа 1x (без наценки), действующую для обеих реверс-моделей gpt-image-2-all и gpt-image-2-vip. Она гарантирует, что ответ всегда содержит URL изображения и никогда не переключается на base64.
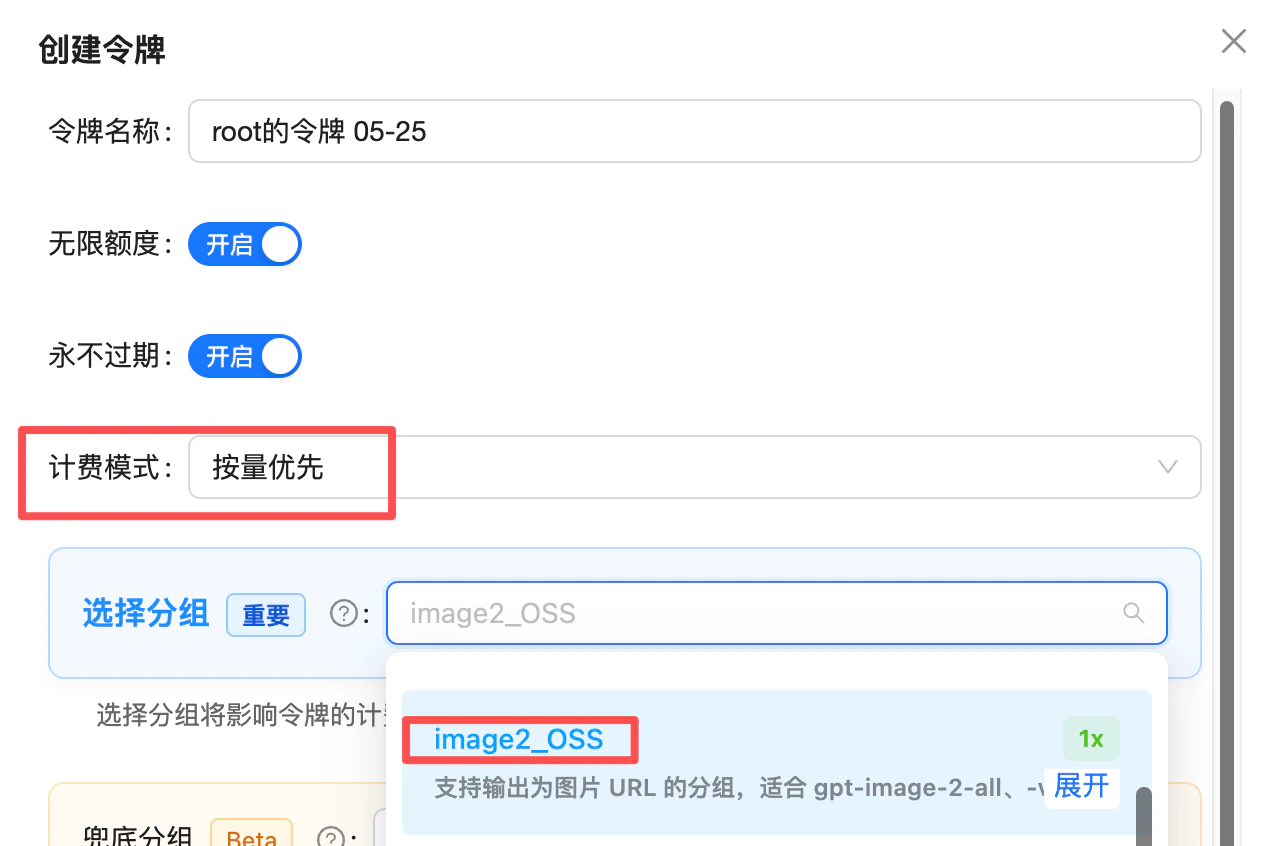
Token creation: set billing mode to "pay-as-you-go first" and pick the image2_OSS group (1x) — use it when you need deterministic URL output
image2Enterprise: /en/live/2026-04/image2-enterprise-stable
Технические характеристики
Эндпоинты
size? Используйте родственную модель gpt-image-2-vip — идентичные эндпоинты, лишь одно дополнительное поле size (30 фиксированных размеров, включая 4K).Управление размером и соотношением сторон (описание в prompt)
Вgpt-image-2-all нет параметра size — размер описывается в prompt. Если вам требуются строго фиксированные размеры на выходе (главные баннеры для e-commerce, шаблоны плакатов, обои 4K), используйте вместо этого gpt-image-2-vip.
Проверенная таблица «формулировка в prompt → фактическое разрешение»
8 приведенных ниже формулировок были проверены на практике и воспроизводятся стабильно. Добавьте формулировку из первой колонки в начало вашего prompt, и вы получите разрешение, указанное во второй колонке (все результаты находятся на уровне разрешения ~1,5K пикселей):- Все результаты относятся к уровню ~1,5K пикселей (длинная сторона от 1500 до 2000 px). Это фактический предел модели — она не поддерживает по-настоящему «любое разрешение».
- Воспроизводимость максимальна, когда prompt содержит только формулировку из таблицы; добавление других слов, описывающих композицию, приводит к отклонениям.
- Китайские строки — это фактические значения, которые вы отправляете; мы рекомендуем оставлять их как есть, а не переводить.
Стилистические формулировки (без фиксированного разрешения)
Приведенные ниже формулировки не имеют проверенного разрешения — используйте их только как модификаторы стиля в сочетании с приведенной выше таблицей:Предоставление этой таблицы конечным пользователям
Хотя вgpt-image-2-all нет параметра size, вы все равно можете предложить своим пользователям выпадающий список «Размер / соотношение сторон», который ощущается точно так же, как официальное поле size:
- Используйте формулировку для prompt из приведенной выше таблицы в качестве
valueварианта (например,横版 16:9) - Отображайте ожидаемое разрешение в названии варианта (например,
Landscape 16:9 (1672×941)), чтобы пользователи знали, что получат - На бэкенде добавляйте выбранную формулировку в начало исходного prompt пользователя перед отправкой в API
Лучшие практики
Сжимайте входные изображения до размера менее 1.5 МБ (редактирование изображений / объединение нескольких изображений)
4K / 8K в prompt также не приведет к созданию изображения с высоким разрешением; для надежного получения большего размера используйте проверенные формулировки из таблицы «Проверенные формулировки prompt → фактическое разрешение» выше.Указывайте размер в начале prompt
Уверенно используйте текстовые элементы
Обозначайте порядок при работе с несколькими изображениями
image имеет значение. Явно ссылайтесь на них как «image1/image2/image3» в prompt.Выбирайте формат ответа в зависимости от задач
b64_json для прямого рендеринга в вебе; url — для хранения или пересылки на стороне сервера.Используйте таймаут 300 с
Удаляйте отклоняемые параметры
gpt-image-2-all отклоняет size, n, quality, aspect_ratio — их передача может вызвать ошибки валидации. Чтобы передать size, переключитесь на gpt-image-2-vip.Коды ошибок и повторные попытки
- Тайм-аут запроса от 300 секунд (консервативно; обычно 30–60 с, но загрузка/скачивание изображений и длинный хвост задержек при пиках обратного канала вызывают сильный разброс — 120 с приводит к частым ложным тайм-аутам)
- Используйте экспоненциальную задержку для ошибок 5xx и тайм-аутов (рекомендуется 2–3 повторные попытки)
- Логируйте заголовок ответа
request-idдля отладки
Часто задаваемые вопросы (FAQ)
Доступны и gpt-image-2-all, и gpt-image-2-vip — какой из них выбрать?
Доступны и gpt-image-2-all, и gpt-image-2-vip — какой из них выбрать?
size, времени генерации и стабильности:- Не требуется строгий контроль размера, нужен более быстрый и стабильный результат →
gpt-image-2-all(~30–60 с, описание размера в prompt, результат 1K–1.5K). - Требуется фиксированный размер на выходе или 4K →
gpt-image-2-vip(~90–150 с, 30 фиксированных размеров, включая 4K). - Нужна настройка
qualityили полное соответствие полям API OpenAI → используйте официальныйgpt-image-2.
Можно ли сгенерировать несколько изображений за один раз?
Можно ли сгенерировать несколько изображений за один раз?
Поддерживается ли параметр n? Что произойдет, если передать n=3?
Поддерживается ли параметр n? Что произойдет, если передать n=3?
n=3 в запросе, тарификация составит 0.025 × 3 = $0.075, однако фактически будет возвращено только 1 изображение. Обязательно исключите поле n из ваших запросов во избежание лишних списаний.Если контент отклонен или модель отвечает «I can't do that», списывается ли оплата?
Если контент отклонен или модель отвечает «I can't do that», списывается ли оплата?
- ✅ Предварительно фильтруйте и предупреждайте пользователей: настройте фильтрацию по ключевым словам и сценариям на фронтенде или шлюзе (имена реальных людей, защищенные авторским правом персонажи, деликатные темы) и показывайте в интерфейсе подсказку вроде: «Запросы об известных личностях и объектах авторского права могут завершиться ошибкой, но все равно будут протарифицированы согласно правилам вышестоящего провайдера». Это значительно сократит лишние списания.
- ✅ Ежемесячная компенсация для b2c-продуктов: мы понимаем, что в продуктах для конечных пользователей невозможно полностью ограничить пользовательский ввод. Если ваши ежемесячные расходы достаточно высоки (от $1000+/month), вы можете собирать логи раз в месяц (запросы с малой задержкой обычно являются мягкими отказами) и обращаться в поддержку за разовой ручной компенсацией — подавать заявку по каждому вызову отдельно не требуется.
Нужно ли добавлять префикс data:image/png;base64, к b64_json?
Нужно ли добавлять префикс data:image/png;base64, к b64_json?
b64_json представляет собой чистый base64 без префикса data: — декодируйте его для записи в файл или добавьте префикс самостоятельно перед рендерингом; в более ранних версиях префикс присутствовал. Добавьте проверку startsWith('data:') в свой код: если префикс присутствует, используйте значение напрямую как img src; если нет — сначала декодируйте или добавьте префикс. Это предотвратит появление двойного префикса или попытку декодирования строки с префиксом, приводящую к повреждению изображения.Почему на выходе получается другой размер, даже если в prompt указано 1024x1024?
Почему на выходе получается другой размер, даже если в prompt указано 1024x1024?
cinematic, phone poster, square composition).Формулировки, которые гарантированно приводят к определенному разрешению, приведены выше на этой странице в таблице «Проверенные формулировки prompt → фактическое разрешение» (в разделе «Управление размером и соотношением сторон»).Нужно ли сжимать входные изображения? Помогает ли указание 4K / 8K в prompt?
Нужно ли сжимать входные изображения? Помогает ли указание 4K / 8K в prompt?
4K / 8K в prompt на самом деле не приводит к генерации изображения высокого разрешения — эти слова служат лишь украшением, и модель не увеличивает разрешение из-за них. Для надежного получения изображений большего размера используйте проверенные формулировки из таблицы «Проверенные формулировки prompt → фактическое разрешение» выше (например, cinematic, phone poster, square composition). Если требуется строго зафиксировать размер или получить 4K, переключитесь на gpt-image-2-vip (30 фиксированных размеров, включая 4K, фиксированная цена $0.03 за изображение).Каков максимальный размер эталонного изображения и какие форматы поддерживаются?
Каков максимальный размер эталонного изображения и какие форматы поддерживаются?
png / jpg / webp. Слишком большие изображения могут упереться в лимиты шлюза. Этому ограничению должно соответствовать каждое изображение при объединении нескольких файлов.Сколько времени действительны возвращаемые URL изображений? Нужно ли их скачивать?
Сколько времени действительны возвращаемые URL изображений? Нужно ли их скачивать?
url в ответе режима url представляет собой ссылку R2 CDN, срок действия которой истекает примерно через 1 день (24 часа) — последующие запросы к ней вернут ошибку 404.Настоятельно рекомендуется: скачивайте и сохраняйте сгенерированные изображения в собственное объектное хранилище (S3 / OSS / R2), CDN или базу данных сразу после генерации. Не используйте полученный URL для постоянных прямых ссылок (hotlinking).Два рекомендуемых подхода:- Проксирование на стороне сервера: сразу после получения ответа выполните
requests.get(url), сохраните в собственное хранилище и верните на фронтенд собственный URL; - Использование
b64_json: добавьте"response_format": "b64_json"в запрос, чтобы получить данные изображения напрямую в формате base64 — это избавит от лишнего кросс-доменного скачивания и идеально подходит для отображения на фронтенде или прямой записи в файл.
Поддерживается ли потоковая передача?
Поддерживается ли потоковая передача?
Можно ли использовать официальный SDK OpenAI?
Можно ли использовать официальный SDK OpenAI?
base_url на https://api.apiyi.com/v1 и задайте свой token APIYI в api_key. Однако client.images.generate() по умолчанию отправляет size/n — эта модель отклоняет оба параметра, поэтому мы рекомендуем выполнять прямые HTTP-запросы с помощью requests / fetch к /v1/images/generations и /v1/images/edits.Есть ли существенная разница между prompt на китайском и английском языках?
Есть ли существенная разница между prompt на китайском и английском языках?
Можно ли по-прежнему генерировать изображения через /v1/chat/completions?
Можно ли по-прежнему генерировать изображения через /v1/chat/completions?
/v1/images/generations и /v1/images/edits (это стабильнее, и тот же код будет работать с официальным релеем gpt-image-2).Формат чата имеет смысл только в двух сценариях: многоэтапное пошаговое редактирование или прямая передача URL онлайн-изображений. Обратите внимание: если намерение сгенерировать изображение неочевидно, модель может вернуть обычный текст вместо изображения (добавьте в начало вашего prompt фиксированный префикс, например «Generate an image:», чтобы подчеркнуть цель).Полный список параметров см. в справочнике по API на базе чата.Связанная документация
- ⚖️ Сравнение официальной версии и reverse-канала — руководство по выбору в сравнении с официальной
gpt-image-2 - Песочница генерации изображений по тексту — эндпоинт, совместимый с
/v1/images/generations - Песочница редактирования изображений — объединение и редактирование нескольких изображений с помощью
/v1/images/edits - GPT-Image-2-VIP (та же цена, поддержка
sizeи 4K) — сестринская модель по той же цене с 30 фиксированными размерами (включая 4K); полностью идентичный формат вызова - GPT-Image-2 Official (с тарификацией по token) — для параметра
quality/ перерисовки по маске / строгого соответствия полям OpenAI-API - Обзор серии GPT-Image — официальное сравнение GPT-Image
- Сообщество: ноды Luck GPT-Image 2 для ComfyUI — прямой вызов
gpt-image-2-allв ComfyUI (два эндпоинта: chat_completions / images_api) - Сообщество: навыки APIYI GPT-Image 2 — вызов из Codex CLI / Cursor / Gemini CLI и других инструментов разработки на базе ИИ одной фразой
- Справочник по API — общие правила выполнения вызовов