

size снова доступен (обновлено 2026-07-22): при явной передаче size теперь размеры вывода фиксируются, как и ожидается, а справочная таблица из 30 размеров на этой странице снова действует. Примечание: size работает только на эндпоинтах /v1/images/generations и /v1/images/edits — чат-эндпоинт /v1/chat/completions не поддерживает параметр size, поэтому генерация изображений через chat не может фиксировать размеры. За актуальным статусом см. раздел Живые обновления.Обзор
gpt-image-2.5-vip (псевдонимgpt-image-2.5-sunburst-vip), gpt-image-2.5-flare-vip и модель предыдущего поколения gpt-image-2-vip — это реверс-инжиниринговые модели генерации изображений GPT на линии Adobe (Firefly) от APIYI — высококачественная реверс-линия GPT-Image 2.5, а не низкокачественный апскейлинг. Фиксированная цена составляет $0.03/изображение, при этом формат запроса и ответа идентичен gpt-image-2.5-all ($0.025/изображение) — единственное существенное отличие заключается в том, что vip принимает поле size с 30 популярными размерами (10 соотношений сторон × 3 уровня разрешения: 1K Быстрый / 2K Рекомендуемый / 4K Детализированный), включая 4K.
gpt-image-2.5-vip, когда вам нужно зафиксировать выходной размер (главные баннеры для e-commerce, шаблоны постеров, превью для видео, обои 4K и т. д.). Просто замените поле model на gpt-image-2.5-vip и добавьте поле size — все остальные строки кода остаются точно такими же, как в gpt-image-2.5-all.gpt-image-2.5-vip (псевдоним gpt-image-2.5-sunburst-vip), gpt-image-2.5-flare-vip и модель предыдущего поколения gpt-image-2-vip используют одну и ту же реверс-линию Adobe с одинаковой ценой ($0.03 за изображение, за вызов), группами (Default / image2_OSS / svip), эндпоинтами и форматом вызова — для переключения достаточно изменить model. flare-vip работает быстрее и дает более мягкую картинку; sunburst-vip отличается более высоким качеством и точностью редактирования, визуально приближаясь к gpt-image-2-vip. Границы параметров и измеренные различия приведены ниже в разделе «Сравнение трех моделей -vip».API генерации изображений по тексту
/v1/images/generations — текстовый prompt + size для точного указания выходных размеров.API редактирования изображений
/v1/images/edits — multipart-загрузка с инструкциями по редактированию/объединению.Доверьте интеграцию ИИ-агенту
Скопируйте этот prompt и вставьте его в Codex / Claude Code / Cursor
Сначала он загрузит текстовую версию этой страницы (добавьте .md к любому URL документации), а затем напишет код под стек вашего проекта — таймаут, рендеринг base64, сжатие перед загрузкой и 30 допустимых значений size уже заложены в требования.
Выполните интеграцию / диагностику генерации (text-to-image) и редактирования изображений с помощью gpt-image-2.5-vip в этом проекте (
gpt-image-2.5-flare-vip/gpt-image-2-vipимеют одинаковую стоимость и формат вызова; сделайте …Прочтите документацию перед тем, как писать код: получите https://docs.apiyi.com/en/api-capabilities/gpt-image-2-vip/overview.md для текстовой версии этой страницы. Для более подробной информации о параметрах добавьте
.mdк …
- Таймаут: увеличьте таймаут клиента до 360 секунд. API генерации изображений синхронные — task ID отсутствует, поэтому при отключении клиента результат будет потерян …
Всего 7 требований. Используйте кнопку ниже, чтобы скопировать полный prompt.
От каких проблем избавляет этот prompt
От каких проблем избавляет этот prompt
Ключевые отличия от gpt-image-2-all
gpt-image-2-vip и gpt-image-2-all — оба представляют собой реверс-инжиниринговые каналы с одинаковым кодом вызова (-all $0.025/изображение, -vip $0.03/изображение). Они зеркально повторяют друг друга — замените поле model в том же запросе, и поведение будет практически идентичным. Отличия:
Сравнение трёх моделей -vip (измерено 2026-09-09)
Сравнение по трём вариантам на 253 запросах с одинаковыми каналом и token, где менялось только имя модели, а также 26 последовательных пограничных вызовов. Контракт идентичен ячейка в ячейку; различаются только строки ниже.quality и прозрачный фон ранее отклонялись gpt-image-2-vip, но теперь принимаются — это поведение канала, а не обязательство; ориентируйтесь на фактический ответ.
Основные возможности
Фиксированный размер вывода
size поддерживает 30 распространенных размеров — hero-изображения для e-commerce, шаблоны постеров, обои 4K — все выводится с точным числом пикселей.4K с высоким разрешением
Единая стоимость для всех размеров
Тот же формат вызова, что и -all
gpt-image-2-all — переключайте модели, меняя только строку model.Высококачественный рендеринг текста
Поддержка китайских prompt
Редактирование на естественном языке
Поддержка стандартных эндпоинтов
/images/generations и /images/editsЦены
- Фиксированная цена $0.03 за изображение для всех 30 размеров — без доплаты за 4K Detail
- За неуспешные запросы плата не взимается (ошибки аутентификации, ошибки валидации параметров)
- Для N изображений вызывайте API N раз параллельно
Настройка группы
gpt-image-2-vip находится в группе Default — дополнительная группа не требуется. В обратном канале сейчас стабильно доступен ресурс, поэтому сценарий с резервной группой для предприятий, как у официального релея gpt-image-2, не предусмотрен.
Нужен детерминированный вывод URL → переключитесь на группу image2_OSS
Согласно измерениям, проведённым в июле 2026 года в группе по умолчанию, gpt-image-2-vip (и gpt-image-2-all) возвращают b64_json, если response_format не указан; явно передайте response_format: "url", чтобы получить URL изображения. Формат вывода группы по умолчанию не гарантируется — исторически по умолчанию использовался url с переходом на b64_json при нагрузке, а в разных версиях канала формат менялся.
Если ваш бизнес зависит от вывода URL (запись URL непосредственно в базу данных, отображение во frontend по URL, base64 неприемлем), переключите группу своего токена на image2_OSS — группу, специально предназначенную для детерминированного вывода URL, с коэффициентом 1x (без надбавки), действующим для обеих обратных моделей gpt-image-2-vip и gpt-image-2-all. Она гарантирует, что ответ всегда содержит URL изображения и никогда не переключается на base64.
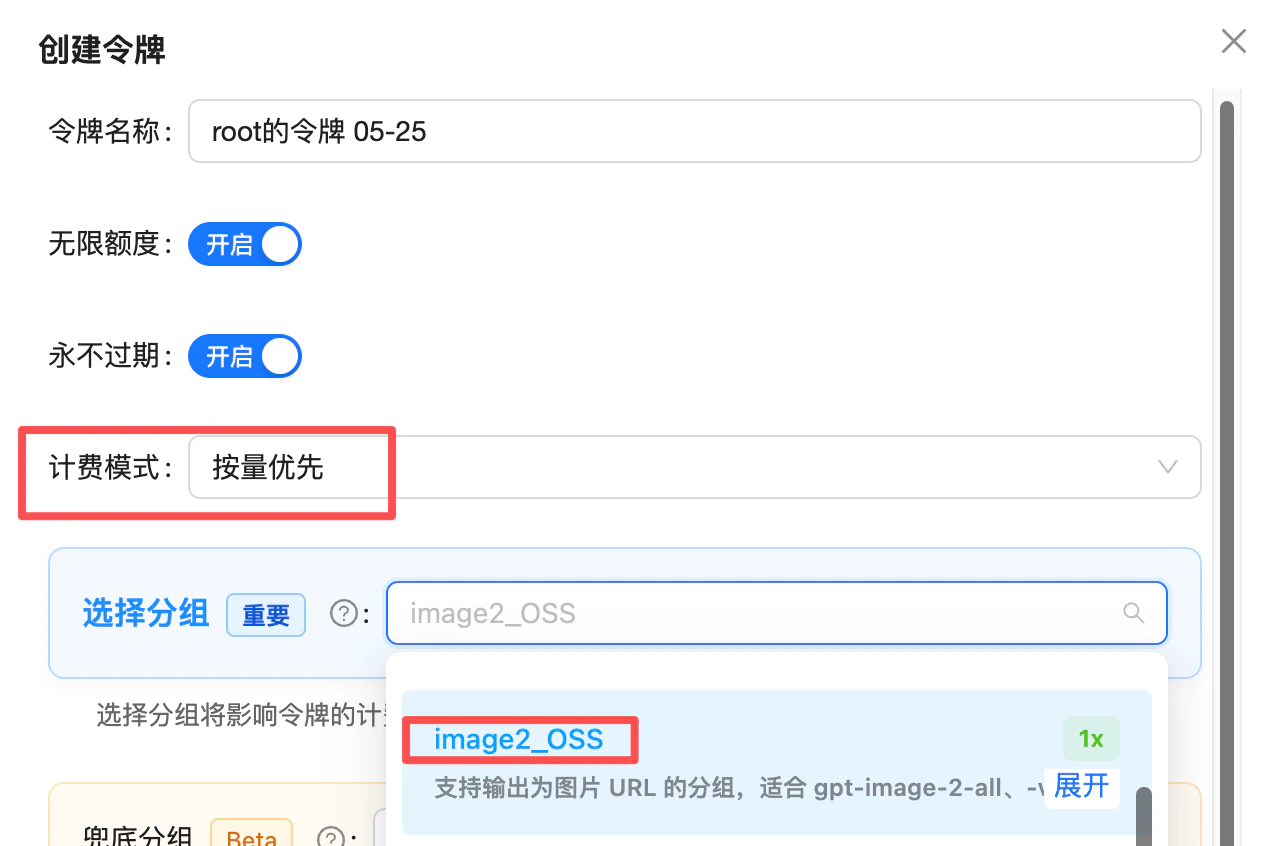
Token creation: set billing mode to "pay-as-you-go first" and pick the image2_OSS group (1x) — use it when you need deterministic URL output
image2Enterprise: /en/live/2026-04/image2-enterprise-stable
Технические характеристики
Эндпоинты
gpt-image-2-vip совместим с теми же самыми двумя эндпоинтами, что и gpt-image-2-all. Просто замените поле model и при необходимости добавьте size:
Поддерживаемые размеры (полная таблица из 30 размеров)
gpt-image-2-vip поддерживает 10 соотношений сторон × 3 уровня разрешения = 30 размеров. Передавайте size: "WIDTHxHEIGHT" (строчный ASCII x) непосредственно в теле запроса.
1K Fast — черновики и низкозатратные итерации
2K Recommended — уровень по умолчанию (большинство рабочих материалов)
4K Detail — материалы крупного формата
size; quality необязателен, см. выше):
Рекомендации
Сжимайте входные изображения до размера менее 1.5MB (редактирование изображений / объединение нескольких изображений)
shell_api_error / Unknown error чаще всего вызваны слишком большими входными данными — сжатие заметно повышает вероятность успеха и сокращает задержку. Выходное разрешение определяется полем size, а не размером входных данных — уменьшение входного изображения лишь ускоряет процесс и не ухудшает качество. Добавление 4K / 8K в prompt не создаст изображение 4K; разрешение задаётся через size, а не лишним текстом в prompt.Выбирайте уровень размера по итоговому материалу
Используйте строчную ASCII x в размере
"size": "1536x1024" — не 1536×1024 и не прописную X.quality поддерживается до high; не передавайте n
quality при тестировании (это не является обязательством): две модели 2.5 поддерживают все шесть уровней (xhigh / max открыты 2026-09-10), gpt-image-2-vip поддерживает до high и отклоняет xhigh / max; 2.5 high соответствует только gpt-image-2-vip medium, а 2.5 max соответствует своему high. n независимо от этого возвращает 1 изображение на вызов — для нескольких изображений выполняйте параллельные запросы.Используйте тайм-аут 300s
Выбирайте формат ответа по необходимости
b64_json для прямого отображения в веб-интерфейсе; url — для хранения / пересылки на стороне сервера.Используйте общий код с -all
model между gpt-image-2-all и gpt-image-2-vip. Используйте vip, когда нужен фиксированный размер, и переключайтесь обратно на -all для наиболее быстрой итерации.Коды ошибок и повторные попытки
- Тайм-аут запроса начиная с 300 секунд (с запасом; обычно 90–150 с, но для 4K Detail и хвостов пиковых нагрузок требуется больше)
- Используйте экспоненциальную задержку для ошибок 5xx и тайм-аутов (рекомендуется 2–3 повторные попытки)
- Для отладки регистрируйте заголовок ответа
request-id
FAQ
Можно ли использовать один и тот же код для vip и -all?
Можно ли использовать один и тот же код для vip и -all?
/v1/images/generations, /v1/images/edits) используют одинаковые поля запроса, поля ответа и поведение префикса b64_json. Отличия только следующие:- Поле
model:gpt-image-2-vip↔gpt-image-2-all - Поле
size: vip принимает набор из 30 размеров; -all отклоняетsize(размер указывается в промпте)
if model == 'vip': payload['size'] = ....Почему vip работает намного медленнее?
Почему vip работает намного медленнее?
gpt-image-2-vip использует обратный канал Adobe (Firefly) — обычно 90–150 секунд, что сопоставимо с официальным gpt-image-2 (100–120 с), но медленнее, чем ChatGPT-web-line gpt-image-2-all (30–60 с). Для задач, чувствительных к задержке, предпочтительнее gpt-image-2-all; переключайтесь на vip только когда вам необходимы фиксированный размер или 4K.Размер должен в точности соответствовать таблице? Что произойдёт, если я отправлю 1024x768?
Размер должен в точности соответствовать таблице? Что произойдёт, если я отправлю 1024x768?
1024x1024 / 1600x1600), остальные выравниваются по 16 (1920x1080 → 1920×1088), а значения меньше допустимого увеличиваются до минимального размера стороны (512x512 → 816×816). Полученное изображение может не соответствовать запросу, поэтому всегда используйте 30 предустановленных размеров, когда важен точный размер.Почему 4K часто возвращает ошибку 500? Как получить стабильный 4K?
Почему 4K часто возвращает ошибку 500? Как получить стабильный 4K?
3840x2160 / 2880x2880) ошибки status_code: 500 возникают чаще, а upstream возвращает invalid_request_error:- Предпочитайте 2K Recommended (например,
2048x1360/2048x2048) — значительно более высокий процент успешных запросов при той же стоимости $0.03/изображение - Отправляйте меньше входных изображений для img2img / объединения нескольких изображений — обратный канал испытывает сложности при большой входной нагрузке, что дополнительно повышает частоту ошибок 4K; предварительное сжатие каждого входного изображения до размера менее 1.5MB также помогает
- Для гарантированного 4K — переключитесь на официальный прокси
gpt-image-2+ группуimage2Enterprise. 4K через официальный прокси стоит дороже (~$0.3+/изображение), но работает значительно стабильнее — это подходящий вариант, когда выдача в 4K является обязательным требованием.
Нужно ли сжимать входные изображения? Поможет ли указание 4K / 8K в промпте?
Нужно ли сжимать входные изображения? Поможет ли указание 4K / 8K в промпте?
shell_api_error / Unknown error чаще всего вызываются слишком большими входными данными, а сжатие заметно повышает процент успешных запросов и уменьшает задержку. Примечание: 1.5MB — это рекомендуемый предел для надёжности и скорости; значение 10MB, указанное выше в FAQ, является жёстким лимитом шлюза.Не беспокойтесь, что сжатие ухудшит качество — разрешение результата определяется параметром size, а не размером входных данных. Уменьшение входного изображения лишь ускоряет обработку.Указание 4K / 8K в промпте фактически не создаёт изображение в 4K. Если в промпте указано 8K ultra HD, но для size задано значение 1024x1024, вы всё равно получите изображение качества 1K. Для 4K задайте это в поле size — 1K / 2K / 4K стоят одинаково — фиксированные $0.03 за изображение для всех 30 размеров.📖 Источник: /en/live/2026-05/gpt-image-2-vip-unknown-errorДействительно ли за 4K не взимается дополнительная плата?
Действительно ли за 4K не взимается дополнительная плата?
3840x2160 / 2880x2880 и т. д.) стоит столько же — $0.03 за изображение, как 1K и 2K.Поддерживается ли n? Что произойдёт, если передать n=3?
Поддерживается ли n? Что произойдёт, если передать n=3?
n=3 в запросе, тарификация составит 0.03 × 3 = $0.09, но фактически будет возвращено только 1 изображение. Уберите поле n, чтобы избежать лишних расходов.Если содержимое отклонено или модель отвечает «I can't do that», взимается ли плата?
Если содержимое отклонено или модель отвечает «I can't do that», взимается ли плата?
- ✅ Предварительно фильтруйте запросы и предупреждайте пользователей: добавьте фильтр ключевых слов и сценариев на frontend или шлюзе (имена реальных людей, персонажи, защищённые авторским правом, чувствительные темы) и показывайте в интерфейсе подсказку вроде «Запросы о знаменитостях и объектах интеллектуальной собственности могут завершиться ошибкой и всё равно тарифицироваться по политике upstream». Это значительно сокращает лишние расходы.
- ✅ Ежемесячное возмещение для потребительских продуктов: мы понимаем, что продукты для конечных пользователей не могут полностью ограничивать ввод. Если ваши ежемесячные расходы достаточно велики ($1000+/месяц), вы можете ежемесячно объединять логи (вызовы с небольшой задержкой обычно являются мягкими отказами) и обратиться в поддержку за разовым ручным начислением кредита — не нужно подавать отдельные обращения по каждому вызову.
Нужно ли добавлять префикс data:image/png;base64, к b64_json?
Нужно ли добавлять префикс data:image/png;base64, к b64_json?
b64_json содержит необработанный base64 без префикса data: — декодируйте его для записи в файл или самостоятельно добавьте префикс перед отображением; в более ранних версиях префикс присутствовал. Добавьте в код проверку startsWith('data:'): если префикс присутствует, используйте значение напрямую как img src; если нет — сначала декодируйте его или добавьте префикс. Это предотвращает повторное добавление префикса и декодирование строки с префиксом в повреждённое изображение.Каковы максимальный размер эталонного изображения и поддерживаемые форматы?
Каковы максимальный размер эталонного изображения и поддерживаемые форматы?
png / jpg / webp. Слишком большие изображения могут достигать лимитов шлюза. Каждое изображение при объединении нескольких изображений должно соответствовать этому ограничению.Как долго действуют возвращаемые URL изображений? Нужно ли их скачивать?
Как долго действуют возвращаемые URL изображений? Нужно ли их скачивать?
url в ответе в режиме url — это ссылка на CDN R2, срок действия которой истекает примерно через 1 день (24 часа); запросы после этого будут возвращать ошибку 404.Настоятельно рекомендуется вскоре после генерации скачивать созданные изображения и сохранять их в собственном объектном хранилище (S3 / OSS / R2), CDN или базе данных.Поддерживается ли потоковая передача?
Поддерживается ли потоковая передача?
Можно ли использовать официальный SDK OpenAI?
Можно ли использовать официальный SDK OpenAI?
base_url на https://api.apiyi.com/v1 и задайте для api_key ваш APIYI token. client.images.generate(model="gpt-image-2.5-vip", size="2048x1360", prompt=...) работает напрямую.Можно ли по-прежнему генерировать изображения через /v1/chat/completions?
Можно ли по-прежнему генерировать изображения через /v1/chat/completions?
/v1/images/generations и /v1/images/edits (они стабильнее, а тот же код работает с gpt-image-2 официального релея).Стиль на основе чата имеет смысл только в двух сценариях: итеративное редактирование в несколько ходов или непосредственная передача URL изображений из интернета. Обратите внимание: если намерение создать изображение неоднозначно, модель может вернуть обычный текст вместо изображения (добавьте в начало промпта фиксированный префикс вроде «Сгенерируй изображение:», чтобы явно указать это намерение).Полный список параметров см. в справочнике API на основе чата.Когда следует переключиться на официальный gpt-image-2?
Когда следует переключиться на официальный gpt-image-2?
quality), используйте официальный gpt-image-2.5-flare / sunburst / gpt-image-2. См. Сравнение официального и обратного каналов.Связанная документация
- Обзор GPT-Image-2-All — Более доступная родственная модель ($0.025/изображение) с более быстрой и стабильной генерацией, идеально подходящая, когда нет необходимости фиксировать размер и достаточно 1K–1.5K
- ⚖️ Сравнение: official и reverse — Наглядное руководство по выбору в сравнении с официальной
gpt-image-2(охватывает-all/-vip) - Песочница Text-to-Image — Совместимый с
/v1/images/generationsэндпоинт, передайтеsizeдля фиксации размеров - Песочница редактирования изображений — Объединение нескольких изображений и редактирование с помощью
/v1/images/edits - GPT-Image-2.5 / 2 Official — Для точного inpainting по маске / строгого соответствия полям OpenAI API
- Подробный разбор: запуск GPT-image-2.5 — Запуск двух моделей поколения 2.5
- Обзор серии GPT-Image — Сравнение официальных моделей GPT-Image
- Руководство по API — Общие правила выполнения вызовов
gpt-image-2.