

Карточки моделей
Полное сравнение цен, описание тарификации за запрос и на основе tokens, а также рекомендации по выбору tokens см. в разделе Цены серии Nano Banana.
Примеры результатов
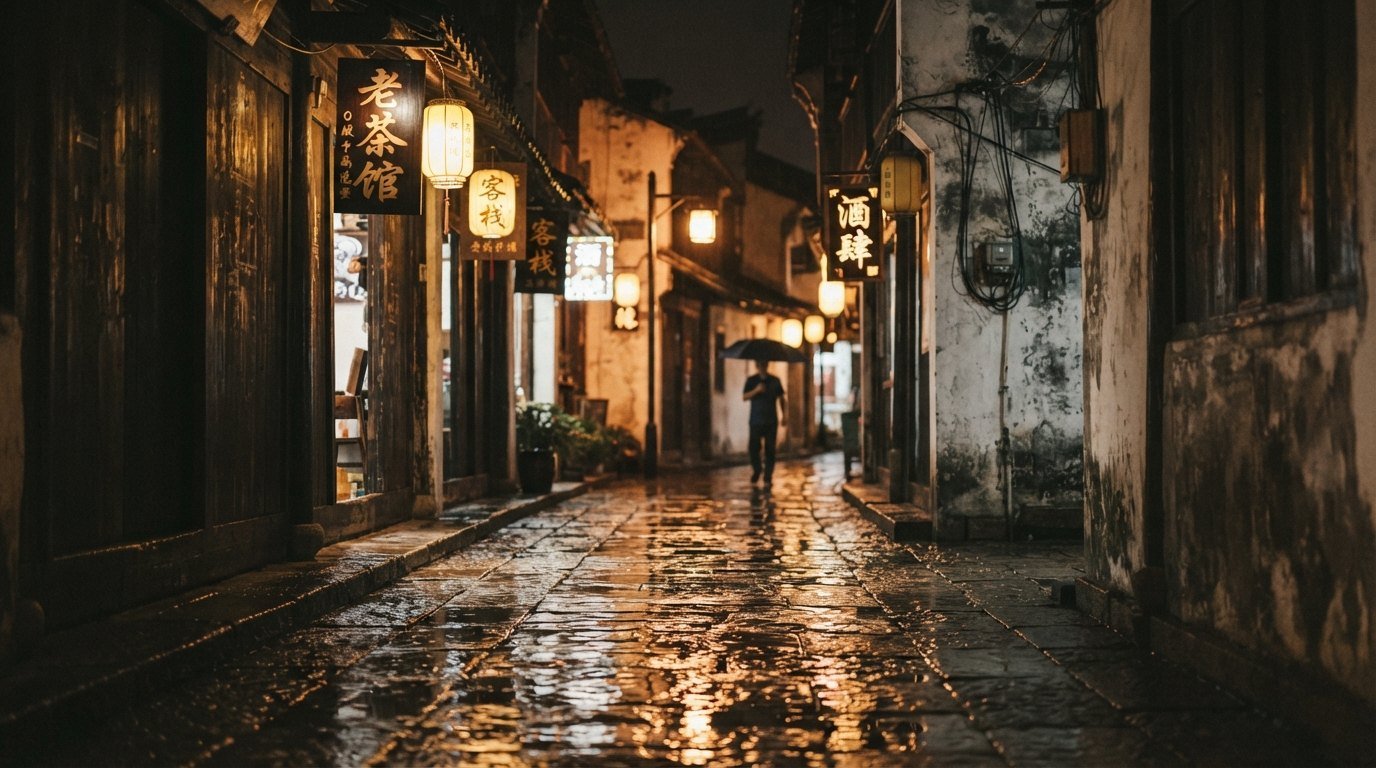
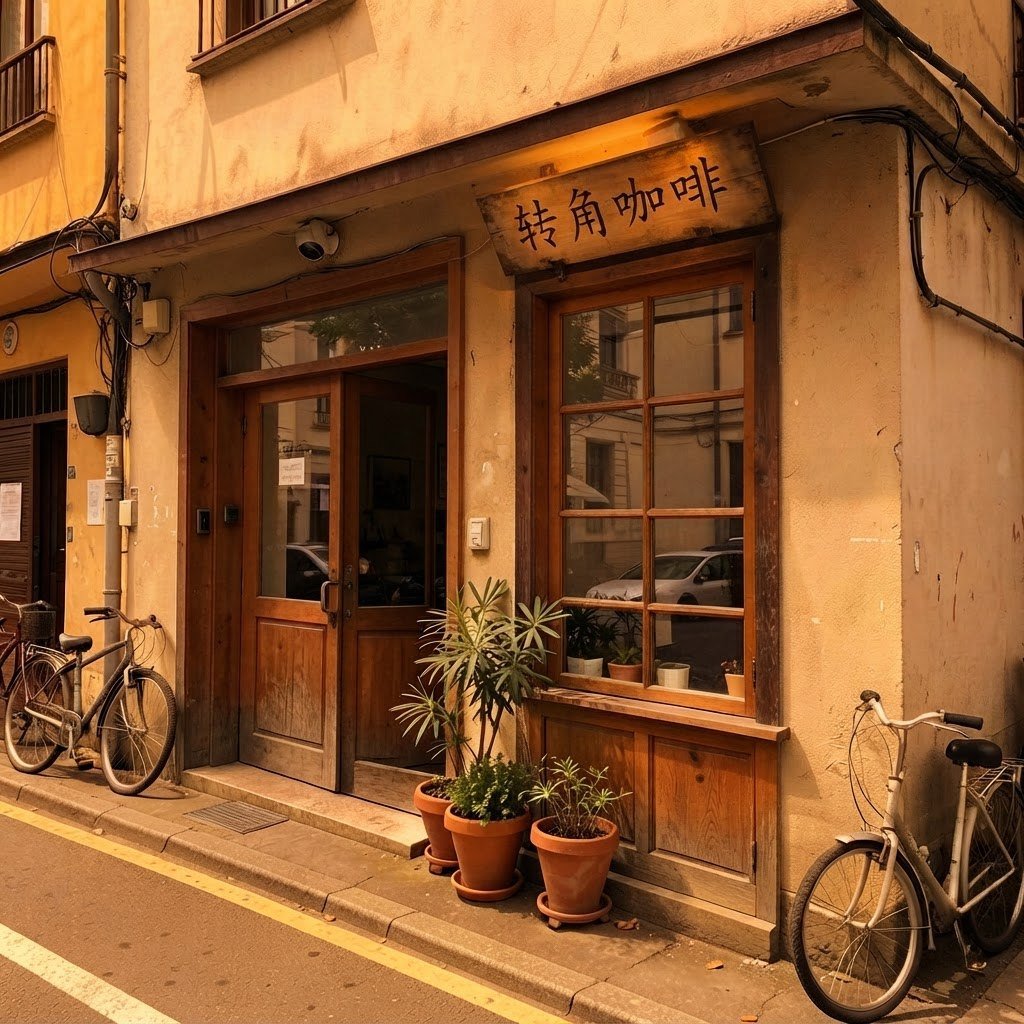
Оба изображения ниже созданы с помощью Nano Banana 2 Lite (gemini-3.1-flash-lite-image) и демонстрируют результаты преобразования текста в изображение и редактирования изображений. Они показывают возможности только этой модели и этих prompt, но не гарантируют такую же производительность у других моделей серии.
Преобразование текста в изображение · уличная сцена, 16:9 (только prompt: переулок в старом городе после дождя, тёплые уличные фонари отражаются в мокрой брусчатке, мимо проходит человек с зонтом, кадрирование 16:9): 8,3 с, применяется aspectRatio: 16:9, и надписи 老茶馆, 客栈 и 酒肆 хорошо читаются.
Управление размером
- Сохранение соотношения сторон исходного изображения: просто не указывайте
aspectRatio; при редактировании нескольких изображений приоритет имеет размер последнего изображения - Разрешение
imageSize: поддерживаются1K/2K/4K- Nano Banana (Gen 1) поддерживает только 1K
- Nano Banana 2 добавляет 512px
- Nano Banana 2 Lite поддерживает только 1K (без 2K/4K/512px)
Как интегрировать
Официальная документация
- Официальная документация Google:
ai.google.dev/gemini-api/docs/image-generation - Чтобы интегрировать APIYI, просто замените URL запроса + ключ на данные APIYI; все остальные параметры совпадают с официальными
Проверка официального статуса (диагностика проблем на стороне вышестоящего сервиса)
Серия Nano Banana работает на базе AIStudio / Gemini API от Google. В редких случаях размытый результат или сбой при создании изображений в разрешении 2K / 4K могут быть связаны с проблемами на стороне Google, а не на уровне интеграции — вы можете проверить официальную страницу статуса Google (скопируйте ссылку и откройте её самостоятельно):aistudio.google.com/status.
Например, 19 июня 2026 года на этой странице сообщалось о «проблемах с Nano Banana»: у Nano Banana 2 / Pro в Gemini API и AI Studio возникали проблемы при разрешении 2K или 4K. Если вы столкнулись с похожими симптомами, сначала сравните ситуацию с данными на официальной странице статуса, чтобы быстро определить, вызвана ли проблема сбоем на стороне вышестоящего сервиса.
APIYI обслуживает серию Nano Banana через два канала — AIStudio и Vertex, обеспечивая резервирование: если в одном официальном канале возникают проблемы, его может заменить другой, чтобы сервис оставался доступным.
Поддерживаемые эндпоинты
- Рекомендуемый эндпоинт (нативный Gemini):
https://api.apiyi.com/v1beta/models/gemini-3-pro-image:generateContent - Поддерживаются вызовы через режим, совместимый с OpenAI (
/v1/chat/completions; передавайте Base64 или общедоступную ссылку черезimage_url) /v1/image/generationsне поддерживается
Формат для разработки (рекомендация по умолчанию)
- [Рекомендуется] Используйте формат нативного эндпоинта Google
- Изображения: загружайте в формате Base64, скачивайте и размещайте повторно
- Способ вызова: синхронные многопоточные вызовы; асинхронные вызовы пока не поддерживаются
Требования к входным изображениям
- Одно изображение не может превышать 7MB (правило Google); если импорт выполняется через Google Cloud Storage, лимит на каждый файл составляет 30MB
- До 14 изображений на prompt
- Поддерживаемые типы MIME:
image/png,image/jpeg,image/webp,image/heic,image/heif(форматjpgуже поддерживается APIYI) - Увеличение размера при кодировании в Base64: преобразование изображения в Base64 увеличивает его размер примерно на 33.3% (изображение размером 7MB становится примерно 9.3MB)
- Лимит APIYI: общий объем изображений, загруженных в одном запросе, должен быть менее 100MB — все вызовы являются синхронными, а слишком большие payload могут вызвать резкий рост потребления памяти
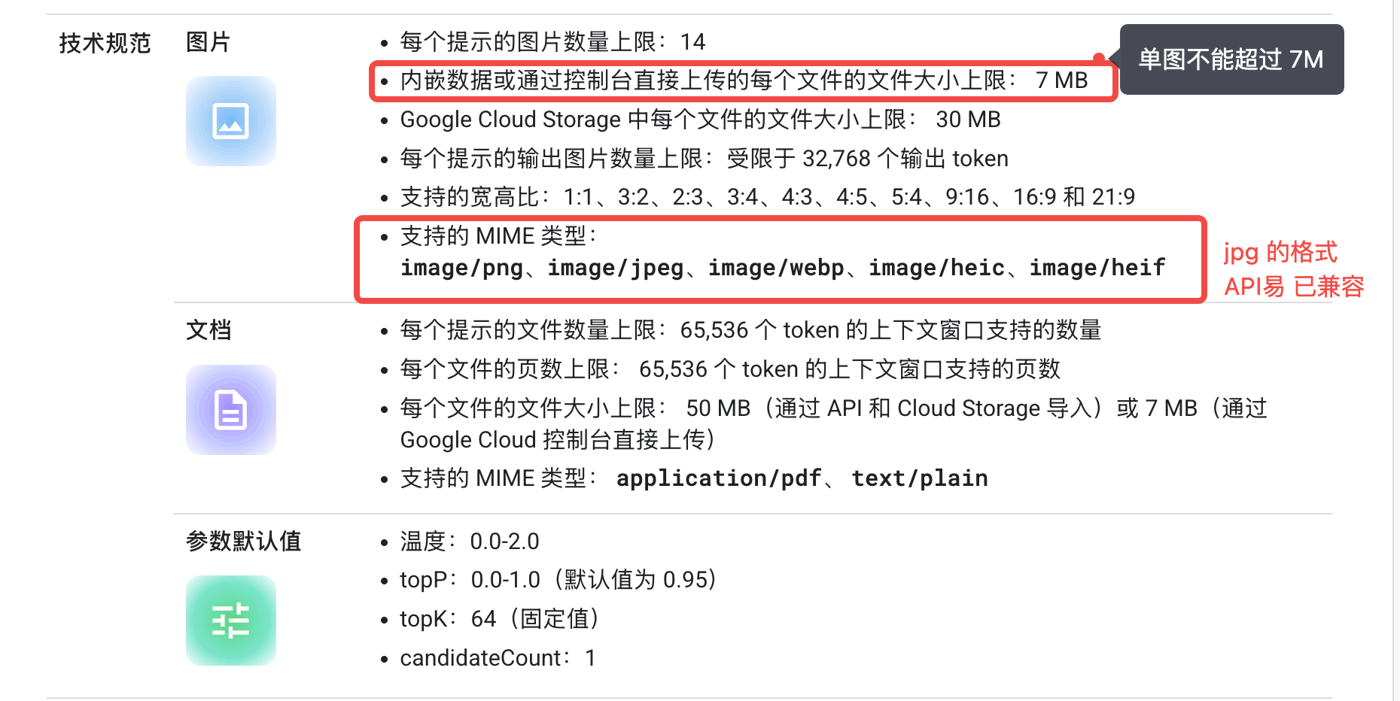
Google official technical specs: inline / console upload per-file limit is 7MB, supporting png/jpeg/webp/heic/heif
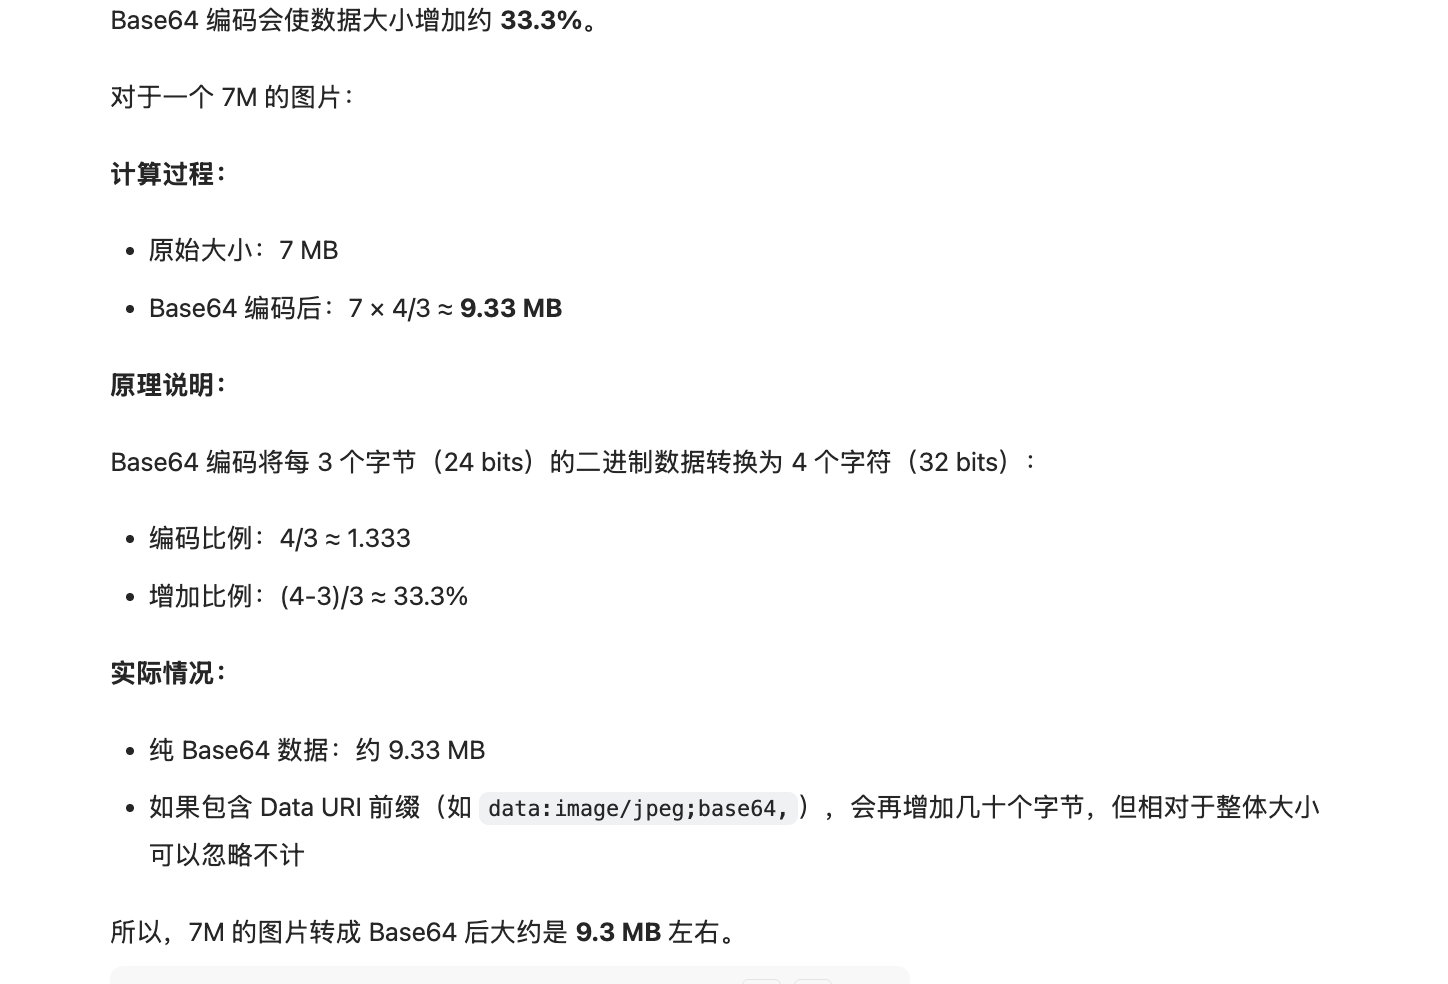
Base64 encoding increases size by about 33.3%: a 7MB image is roughly equal to 9.3MB
docs.cloud.google.com/vertex-ai/generative-ai/docs/models/gemini/3-pro-image
Ввод изображений по URL
Помимо base64, нативный эндпоинт Gemini принимает URL изображения напрямую черезfileData.fileUri. Это позволяет сохранить размер тела запроса небольшим и избавляет вас от необходимости самостоятельно скачивать и кодировать изображение.
При передаче по URL изображение скачивают серверы Google, а не APIYI. Успешность и скорость обработки зависят от доступности хоста вашего изображения для Google, а не от того, открывается ли ссылка в вашем браузере. Приведенные ниже требования и шаги по устранению неполадок основаны на реальных обращениях в службу поддержки и наших собственных тестах (2026-10-16, NB2 / Pro, три маршрута).
Требования к подходящей ссылке
В наших тестах успешно работали ссылки как
http://, так и https://. Ссылки gs:// (Google Cloud Storage) поддерживаются только некоторыми маршрутами, поэтому мы не рекомендуем использовать их через APIYI.Формат запроса
- Несколько изображений: по одному
fileDataна каждое изображение по порядку внутриparts. Их также можно комбинировать сinlineData; в наших тестах два изображения по URL и одно изображение в base64 в рамках одного запроса сгенерировались штатно mimeType: укажите реальный формат изображения. В наших тестах текущие маршруты всё равно считывали изображение, даже когда он был указан неверно или отсутствовал, но полагаться на это не стоит- Имена полей: используйте camelCase
fileData/fileUri/mimeTypeв соответствии с официальной документацией Google. Варианты в snake_casefile_data/file_uriв настоящее время также принимаются
Проверьте, что референсное изображение действительно прочитано
Некоторые маршруты не возвращают ошибку при сбое загрузки: они возвращают 200, генерируют изображение и тарифицируют как обычно, но результат полностью игнорирует ваше изображение. Поэтому не полагайтесь только на код ответа. ПроверяйтеusageMetadata.promptTokensDetails в ответе:
IMAGE означает, что изображение было прочитано (при настройках по умолчанию мы зафиксировали около 1120 tokens на изображение в Nano Banana 2 и около 560 в Pro). Если присутствует только TEXT, Google не получил изображение, и результат не будет на него опираться. В приведенном ниже примере на Python эта проверка включена.
Как проявляются ошибки загрузки
Полный разбор кейса с таймаутом см. в статье Редактирование изображений возвращает ошибку «Unable to Process Input Image»?, где также рассматривается ошибка с пустым base64, с которой ее часто путают.
Пример Curl (fileUri)
Пример на Python (fileUri)
Может ли OpenAI-совместимый эндпоинт принимать URL?
Да. Передайте публичную ссылку в качествеimage_url в /v1/chat/completions; в наших тестах и Nano Banana 2, и Pro успешно считали изображение и выполнили генерацию в штатном режиме. Применяются те же требования к ссылкам. Для многоэтапного редактирования или точного контроля разрешения по-прежнему рекомендуется использовать нативный эндпоинт.
Основы тарификации (Важно)
- Длительность синхронного вызова: Pro / 2 при 4K требуют разумного времени генерации примерно 30–150s
- Отключение при тайм-ауте всё равно влечёт начисление платы: например, если генерация занимает 120s, но клиент задаёт тайм-аут 100s и отключается, с вас всё равно взимается плата
- 429 / 503 не тарифицируются: за неудачные запросы плата не взимается (мы стараемся не заставлять клиентов ждать или оставаться без изображения)
- Отказы из-за политики безопасности контента всё равно влекут начисление платы: когда во входных данных клиента есть проблемы с безопасностью контента и Google отказывает в генерации изображения, за код статуса 200 всё равно взимается плата — см. обработку ошибок и план гарантии ниже
Google Search grounding is charged on top of the per-call price
Pro supports thegoogleSearch tool (grounding triggered in 3/3 test runs, returning full groundingMetadata), useful for weather cards, stock charts, and anything else that needs live information.
But the search call fee is added on top of the $0.09 per-call price, not included in it:
Image Search grounding (
searchTypes.imageSearch) does not work on Pro — 0/2 runs triggered it, and imageSearchQueries never appeared in groundingMetadata. It is exclusive to Nano Banana 2 (gemini-3.1-flash-image); see Nano Banana 2 · Three parameters that affect billing.thinkingLevel не влияет на Pro — не копируйте его из NB2
generationConfig.thinkingConfig.thinkingLevel предназначен исключительно для серии Nano Banana 2. Передача high в Pro:
- Не вызывает ошибку — запрос нормально возвращает 200
- Но не влияет: измеренные значения
thoughtsTokenCountнаходились в диапазоне 108–156, полностью перекрывая диапазон 130–159, наблюдаемый без параметра - Рассуждение в Pro всегда включено и не подлежит настройке, как прямо указано в документации Google
Настройки таймаута (Важно)
Генерация изображений 4K занимает больше времени в целом, включая такие этапы, как загрузка изображения, обработка API и скачивание изображения Base64 (наш backend выставляет тарификацию по времени обработки API). В обычных условиях 4K занимает около 50s (без учета polling), но если клиент задаст timeout слишком коротким, он разорвёт соединение преждевременно до завершения генерации и вернёт ошибку: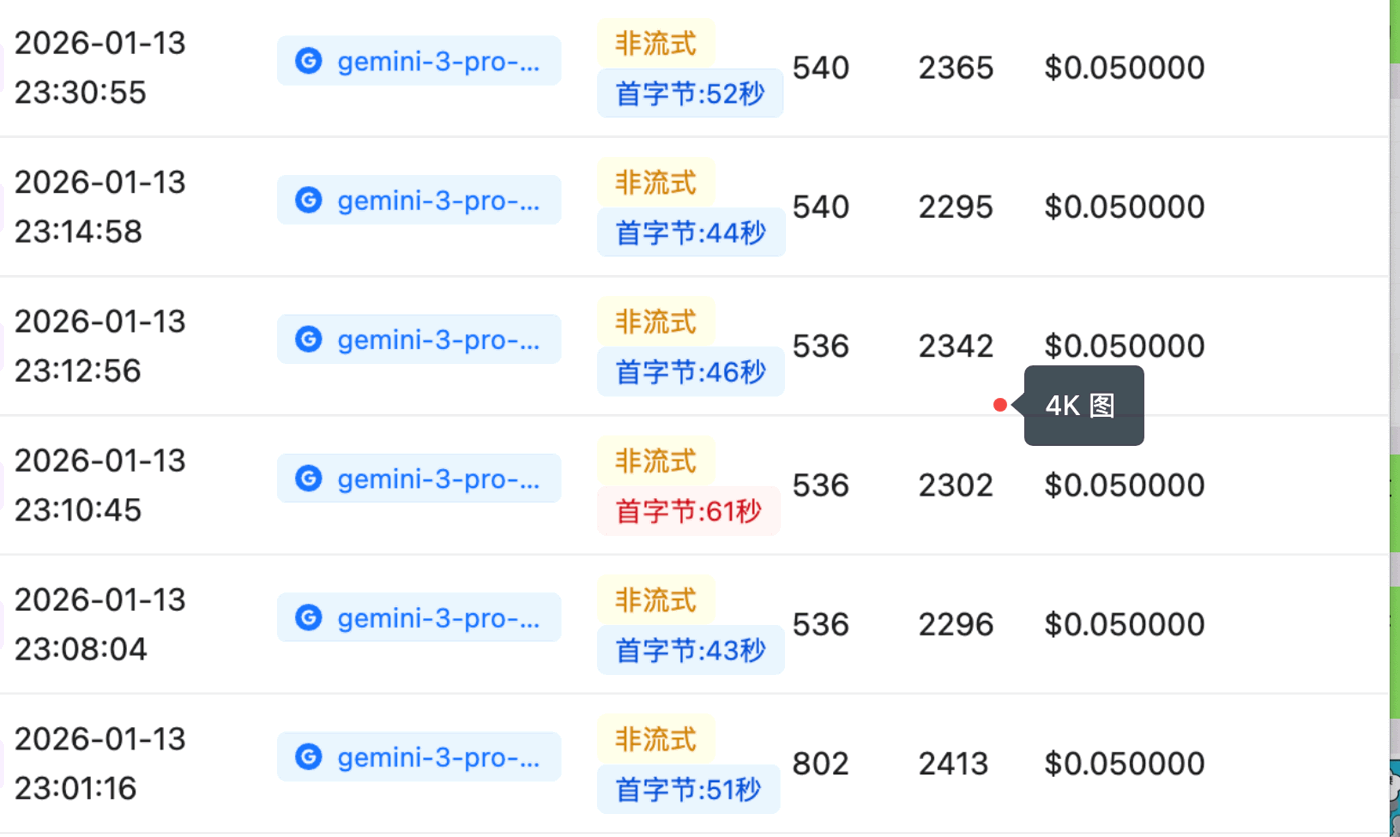
Call logs: time-to-first-byte for 4K generation is about 43–61s, so the default 120s timeout is too tight
Многошаговое редактирование в диалоге (поддерживается нативно; обратные модели — нет)
Серия Nano Banana использует нативный формат Gemini и поддерживает полноценное многошаговое редактирование в диалоге: добавляйте сгенерированное на каждом шаге изображение обратно вcontents как role: "model" inlineData, а затем отправляйте следующую инструкцию пользователя. Модель редактирует изображение с учётом всей истории диалога и сохраняет внесённые изменения (например, сначала перекрашивает диван, а затем добавляет аксессуар — предыдущее изменение сохраняется).
Это принципиально отличается от «обратных» моделей изображений — учтите это перед интеграцией:
Проверено: если добавить предыдущее изображение как ход с ролью
model, Nano Banana 2 (gemini-3.1-flash-image) корректно продолжает редактирование и сохраняет внесённые изменения; обратная модель читает референсное изображение только из последнего сообщения пользователя, поэтому сохранение истории диалога не позволяет выполнять многошаговое редактирование.contents):
Всегда перебирайте parts, чтобы получить изображение — никогда не индексируйте его
parts — это неоднородный массив: он может содержать только сегмент изображения или чередовать текстовые и сегменты изображения, и ни длина, ни порядок не гарантируются. Жёстко заданный доступ вроде parts[0] / parts[1] поэтому наверняка будет периодически приводить к сбоям.
В ходе тестирования было замечено три варианта структуры:
Текстовый сегмент может появиться по нескольким причинам: если включить
TEXT в responseModalities, или если prompt просит модель объяснить саму себя, модель возвращает текст вместе с изображением — и то, окажется ли этот текст до изображения или после него, тоже не фиксировано. Поэтому индекс, на котором находится изображение, не является постоянным, и один и тот же код может получать разные структуры в разных запросах.
Правильный подход — выбирать по форме поля, а не по позиции. Обратите внимание, что нужно брать последний inlineData, а не первый — сложные задачи возвращают несколько изображений, и последнее является финальной версией (см. следующий раздел):
Почему ответы иногда содержат несколько изображений
При вызовеgemini-3-pro-image вы иногда можете увидеть несколько частей изображения в одном ответе (в ходе тестирования наблюдалось 2–10), что соответствует периодически возникающим записям об output-token 6000+ (и даже пятизначным значениям) в ваших логах. Это не аномалия: в официальной документации Google указано, что у image-моделей Gemini 3 «Thinking» включён по умолчанию (в API его нельзя отключить), модель создаёт промежуточные изображения для проверки композиции и логики, эти черновики появляются в parts вместе с финальной версией, а «последнее изображение внутри Thinking также является окончательно отрисованным изображением» (официальная документация: ai.google.dev/gemini-api/docs/image-generation). На основе наших тестов в июле 2026 года (нативный формат Google generateContent):
Срабатывание определяется сложностью задачи в prompt, а не самим «редактированием изображения». Несколько изображений по-прежнему находятся в одном кандидате (а не в нескольких кандидатах), и каждое из них — это полноценное изображение: это последовательные черновики одного и того же дизайна в процессе рассуждения (одна и та же композиция, немного разные детали), а последняя часть — финальная версия. Эти черновики возвращаются как обычные части изображения (с полем
thoughtSignature, без флага thought: true); в документации Google сказано, что Thinking создаёт максимум два промежуточных изображения, но на сложных задачах мы наблюдали до 10.
Влияние на тарификацию: каждое изображение тарифицируется фиксированным количеством token (1120 token за изображение при разрешении 1K/2K, 2000 при 4K), поэтому output token растут строго линейно с количеством изображений. Периодическая запись 6000+ (вплоть до ~13,5k в крайних случаях) output-token в ваших логах — это просто ответ с 4–10 изображениями, а не аномалия тарификации.
Рекомендуемый код для последующей обработки:
- Всегда итерируйтесь по частям — не предполагайте, что на каждый ответ приходится одно изображение; любая логика подсчёта или сохранения по изображениям должна опираться на фактическое количество частей
- Берите последнее изображение, если нужно только одно: более ранние черновики имеют незавершённые детали и немного более низкое качество, поэтому не выбирайте первое
- Управление количеством изображений через prompt в основном неэффективно (в тестировании инструкции вроде «выведи только одно изображение» игнорировались) — обрабатывайте это в коде
- Ответы с несколькими изображениями занимают 35–142 с (при разрешении 1K, дольше при большем числе изображений), заметно больше, чем ответы с одним изображением — сохраняйте рекомендации по тайм-ауту выше (≥ 5 минут)
Часто задаваемые вопросы
Руководство по обработке ошибок
Три ключевых индикатора для диагностики неудачных генераций, политик модерации контента и дружественных стратегий составления prompt
Обязательные к прочтению распространённые вопросы разработчика
Устранение неполадок при неудачных генерациях и ответы на распространённые вопросы
План гарантии при неудачной генерации
Для сбоев, не вызванных вашим вводом, кредиты возмещаются в соответствии с количеством неудачных запросов
Почему я получаю connection reset by peer / write_response_body_failed (500)?
Почему я получаю connection reset by peer / write_response_body_failed (500)?
Полный текст ошибки выглядит так:Это обычно вызвано загрузкой изображений слишком большого размера — тело запроса становится слишком большим, и соединение обрывается. Следуйте этим рекомендациям:
- Ограничьте количество изображений: соблюдайте официальные правила (не более 14 изображений на prompt — см. официальную спецификацию выше).
- Ограничьте размер каждого изображения: держите каждое изображение меньше 5MB — официальный лимит на одно изображение составляет 7MB, а кодирование base64 увеличивает размер примерно на 1/3, поэтому оставляйте запас.
- Сжимайте на frontend перед загрузкой: сжимайте изображения на frontend (или через серверный relay) перед отправкой в API — обычная практика заключается в ограничении длинной стороны, конвертации в JPEG/WebP и настройке параметра качества.
- Переключитесь на ввод через URL: нативный формат Gemini поддерживает передачу image URL через
fileData.fileUri, полностью обходя слишком большие base64-тела запроса — см. Ввод изображения по URL выше.
Сценарии использования
- Клиенты AI-чатов: такие клиенты, как Cherry Studio, можно настроить для генерации изображений напрямую через APIYI
- Проверка генерации: быстро проверьте производительность модели в чат-клиенте или в консоли
Расширенные сценарии
- Хотите загружать изображения по URL? Используйте
fileData.fileUriна нативном эндпоинте Gemini илиimage_urlна OpenAI-совместимом эндпоинте. Серверы Google скачивают изображение, поэтому хост имеет значение. Требования к ссылкам, способы обнаружения ошибок загрузки и примеры кода см. в разделе Ввод изображений по URL выше. - Хотите получать URL для скачивания напрямую (вместо Base64)? Используйте группу NB-OSS — см. Группа Nano Banana OSS.