

模型卡
完整價格對比、按次/按量計費與令牌選擇建議,見 Nano Banana 系列價格總覽。
實測效果展示
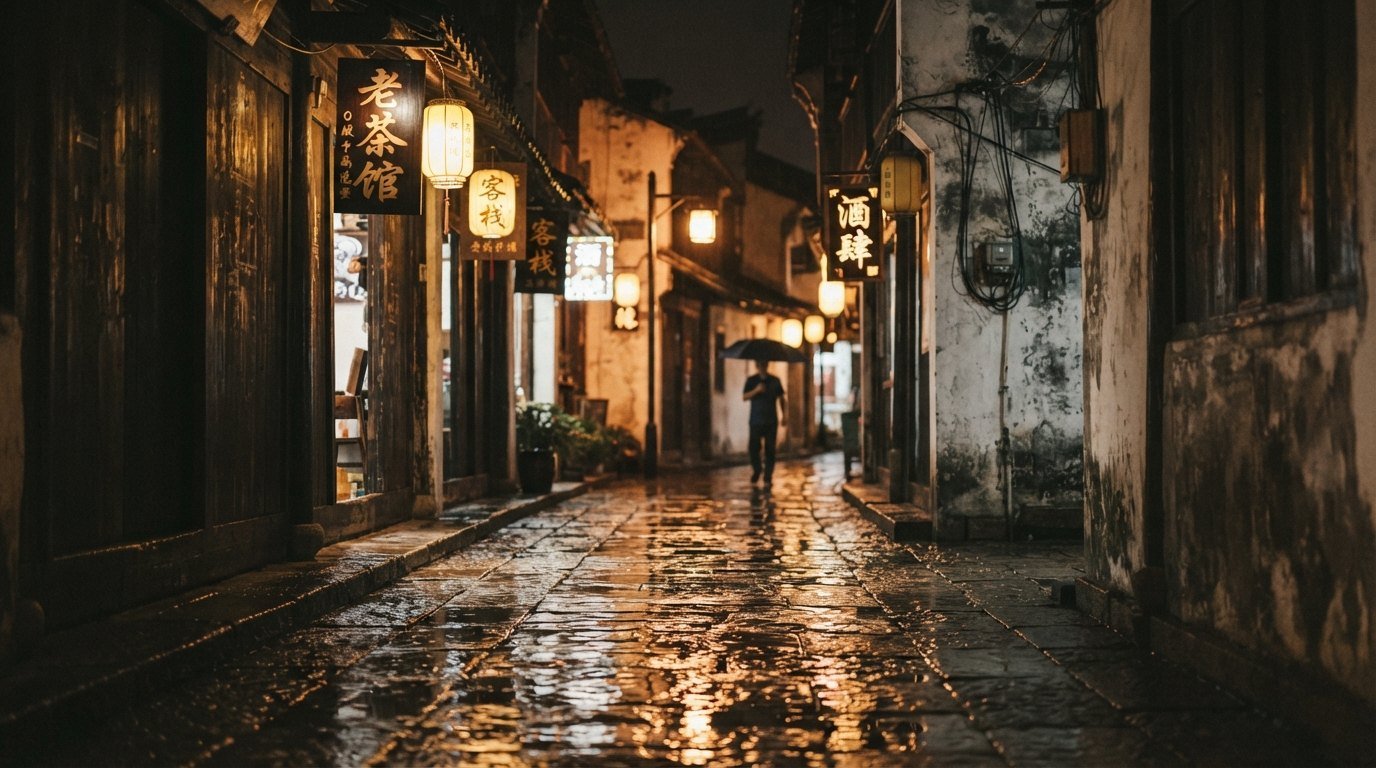
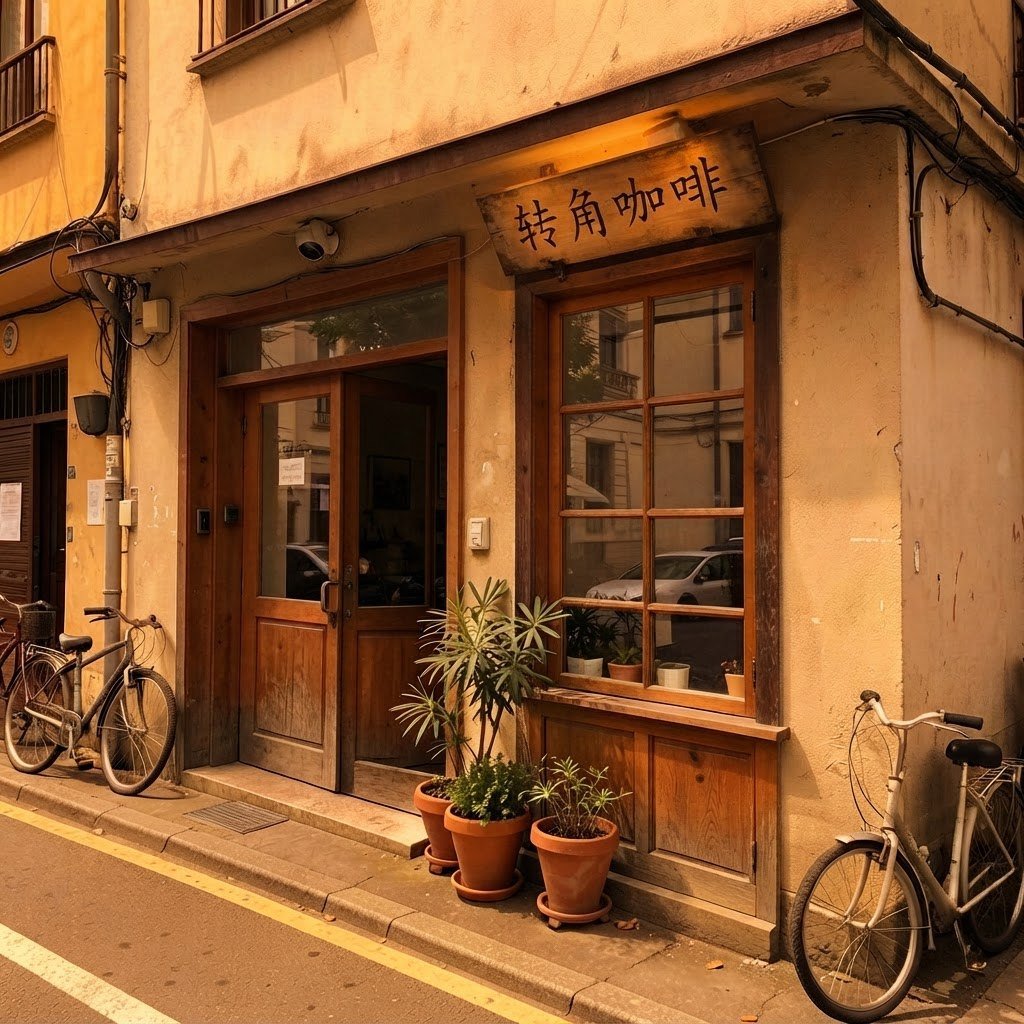
以下兩張圖均由 Nano Banana 2 Lite(gemini-3.1-flash-lite-image)實測生成,展示文生圖與圖片編輯效果;結果僅代表該模型和本次提示詞,不等同於系列內其他模型的效果保證。
文生圖 · 16:9 寬幅街景(僅提示詞:雨後老城巷子,青石板積水映著暖黃路燈,遠處有人撐傘走過,16:9 構圖):8.3 秒出圖,aspectRatio: 16:9 真實生效,招牌上的「老茶館」「客棧」「酒肆」都能讀清。
尺寸控制
- 遵循原圖比例:不傳
aspectRatio即可;在多圖編輯場景裡,以最後一張圖的尺寸為準 - 解析度
imageSize:支援1K/2K/4K- Nano Banana(第一代)僅支援 1K
- Nano Banana 2 新增 512px
- Nano Banana 2 Lite 僅支援 1K(不支援 2K/4K/512px)
接入方式
官方文件
- 谷歌官方文件:
ai.google.dev/gemini-api/docs/image-generation - 接入 API易 只需把請求地址 + KEY 替換為 API易 的即可,其餘引數與官方一致
官方狀態查詢(排查上游故障)
Nano Banana 系列底層依賴谷歌 AIStudio / Gemini API。少數情況下 2K / 4K 出圖變糊或報錯,可能是谷歌官方側的問題、而非接入層——可在谷歌官方狀態頁核對(請自行復制訪問):aistudio.google.com/status。
例如 2026 年 6 月 19 日,該頁報道過「Issues with Nano Banana」:Gemini API 與 AI Studio 上的 Nano Banana 2 / Pro 在 2K 或 4K 解析度下出現問題。遇到類似現象,先比對官方狀態頁即可快速判斷是否為上游故障。
API易 為 Nano Banana 系列提供 AIStudio + Vertex 雙通道冗餘:官方單通道異常時可由另一通道頂上,儘量保障服務可用性。
端點支援
- 推薦端點(Gemini 原生):
https://api.apiyi.com/v1beta/models/gemini-3-pro-image:generateContent - 支援 OpenAI 相容模式呼叫(
/v1/chat/completions,可用image_url傳 Base64 或公網連結) - 不支援
/v1/image/generations
開發格式(預設推薦)
- 【推薦】使用谷歌原生端點格式
- 圖片:Base64 上傳、下載轉存
- 呼叫方式:同步多執行緒呼叫,暫不支援非同步呼叫
輸入圖片要求
- 單圖不能超過 7MB(谷歌規則);若通過 Google Cloud Storage 匯入,單檔案上限 30MB
- 每個提示最多 14 張圖
- 支援的 MIME 型別:
image/png、image/jpeg、image/webp、image/heic、image/heif(jpg格式 API易 已相容) - Base64 體積膨脹:圖片轉 Base64 後體積增加約 33.3%(7MB 的圖約為 9.3MB)
- API易 限制:單次請求上傳圖片總量需低於 100MB——均為同步呼叫,過大會導致記憶體爆炸
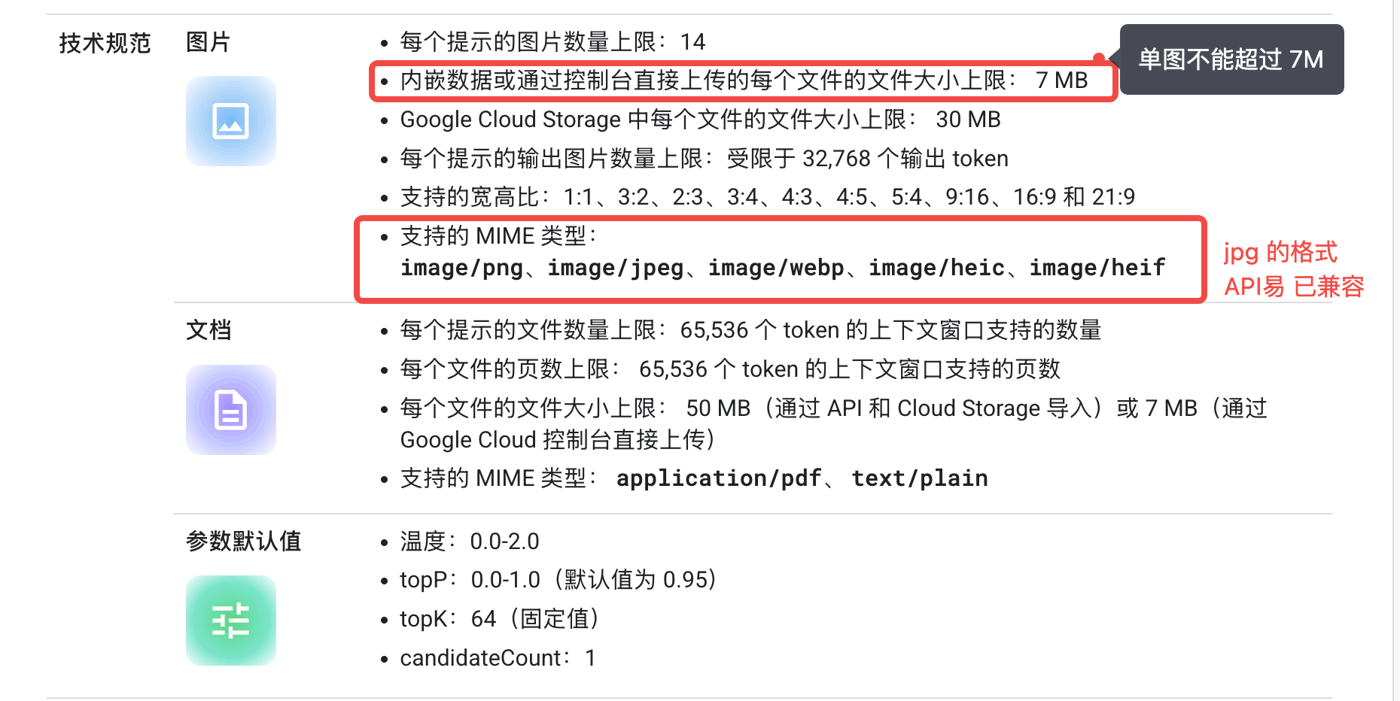
谷歌官方技術規範:內嵌/控制台上傳單檔案上限 7MB,支援 png/jpeg/webp/heic/heif
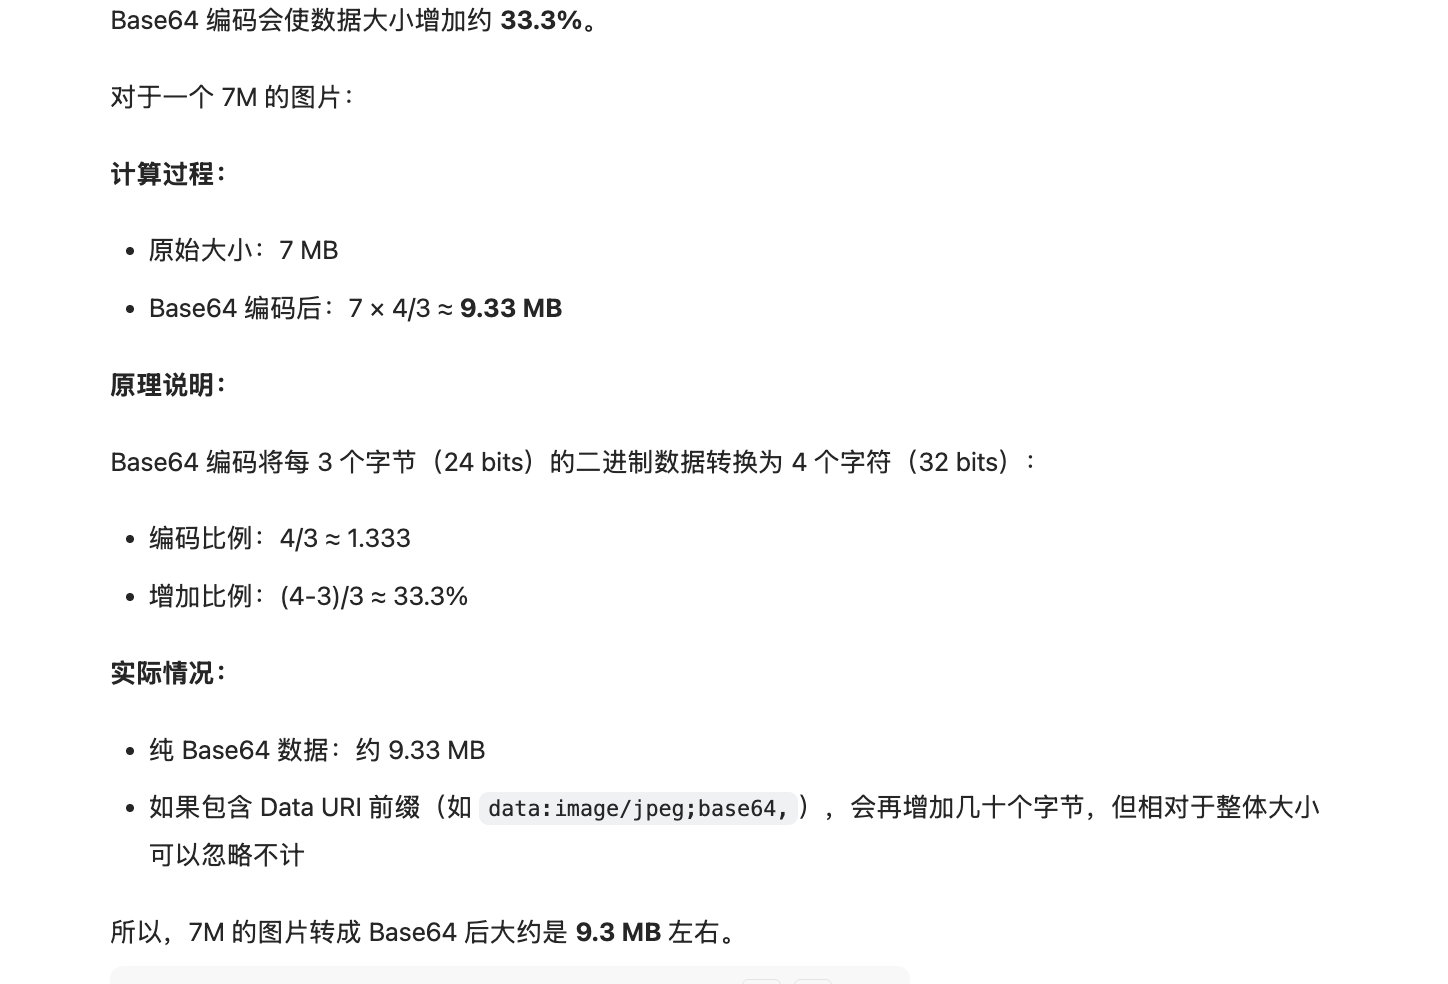
Base64 編碼使體積增加約 33.3%:7MB 圖片約等於 9.3MB
docs.cloud.google.com/vertex-ai/generative-ai/docs/models/gemini/3-pro-image
URL 圖片輸入說明
除了 Base64,Gemini 原生端點還支援用fileData.fileUri 直接傳圖片 URL,請求體更小,也省去自己下載、轉碼的步驟。
URL 傳圖時,圖片是由谷歌的伺服器去下載的,不是 API易。 所以能不能用、快不快,取決於谷歌訪問你的圖床順不順,跟你自己的瀏覽器能不能開啟沒有關係。下面這些要求和排查方法,都是從實際工單和實測(2026-10-16,NB2 / Pro,三條線路)裡總結出來的。
什麼樣的連結能用
http:// 和 https:// 連結實測都可以。gs://(Google Cloud Storage)只有部分線路能讀,不建議通過 API易 使用。請求寫法
- 多張圖:每張一個
fileData,按順序放在parts裡。也可以和inlineData混用,實測 2 張 URL 加 1 張 Base64 一次請求正常出圖 mimeType按圖片的真實格式寫。實測寫錯或不寫,當前線路也能識別,但不要依賴這一點- 欄位命名:推薦與谷歌官方一致的駝峰寫法
fileData/fileUri/mimeType。實測下劃線寫法file_data/file_uri目前也能識別
確認參考圖真的被讀到了
連結拉取失敗時,有的線路不會報錯:返回 200、照常出圖並計費,但結果完全沒參考你的圖。所以不能只看狀態碼,要看響應裡的usageMetadata.promptTokensDetails:
IMAGE 這一項,說明圖片讀到了(實測預設設定下 Nano Banana 2 每張約 1120 tokens,Pro 每張約 560 tokens);只有 TEXT,說明谷歌沒拿到圖,這次結果不會參考原圖。下面的 Python 示例已經內建了這道檢查。
拉圖失敗的幾種表現
超時問題的完整案例見 圖片編輯報 Unable to process input image 怎麼辦(同頁也講了 Base64 為空導致的報錯,兩者經常被混淆)。
Curl 示例(fileUri)
Python 示例(fileUri)
OpenAI 相容端點能傳 URL 嗎
可以。/v1/chat/completions 裡用 image_url 傳公網連結,實測 Nano Banana 2 與 Pro 都能正常讀到圖片並出圖。連結要求與上文相同;需要多輪編輯、精確控制解析度等能力時,仍推薦原生端點。
計費基礎(重要)
- 同步呼叫耗時:Pro / 2 在 4K 下的合理生成時間約 30–150s
- 超時主動斷開仍計費:例如生成需 120s,但客戶端把超時設為 100s 主動斷開,仍會計費
- 429 / 503 不收費:請求不通時不計費(我們儘量不讓客戶久等、不卡死遲遲不出圖)
- 內容安全拒絕仍計費:客戶輸入存在內容安全問題、谷歌拒絕出圖時,狀態碼 200 仍會計費——詳見下方錯誤處理與保障計劃
Google 搜尋接地會在按次價之外另收費
Pro 支援googleSearch 工具(實測 3/3 觸發接地,返回完整 groundingMetadata),用來畫天氣卡、股價圖這類需要即時資訊的圖。
但搜尋呼叫費是加在 $0.09 按次價之上的,不含在裡面:
圖片搜尋接地(
searchTypes.imageSearch)在 Pro 上不生效,實測 0/2 未觸發,groundingMetadata 裡不出現 imageSearchQueries。這是 Nano Banana 2(gemini-3.1-flash-image)的獨有能力,用法見 Nano Banana 2 · 影響計費的三個引數。thinkingLevel 對 Pro 無效,不要照搬 NB2 的寫法
generationConfig.thinkingConfig.thinkingLevel 是 Nano Banana 2 系列獨有的開關。給 Pro 傳 high:
- 不報錯,請求正常返回 200
- 但完全不生效:實測
thoughtsTokenCount在 108–156 之間,與不傳時的 130–159 完全重疊 - Pro 的思考恆開、無法調節,官方文件亦如此說明
超時設定(重要)
4K 出圖的整體耗時較長,包含圖片上傳、API 處理、Base64 圖片下載等環節(我們後臺按 API 處理用時計費)。正常情況下 4K 用時約 50s(不含輪詢),但客戶端若把超時設得過短,就會在出圖完成前主動斷開並報錯: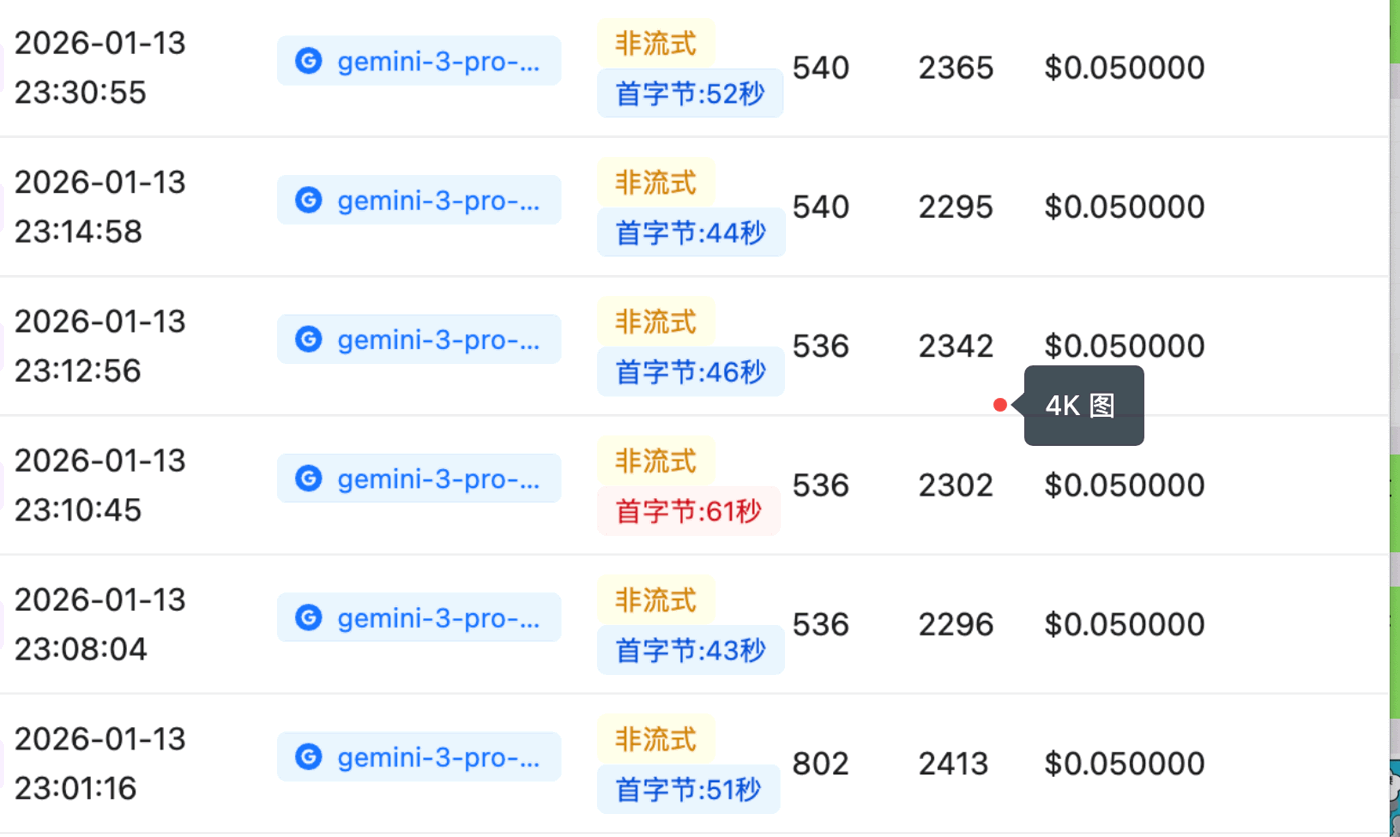
呼叫日誌:4K 出圖首位元組耗時約 43–61s,預設 120s 超時偏緊
多輪對話式編輯(原生支援,逆向不支援)
Nano Banana 系列走 Gemini 原生格式,支援真正的對話式多輪編輯:把模型每一輪產出的圖作為role: "model" 的 inlineData 回填進 contents,再發下一條 user 指令,模型會基於完整對話歷史繼續修改並累積效果(如先改沙發顏色、再加配飾,上一步的改動會保留)。
這一點與”逆向”影像模型有本質區別,接入前務必分清:
實測:把上一張圖放進
model 角色回填,Nano Banana 2(gemini-3.1-flash-image)能正確基於它繼續編輯並累積修改;而逆向模型只認最後一條 user 訊息裡的參考圖,靠保留對話歷史做多輪在逆向上無效。contents):
取圖必須遍歷 parts,不要按下標
parts 是一個異構陣列:裡面可能只有圖片段,也可能文本段與圖片段混排,段數和順序都不做保證。因此 parts[0] / parts[1] 這類寫死下標的取法一定會間歇性失敗。
實測出現過的三種排列:
文本段的來源不止一種:
responseModalities 裡含 TEXT、提示詞要求模型給出文字說明,都會讓模型在圖片之外再返回一段文本;文本段排在圖片前還是圖片後也不固定。因此圖片落在哪個下標並非定值,同一份程式碼在不同請求下可能拿到不同結構。
正確寫法是按欄位特徵篩選,而不是按位置索引。注意取的是最後一個 inlineData 而非第一個——複雜任務下模型會返回多張圖,最後一張才是最終稿(見下一節):
偶現多圖輸出是怎麼回事
呼叫gemini-3-pro-image 時,偶爾會看到同一個響應裡返回多張圖片 part(實測 2–10 張),日誌裡對應偶發的 6000+ 乃至上萬的輸出 tokens。這不是異常:谷歌官方文件說明 Gemini 3 圖片模型預設啟用”思考”(無法在 API 中關閉),模型會生成臨時圖片來測試構圖和邏輯,這些中間稿與最終稿一併出現在 parts 裡,且”思考中的最後一張圖片也是最終渲染的圖片”(官方文件:ai.google.dev/gemini-api/docs/image-generation)。基於 2026 年 7 月實測(Google 原生 generateContent 格式):
觸發因素是提示詞的任務複雜度,不是”圖片編輯”本身。多張圖仍在同一個 candidate 內(不是多 candidates),每張都是完整的成圖——它們是思考過程中對同一設計的逐稿修正(構圖相同、細節略有差異),最後一張 part 即最終稿。這些中間稿以普通圖片 part 返回(帶
thoughtSignature 欄位、無 thought: true 標記);官方稱思考最多生成兩張臨時圖片,實測複雜任務下最多見 10 張。
對計費的影響:每張圖按固定 tokens 計費(1K/2K 解析度每張 1120 tokens,4K 每張 2000 tokens),輸出 tokens 隨圖片數嚴格線性增長。日誌裡偶發的 6000+(極端可達 1.3 萬+)輸出 tokens 就是 4–10 圖響應,不是異常計費。
下游程式碼建議:
- 必須遍歷 parts,不要假設單響應單圖;按張計數、落盤的邏輯要以實際 part 數為準
- 只要一張時取最後一張:前面的迭代稿細節未修完,品質略低,不建議取第一張
- 提示詞控制張數基本無效(實測”只輸出一張”類指令不敏感),請在程式碼層處理
- 多圖響應耗時 35–142s(1K 解析度,張數越多越久),顯著長於單圖,超時請沿用上文建議(≥ 5 分鐘)
常見問題
錯誤處理指南
出圖失敗的三大判斷指標、內容稽核政策與友好提示方案
常見開發問題必讀
出圖失敗排查與常見疑問
出圖失敗保障計劃
非主觀原因導致的失敗,按條數核算後補發額度
報錯 connection reset by peer / write_response_body_failed(500)是什麼原因?
報錯 connection reset by peer / write_response_body_failed(500)是什麼原因?
完整報錯形如:這種錯誤往往是上傳的圖片體積過大,請求體超限把連線壓崩了。請按以下最佳實踐處理:
- 控制圖片張數:保持在官方規則內(每個提示最多 14 張圖,見上方官方技術規範)。
- 控制單圖體積:每張圖儘量不要超過 5MB——官方單圖上限為 7MB,且 base64 編碼後體積還會膨脹約 1/3,原圖請留足餘量。
- 前端先壓縮再上傳:在前端(或服務端中轉層)壓縮後再提交給介面,常見做法是限制最長邊、轉 JPEG/WebP 並控制品質引數。
- 改用 URL 傳圖:Gemini 原生格式支援
fileData.fileUri直接傳圖片 URL,可避開 base64 請求體過大的問題,見上文 URL 圖片輸入說明。
應用場景
- AI 對話客戶端:Cherry Studio 等客戶端可直接配置 API易 出圖
- 出圖測試:可在對話客戶端或控制台快速驗證模型效果
高階需求
- 圖片上傳想用 URL? Gemini 原生端點用
fileData.fileUri傳入,OpenAI 相容端點用image_url傳入;圖片由谷歌伺服器下載,對圖床要求較高。連結要求、拉圖失敗的判斷與程式碼示例見上文 URL 圖片輸入說明。 - 圖片下載想直接拿到 URL(而非 Base64)? 使用 NB-OSS 分組——詳見 Nano Banana OSS 分組。