Продвинутая генерация изображений: рабочий процесс и реалистичность
Та же модель, но лучший результат: что пользовательские приложения для работы с изображениями добавляют поверх API — слой переформулирования промпта, фиксацию референса, параллельную выборку с выбором vision-модели и пошаговую ретушь. Включает готовую для копирования и вставки лексику для описания реалистичности, сравнительные тесты и расчёт стоимости.
Как получить нужное изображение отвечает на вопрос: «эта попытка не удалась — как её спасти». Эта страница отвечает на следующий вопрос: как сделать так, чтобы каждая попытка приводила к нужному результату.Постоянно возникает следующий вопрос: потребительские продукты для работы с изображениями, такие как freepik.com и higgsfield.ai, работают на тех же базовых моделях, что и вы, — на тех же семействах Nano Banana, GPT-Image и FLUX, — и всё же их результаты выглядят более завершёнными. Разрыв связан не с весами модели. Он обусловлен слоем, обёрнутым вокруг модели, и этот слой можно создать самостоятельно. На этой странице показано, как это сделать.
1. Что представляют собой потребительские продукты для работы с изображениями поверх модели
Если разобрать один из таких продуктов, за пределами модели обнаружится примерно восемь слоёв. Каждый из них можно воспроизвести через API:
Что делает продукт
Какую проблему решает
Как воспроизвести это через API
Слой перезаписи промпта (улучшатель промптов)
Пользователи пишут неформально, а моделям нужно структурированное описание
Сначала вызовите текстовую модель для перезаписи, затем обратитесь к модели для работы с изображениями (раздел 2)
Предустановки стиля (десятки доступных по нажатию предустановок, а также сохранённые пользовательские)
Фиксируют эстетику, поэтому пользователям не нужно знать терминологию фотографии
Предустановка — это всего лишь константа с фрагментом промпта в вашем коде и фиксированный набор эталонных изображений
Закрепление идентичности (например, Soul ID от Higgsfield, которое обучает постоянную идентичность на 20–80 фотографиях)
Один и тот же человек остаётся неизменным в разных генерациях
Приблизить такой результат можно с помощью эталонных изображений (см. ограничения ниже)
Выборка нескольких вариантов с показом одного
Пользователь видит только лучший вариант, поэтому воспринимаемая вероятность успеха приближается к 100%
Сгенерируйте N вариантов параллельно, затем попросите визуальную модель оценить их и выбрать лучший (раздел 3, шаги 3–4)
Пошаговое редактирование
Составные инструкции надёжно дают сбои при выполнении за один запрос
Сначала зафиксируйте композицию, затем отредактируйте отдельные области и добавьте текст
Увеличение разрешения и постобработка (в 2024 году Freepik приобрела Magnific, предложив творческое увеличение в 2–16 раз)
Превращают изображение небольшого размера в формат, готовый к печати
В APIYI нет такого эндпоинта — вместо этого генерируйте изображение с высоким разрешением (см. ограничения ниже)
Негативные промпты и резервные варианты для модерации
Помогают обходить известные особенности поведения модели и перехватывать запросы, которые модерация отклонила бы
Включите фиксированные негативные формулировки в шаблон, а также предусмотрите запасной сценарий на случай сбоев модерации
Библиотека ресурсов и повторное размещение
Пользовательские изображения никогда не истекают и не исчезают
Немедленно копируйте каждый результат в собственное объектное хранилище
Два ограничения платформы, которые нужно учесть до копирования списка функций конкурента:
В APIYI нет эндпоинта для увеличения разрешения, удаления фона или восстановления лиц. Если вам нужно изображение большого размера, выберите тариф с высоким разрешением при генерации (gpt-image-2 в 4K, Nano Banana Pro в 4K), а не планируйте последующее увеличение. Для прозрачного фона используйте официальный релей gpt-image-2.5-flare / gpt-image-2.5-sunburst с background: "transparent" — он возвращает PNG с настоящим альфа-каналом (OpenAI отключила прозрачность для gpt-image-2 30.09.2026) (seedream-5-0 / seedream-5-0-pro можно только попросить создать с прозрачностью, и наличие альфа-канала не гарантируется при каждом вызове). См. раздел Как генерировать изображения с прозрачным фоном.
APIYI не предоставляет обучение LoRA или обучение идентичности. Возможность «однократно обучить и навсегда зафиксировать лицо», лежащая в основе Soul ID, может быть лишь приблизительно воспроизведена с помощью эталонных изображений: один и тот же персонаж всё равно будет немного меняться в разных сценах и при изменении освещения, а наилучший результат достигается, когда новый кадр близок к фронтальному ракурсу и исходному освещению. Для коммерческих персонажей, требующих строгой согласованности, заложите в процесс этап проверки человеком.
Сравнительный тест: одна модель, один бриф, два промпта
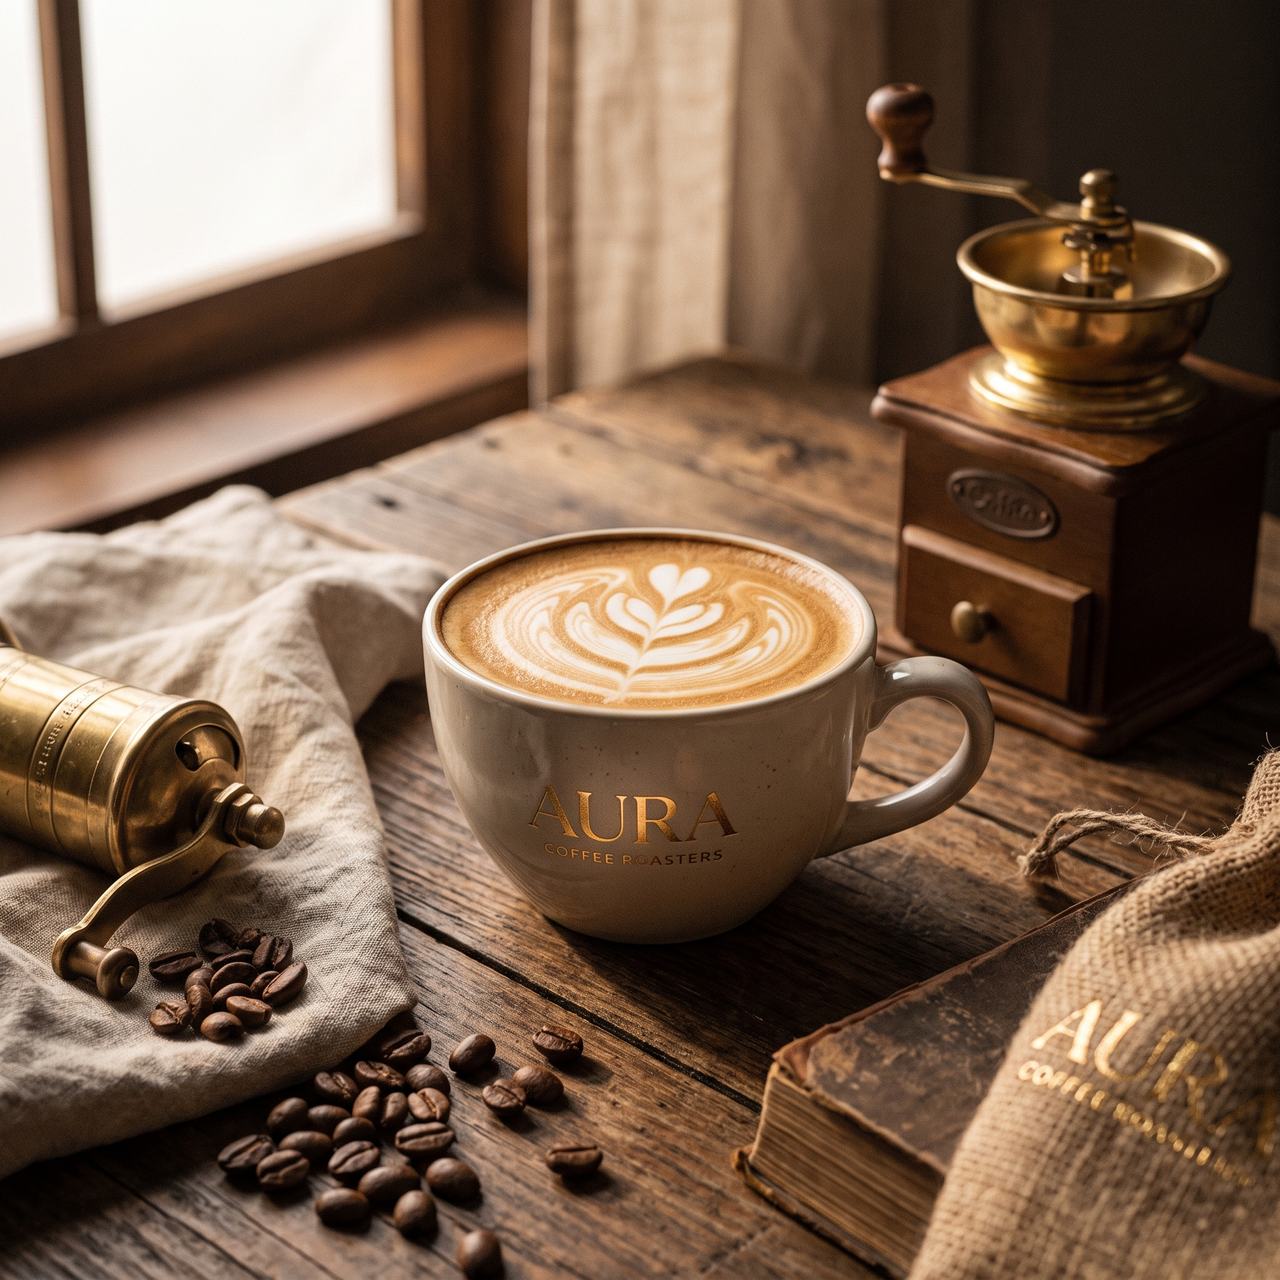
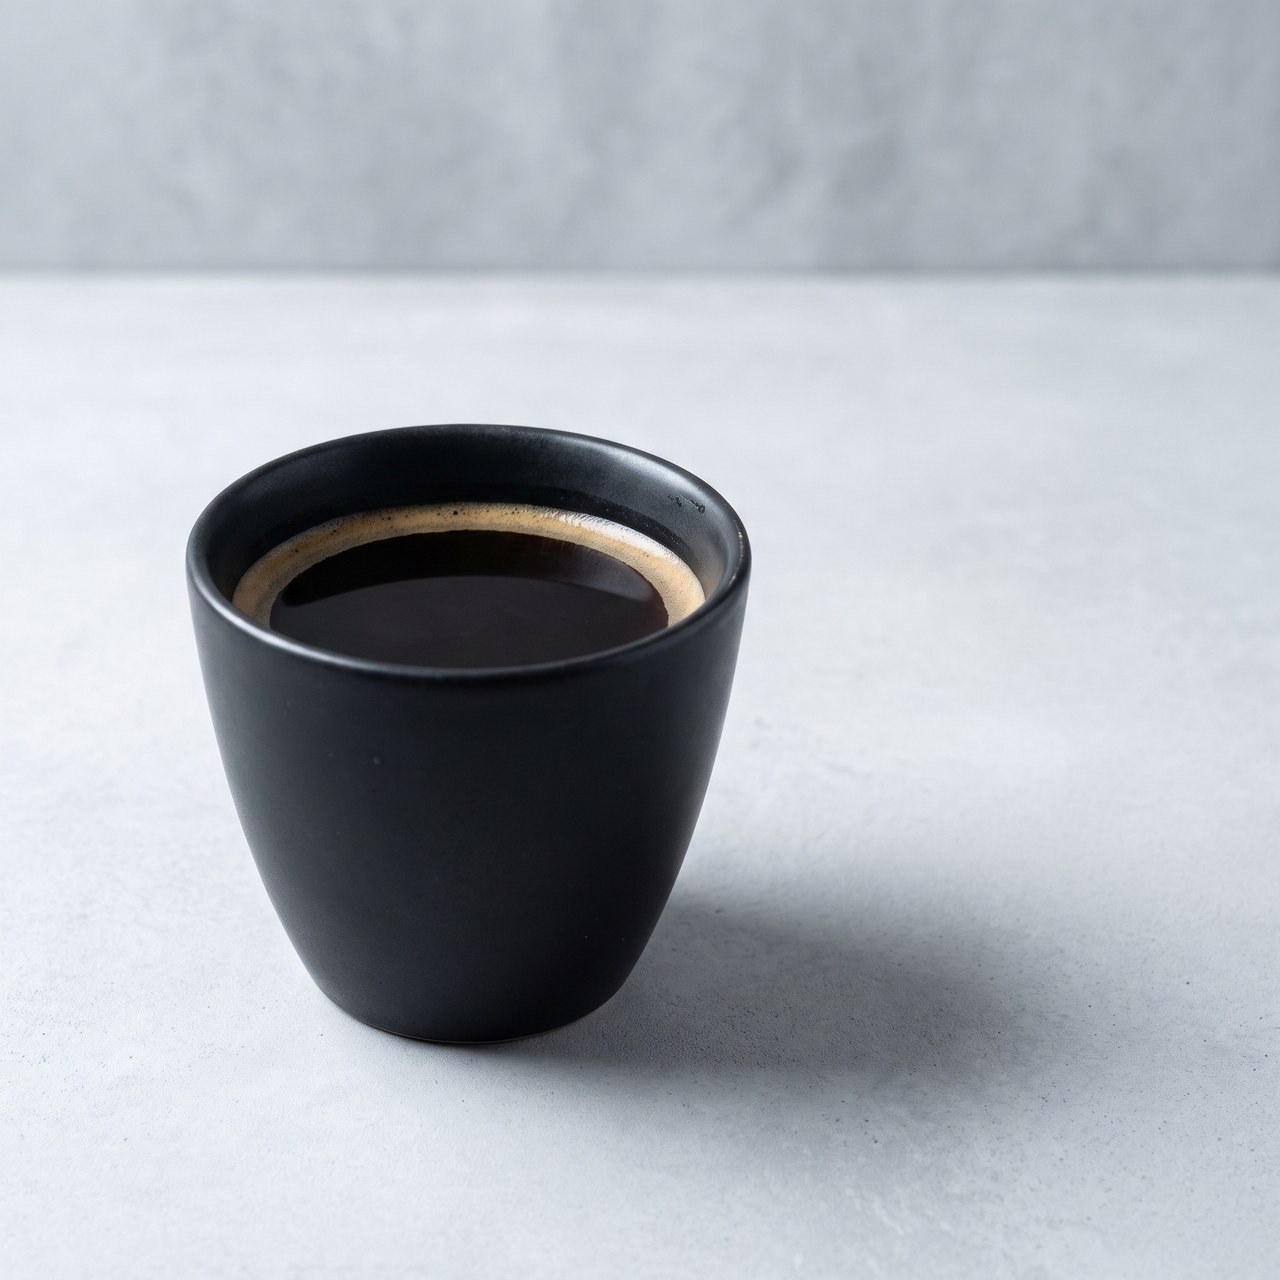
Бриф: «предметная съёмка кофе для интернет-магазина». Слева показано то, что пользователь действительно вводит; справа — тот же бриф с добавленными недостающими решениями. Оба варианта были запущены один раз на gemini-3-pro-image (Nano Banana Pro) при 2K, 1:1:
Casual prompt: 'Make me a coffee product shot, make it look nice, make it feel premium'
Structured prompt: subject, environment, light position, lens, grading, imperfections and composition all specified
Левое изображение не выглядит некрасивым, но оно непригодно для использования. Модель самостоятельно приняла множество решений, на которые никто не давал согласия: добавила кофемолку и мешок из мешковины, выбрала тёплую ностальгическую цветокоррекцию и напечатала на чашке вымышленное название бренда — автоматически сгенерированный текст такого рода делает кадр коммерчески бесполезным. Правое изображение можно сразу размещать на странице товара: нейтральный фон, понятная световая схема, которую можно описать словами, и место для текста.«Выглядит красиво» и «пригодно для использования» — разные цели. Неформальный промпт позволяет достичь только первой из них.
Шесть элементов, которые должен добавить слой переформулирования
Переформулирование не означает, что промпт нужно сделать длиннее. Оно означает заполнение недостающих решений. Промпт для изображения состоит из шести ключевых частей:
Элемент
Что происходит без него
Пример
Объект
Модель импровизирует и добавляет ненужные предметы
«Матовая чёрная керамическая чашка для пуровера, заполненная чёрным кофе на 80 %»
Окружение
Фоны выбираются случайно, поэтому изображения из одной серии не сочетаются
«Светло-серая поверхность из микроцемента, стена в том же тоне, размытая»
Свет
Плоское общее освещение сразу выглядит искусственным
«Ключевой свет от софтбокса сверху слева, под углом 45 градусов; справа — белый отражатель»
Объектив и угол
Перспектива и глубина резкости находятся вне вашего контроля
«Макрообъектив 85 мм, f/5.6, фронтальный вид с наклоном на 15 градусов вниз»
Цветокоррекция и носитель
По умолчанию результат получается перенасыщенным и похожим на рендер
«Холодный нейтральный баланс белого, низкая общая насыщенность»
Композиция
Объект всегда оказывается точно в центре
«Чашка в левой трети кадра, справа — большое свободное пространство»
Разрешение не является седьмым элементом. Разрешение результата задаётся только такими параметрами, как size / imageSize; указание «4K» или «8K» в промпте не добавляет ни одного пикселя. См. раздел Сжатие изображений и разрешение результата.
Для этой задачи достаточно недорогой быстрой текстовой модели; её стоимость незначительна по сравнению с генерацией:
import osimport requestsBASE = "https://api.apiyi.com/v1"API_KEY = os.environ["APIYI_API_KEY"] # never hard-code the keyREWRITE_SYSTEM = """You are an image prompt engineer. Rewrite the user's casual briefinto one structured image prompt.Fill in all six elements. Supply whatever is missing; never ask the user:1 Subject: material, colour, count, state2 Environment: what the background is, what is sharp and what is blurred3 Light: direction, hardness, fill or no fill — there must be one identifiable key light4 Lens and angle: focal length, aperture, camera height, tilt5 Grading and medium: white balance bias, saturation, film or digital character6 Composition: where the subject sits in the frame, where the negative space isRules:- Output only the prompt body: no explanation, no bullet points, no heading- No brand names, logos, or legible text unless the user asked for them- Never use vague quality words such as 8K, ultra HD, masterpiece, perfect- Keep any element the user specified exactly as written"""def rewrite(user_prompt: str) -> str: r = requests.post( f"{BASE}/chat/completions", headers={"Authorization": f"Bearer {API_KEY}"}, json={ "model": "gemini-3.5-flash", "messages": [ {"role": "system", "content": REWRITE_SYSTEM}, {"role": "user", "content": user_prompt}, ], }, timeout=60, ) r.raise_for_status() return r.json()["choices"][0]["message"]["content"].strip()
Обратите внимание на правило, запрещающее «8K, ультравысокое разрешение, шедевр, идеально» — в разделе 4 объясняется почему.
Соедините оставшиеся четыре уровня с уровнем перезаписи — и вы получите всю систему:
1
Перезапись: от неформального ввода к структурированному промпту
См. раздел 2. На этом этапе также нейтрализуется чувствительный контент во вводе пользователя, что заметно снижает частоту блокировки запроса на последующих этапах.
2
Привязка: референсные изображения и константа стиля
Стиль фиксируется двумя составляющими: константой стиля, добавляемой к каждому промпту (вашим пресетом), и фиксированным набором референсных изображений.Ограничения на количество референсов значительно различаются у разных семейств — уточните их для своей модели до проектирования конвейера:
Общее количество входных и выходных изображений не должно превышать 15
FLUX.2 pro / max / flex
8
input_image_2 … input_image_8; klein принимает 4, Kontext — 1
Grok Imagine
1–4
Пятое изображение возвращает ошибку 400
Необходимо соблюдать два правила: «изображение 1 / изображение 2» в промпте строго соответствуют порядку в массиве, поэтому явно указывайте, какое изображение является каким; и Grok учитывает референсные изображения только в /v1/images/edits — их передача в /v1/images/generations молча приводит к их удалению, при этом тарификация всё равно выполняется.
3
Пример: генерируйте N параллельно, не полагайтесь на n
Ощущение, что потребительский продукт «с первого раза всё сделал идеально», на самом деле создаётся за счёт того, что продукт разыгрывает несколько вариантов от вашего имени.Но серверный параметр n не влияет на большинство моделей изображений (Seedream полностью его игнорирует). Чтобы получить несколько кандидатов, отправляйте несколько запросов параллельно со стороны клиента — на страницах навыков этого сайта их количество ограничено 5 одновременно. Настраивайте количество параллельных запросов для каждого канала; некоторые начинают возвращать ошибку 429 уже при значении 2, поэтому добавьте экспоненциальную задержку.
4
Отбор: используйте модель компьютерного зрения в качестве судьи
Получив N кандидатов, необходимо выбрать один автоматически, иначе вы просто переложите выбор на пользователя.Отправьте кандидатов обратно в модель компьютерного зрения для оценки через стандартный /v1/chat/completions ввод изображений; подходящие модели перечислены в разделе Понимание изображений. Зафиксируйте критерии оценки по пяти измерениям и потребуйте ответ в формате JSON: соответствие инструкциям, структура и анатомия, корректность текста, реалистичность текстур, композиция.
Не используйте для этого /v1/rerank. bge-reranker-v2-m3 — это модель переранжирования, работающая только с текстом, которая не принимает изображения. Для оценки изображений требуется модель понимания изображений.
5
Ретушируйте и доводите результат
После фиксации композиции вносите локальные изменения — это обеспечивает гораздо более высокий процент успеха, чем одна составная инструкция:
Накопительное редактирование в несколько ходов: поддерживается на нативном эндпоинте Gemini для моделей Nano Banana (передавайте предыдущее изображение обратно как role: "model"); маршруты, созданные обратной инженерией, этого не поддерживают.
Немедленно размещайте изображения заново: каждый возвращаемый URL является временным (для FLUX — около 10 минут и без CORS; для Seedream и R2 — около 24 часов), поэтому сразу после получения загружайте изображение в собственное объектное хранилище.
import base64import jsonimport osfrom concurrent.futures import ThreadPoolExecutorimport requestsBASE = "https://api.apiyi.com"API_KEY = os.environ["APIYI_API_KEY"]HEAD = {"Authorization": f"Bearer {API_KEY}"}STYLE_CONST = "Cool neutral white balance, low saturation, clean frame with generous negative space."def draw(prompt: str, size: str = "2K", aspect: str = "1:1") -> bytes: """Generate one image (Nano Banana Pro, native Gemini endpoint).""" url = f"{BASE}/v1beta/models/gemini-3-pro-image:generateContent" body = { "contents": [{"parts": [{"text": prompt}]}], "generationConfig": { "responseModalities": ["IMAGE"], "imageConfig": {"aspectRatio": aspect, "imageSize": size}, }, } r = requests.post(url, headers=HEAD, json=body, timeout=600) # headroom for 4K r.raise_for_status() parts = r.json()["candidates"][0]["content"]["parts"] part = next((p for p in parts if p.get("inlineData")), None) if part is None: # HTTP 200 with no image usually means moderation raise RuntimeError("no image returned: " + json.dumps(parts)[:300]) return base64.b64decode(part["inlineData"]["data"])def score(image: bytes, prompt: str) -> dict: """Score a candidate with a vision model; returns per-dimension scores and one issue line.""" data_url = "data:image/png;base64," + base64.b64encode(image).decode() rubric = ( "Score this image and return strict JSON: " '{"instruction":0-10,"anatomy":0-10,"text":0-10,"texture":0-10,' '"composition":0-10,"total":0-50,"issue":"one sentence"}. ' "instruction = does it satisfy the brief below; anatomy = errors in hands, limbs, object structure; " "text = is any text in the image correct (score 10 if there is none); " "texture = does it read as a real photograph rather than a render; " "composition = is the framing usable. The brief:\n" + prompt ) r = requests.post( f"{BASE}/v1/chat/completions", headers=HEAD, json={ "model": "gemini-3.5-flash", "messages": [{"role": "user", "content": [ {"type": "text", "text": rubric}, {"type": "image_url", "image_url": {"url": data_url}}, ]}], "response_format": {"type": "json_object"}, }, timeout=120, ) r.raise_for_status() return json.loads(r.json()["choices"][0]["message"]["content"])def best_of(user_input: str, n: int = 4) -> bytes: prompt = rewrite(user_input) + "\n" + STYLE_CONST # steps 1 and 2 with ThreadPoolExecutor(max_workers=n) as pool: # step 3: client-side fan-out results = list(pool.map(lambda _: _safe(draw, prompt), range(n))) cands = [img for ok, img in results if ok] if not cands: raise RuntimeError("all candidates failed; check moderation or fall back to another model") with ThreadPoolExecutor(max_workers=len(cands)) as pool: # step 4: score in parallel scores = list(pool.map(lambda im: score(im, prompt), cands)) ranked = sorted(zip(cands, scores), key=lambda x: x[1]["total"], reverse=True) return ranked[0][0] # step 5 retouch/rehost hooks in heredef _safe(fn, *args): try: return True, fn(*args) except Exception as e: # one failure must not sink the batch return False, str(e)
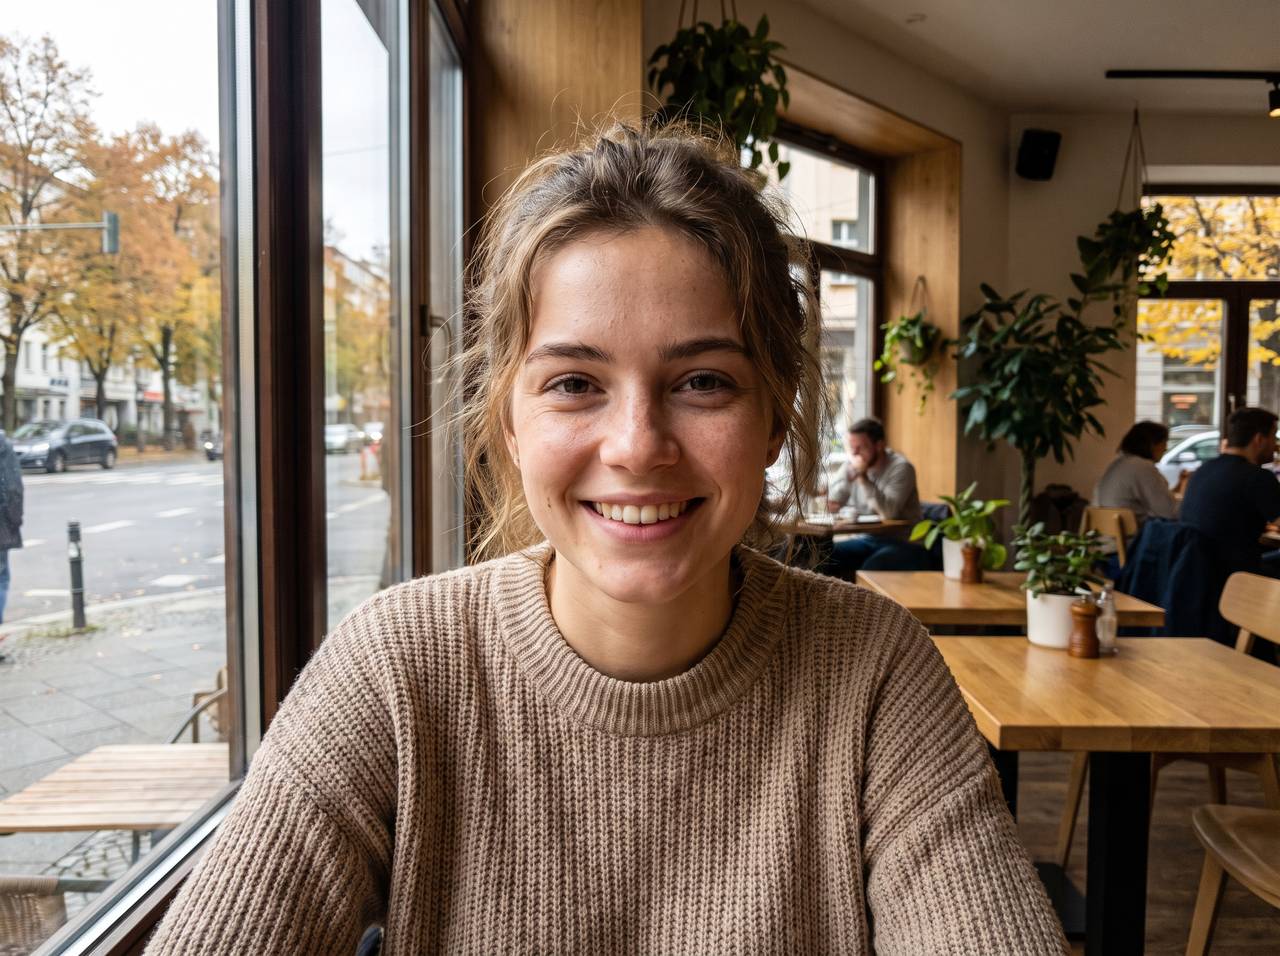
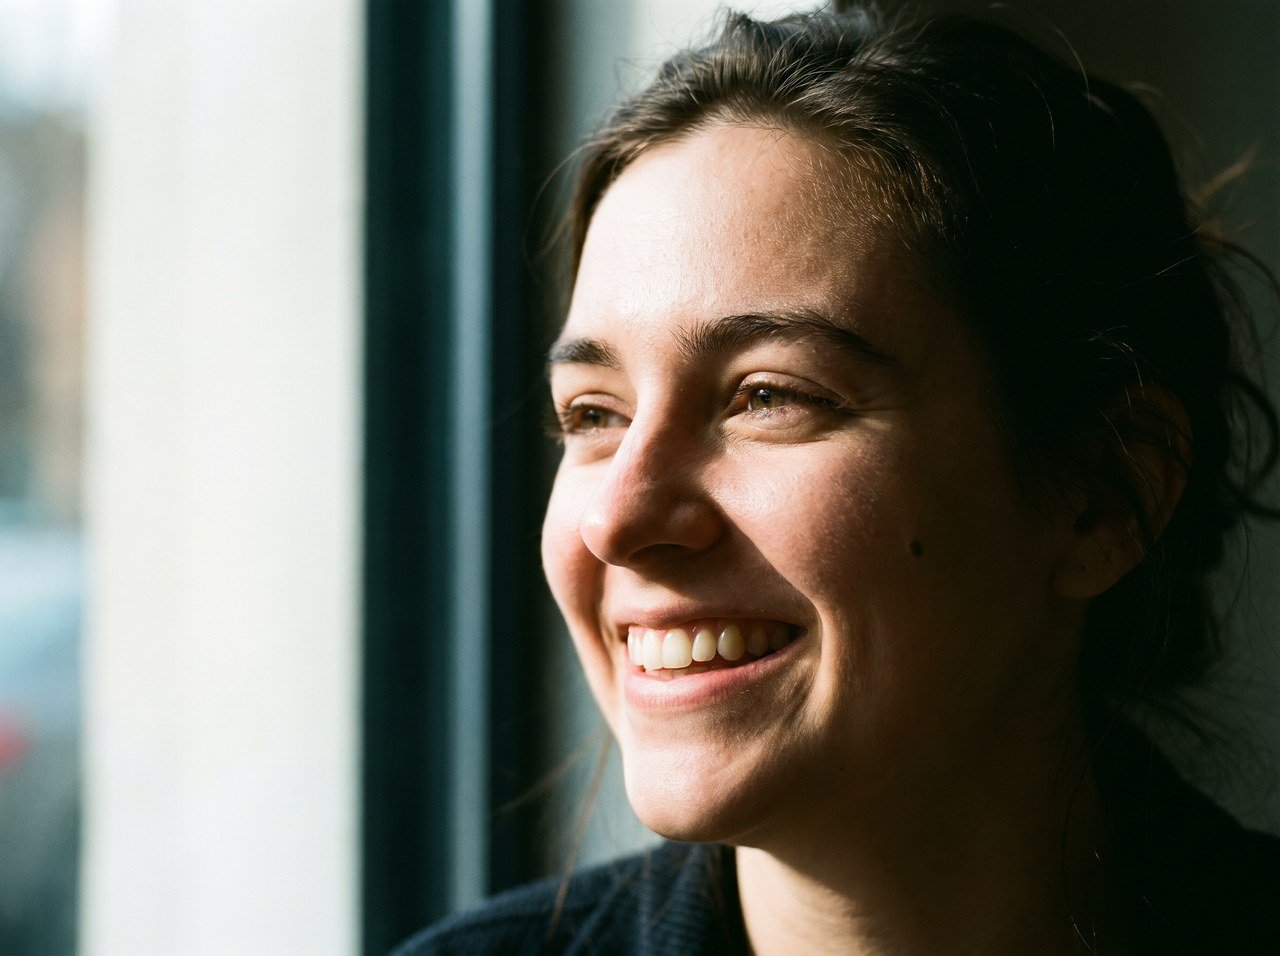
Одна и та же модель (gemini-3-pro-image), один и тот же объект, два стиля промптов, по два изображения каждого варианта; показано первое изображение из каждой серии:
Bare prompt: 'A photorealistic half-body portrait of a young woman by a cafe window, smiling at the camera, 8K, ultra HD, ultra detailed, flawless skin, beautiful, perfect lighting, masterpiece'
The same subject after adding four blocks of control language: light position, lens, medium, imperfections
Левое изображение неплохое — базовая модель достаточно сильна, поэтому даже минимальный промпт даёт привлекательную картинку. Но в нём проявляется полный набор характеристик: объект жёстко расположен точно по центру, свет настолько равномерный, что невозможно сказать, откуда он исходит, и каждый элемент выглядит безупречно. И это не случайность: оба изображения из этой серии имели практически одинаковые композицию и схему освещения.В правом изображении использован другой подход: у света есть направление, половине лица позволено оказаться в тени, на коже видны жирный блеск и поры, на щеке есть родинка, выбившиеся волосы не приглажены, а объект расположен правее центра. Оно воспринимается как снимок конкретного человека в конкретный момент, а не как «стоковое изображение улыбающейся женщины в кафе».
Именно здесь также проявляется реальная ценность конвейера. Он не превращает некрасивый результат в красивый — он превращает «удачный случай» в хороший результат, который вы задали, можете описать и воспроизвести. Заказчику правое изображение может понравиться меньше, но по левому невозможно сказать, почему оно выглядит именно так, и нельзя попросить получить следующее изображение в том же стиле.
Укажите расположение: «объект справа от центра, свободное пространство слева»
«идеальная композиция», «золотое сечение»
Пластиковая кожа без пор
«естественная текстура кожи, видимые поры и пушковые волосы на лице, лёгкий блеск на носу, без ретуши»
«безупречная кожа», «изысканный», «красивый»
Ровный свет без различимого источника
Назовите один ключевой источник света и его жёсткость: «свет из окна слева — единственный источник, правая половина лица в тени»
«идеальное освещение», «мягкое освещение»
Ненастоящая глубина резкости, фон выглядит наклеенным
Укажите фокусное расстояние и диафрагму: «85mm, f/2.8, фокус на ближайшем глазе»
«размытый фон», «кинематографичный»
Перенасыщенный, светящийся цвет
Укажите тип плёнки и баланс белого: «характер Kodak Portra 400, тёплые света и холодные тени, низкая насыщенность»
«яркие цвета», «HDR»
Всё выглядит новым и неношеным
Намеренно добавьте следы использования: «свитер в катышках, следы от стаканов и крошки на столе»
«чисто и аккуратно», «премиальная текстура»
Выглядит как постер или рендер
Укажите ситуацию съёмки: «непостановочный снимок», «на уровне глаз, вид с соседнего столика»
«8K», «ультра-HD», «шедевр»
Расплывчатые слова о качестве, такие как 8K, ultra HD, ultra detailed, masterpiece и perfect, в итоге вредят. Они не добавляют детализации (это делают только параметры) и подталкивают модель к чрезмерно резкому, перенасыщенному рендеру — именно это и составляет основу характерного вида AI. Приведённый выше промпт слева был перегружен такими словами, и результат это показывает. Если вам нужно качество, вместо этого указывайте конкретные параметры света, объектива и типа плёнки.
Четыре блока управляющих формулировок для копирования и вставки
При необходимости добавляйте их в промпт; обычно достаточно одной-двух строк из каждого блока:
Свет
свет из окна слева — единственный источник в кадре / жёсткий контровой свет сзади в три часа дня / контровой свет с бликом по контуру волос / настольная лампа в кадре в качестве практического источника света / рассеянный свет пасмурного дня без выраженных теней
Объектив
35 мм, f/2.0, спонтанный снимок, на уровне глаз / 85 мм, f/2.8, фокус на ближнем глазе / 24 мм с низкой точки съёмки, лёгкое искажение по краям / длиннофокусный объектив сжимающий пространство, уплощённые слои фона / лёгкое виньетирование в углах
Среда
характер Kodak Portra 400, мелкое зерно / тёплые светлые участки, холодные тени / мгновенная плёнка Polaroid, низкий контраст, мягкие края / шум и цветовой оттенок ранней цифровой камеры на CCD / в целом низкая насыщенность, без повышения резкости
Несовершенства
естественная текстура кожи, видимые поры и пушковые волосы на лице / несколько выбившихся, непричёсанных прядей волос / свалявшийся свитер, потёртые манжеты / следы от стаканов, отпечатки пальцев и крошки на столе / нецентрированная композиция, часть объекта обрезана краем кадра
Естественный поясной портрет: женщина чуть старше двадцати пяти лет у окна кафе, повернувшись в сторону и глядя наружу; на её лице улыбка, которую она едва сдерживает. Свет из окна слева — единственный источник в кадре; правая половина лица погружена в тень, под переносицей видна небольшая тень с чёткими краями. Объектив 85 мм, f/2.8, уровень глаз, фокус на ближнем глазе. Характер Kodak Portra 400 с мелким заметным зерном, тёплыми светами и холодными тенями, общая низкая насыщенность. Естественная кожа: видимые поры и пушковые волосы, лёгкий блеск сбоку носа, небольшая родинка на левой щеке, несколько выбившихся волосков бровей, свободные пряди волос, не приглаженные у лба. Без сглаживания кожи, косметической ретуши и повышения резкости. Объект справа от центра, слева — свободное пространство.
Предметная съёмка: готово для страницы товара
Главный кадр для интернет-магазина: матовая чёрная керамическая чашка для пуровера, заполненная на 80 % чёрным кофе; на поверхности — тонкое кольцо крема. Она стоит на светло-серой поверхности из микроцемента, а на заднем плане размыта стена того же оттенка. Ключевой свет от софтбокса слева сверху, под углом 45 градусов; белый отражатель справа оставляет узкий блик вдоль правого края чашки; мягкая падающая тень направлена назад и вправо. Макрообъектив 85 мм, f/5.6, фронтальный вид с наклоном вниз на 15 градусов, вся чашка в резкости. Холодный нейтральный баланс белого, общая низкая насыщенность. Глазурь слегка неровная, с характером ручной работы, и имеет одну крошечную отметину от обжига; на краю чашки виден едва заметный след использования. Много свободного пространства, чашка расположена в левой трети кадра. На изображении нигде нет названий брендов или текста.
Окружение: укажите конкретное время и погоду
Узкая улица старого города в шесть часов вечера, сразу после дождя; лужи отражают световые короба магазинов по обеим сторонам. Единственный ключевой свет — тёплый уличный фонарь в конце улицы; окна магазинов служат заполняющим светом, а в небе ещё сохраняется холодный сумеречный свет, создавая контраст тёплых и холодных оттенков. Объектив 28 мм, f/4, камера на уровне глаз, слегка наклонена вверх. Общая низкая насыщенность, шум сохранён в тенях, без осветления теней. На стенах видны потёки воды, оборванные старые плакаты и блоки кондиционеров; в верхней части кадра проходят линии электропередачи. Никто не смотрит в камеру; прохожие видны со спины и слегка размыты в движении.
5. Факты, которые изменят проектирование вашего пайплайна
Знание этих фактов заранее поможет избежать повторной работы:
Факт
Последствие для пайплайна
Seed фактически недоступен во всей этой линейке продуктов: ни одна модель Nano Banana или GPT-Image не предоставляет Seed, эффективность Seed в Seedream 4.x / 5.x была признана недостаточной, а Grok Imagine его не поддерживает
Не стройте воспроизводимость на Seed. Единственный надёжный способ воспроизведения — архивировать полный успешный запрос — промпт, референсные изображения и каждый параметр — и повторно отправлять его без изменений
Параметр сервера n не влияет на большинство моделей изображений
Несколько вариантов необходимо получать за счёт параллельных запросов на стороне клиента; протестируйте нагрузкой количество параллельных запросов для каждого канала и добавьте экспоненциальную задержку перед повторными попытками
Все API изображений работают синхронно, не имеют идентификатора задачи и продолжают тарифицировать запрос даже после разрыва соединения
Нет эндпоинта для увеличения разрешения, удаления фона или восстановления лиц
Задавайте размер результата во время генерации; для прозрачного фона передавайте background: "transparent" в gpt-image-2.5-flare / gpt-image-2.5-sunburst (это не эндпоинт для вырезания объекта — он напрямую генерирует изображение на прозрачном фоне)
HTTP 200 без изображения обычно означает блокировку модерацией
Логика выбора должна различать случаи «изображение не вернулось» и «изображение вернулось, но оказалось плохим»; в первом случае см. Обработка ошибок Gemini Image
Каждый URL возвращённого изображения является временной ссылкой
Размещайте изображение на собственном хостинге сразу после получения; никогда не сохраняйте исходный URL в базе данных
Длина промптов GPT-Image ограничена 8 192 token (подтверждено измерениями; при превышении ошибки нет, весь промпт молча игнорируется; это около 11 000 китайских символов)
Не вставляйте брендбуки или спецификации упаковки напрямую в модель изображений; сначала с помощью текстовой модели преобразуйте их в структурированный промпт объёмом от 1 000 до 3 000 символов, см. Длинные промпты
Pipeline обменивает деньги на вероятность успеха. На стоимость генерации изображений в основном влияет вывод (gpt-image-2 тарифицирует вывод по $30 за миллион токенов), тогда как текстовые и vision-модели, используемые для переписывания и оценки, дают почти незаметные затраты. Поэтому стоимость фактически определяется тем, «сколько кандидатов вы сгенерировали».Используйте три уровня вместо одной настройки для всех случаев:
Уровень
Состав
Относительная стоимость
Использование
Черновик
Одиночная генерация с помощью модели Lite
1×
Внутренние предварительные просмотры, массовые заполнители, неформальные эксперименты пользователей
Стандартный
Переписывание + 2 кандидата + выбор по результатам оценки
около 2×
Путь по умолчанию в потребительском продукте
Премиум
Переписывание + 4 кандидата + оценка + одна локальная ретушь
около 5×
Главные изображения продукта, рекламные материалы, всё, что передаётся внешним пользователям
Проверка проста: увидит ли это изображение кто-либо за пределами вашей команды? Если да, стандартный или более высокий уровень окупается; если это внутренний просмотр, достаточно чернового уровня. Между ними также можно добавить промежуточное условие — генерировать больше кандидатов только тогда, когда наивысшая оценка ниже заданного порога. Это позволяет большинству запросов останавливаться на двух кандидатах.
Разрыв обусловлен не весами модели, а восемью слоями вокруг модели: переформулированием, пресетами, фиксацией композиции, сэмплированием, отбором, поэтапным редактированием, постобработкой и повторным размещением.
Слой переформулирования даёт наибольшую отдачу: добавьте сведения о субъекте, окружении, освещении, объективе, цветокоррекции и композиции — и «выглядит неплохо» превратится в «пригодно для использования».
Несколько вариантов в сочетании с оценкой vision-моделью — именно здесь на самом деле формируется высокий воспринимаемый процент успешных результатов потребительских продуктов. n не работает, поэтому распределяйте запросы на стороне клиента; /v1/rerank не может оценивать изображения.
Чтобы устранить ощущение, что изображение создано ИИ, добавляйте конкретику, а не прилагательные: укажите один источник света, фокусное расстояние и диафрагму, задайте тип носителя и зернистость, намеренно добавьте несовершенства и сместите субъект от центра.
8K / masterpiece / perfect lighting дают отрицательный чистый эффект — дополнительного разрешения они не добавляют и придают кадру вид рендера.
Не рассчитывайте на seed для воспроизведения результата; вместо этого архивируйте полный запрос. API изображений работают синхронно и тарифицируются при разрыве соединения, поэтому для конвейера нужна очередь.
У APIYI нет эндпоинтов для апскейлинга, удаления фона или обучения идентичности; с самого начала проектируйте решение с учётом этих слоёв.
Локальное редактирование на уровне пикселей, доступно только для gpt-image-2 через официальный релей
Тестирование слияния нескольких изображений
Как измерялись ограничения на количество референсов, а также результат слияния 14 изображений
Распознавание изображений
Модели распознавания изображений, которые можно использовать для оценки изображений-кандидатов, и способы их вызова
Создание собственной асинхронной очереди
Обёртывание синхронной генерации в очередь задач для поддержки конвейера с несколькими кандидатами
Была ли эта страница полезной?
{"docsConfig":{"theme":"mint","$schema":"https://mintlify.com/docs.json","name":"API易文档中心","description":"企业级专业稳定的AI大模型API中转站,一个令牌、无限模型。支持OpenAI、Claude、Gemini、DeepSeek、Qwen等 200+ 精选 AI 模型。","colors":{"primary":"#2563eb","light":"#3b82f6","dark":"#1d4ed8"},"logo":{"light":"https://mintcdn.com/apiyillc/LjCT1O0GrSur6F2v/logo/light.svg?fit=max\u0026auto=format\u0026n=LjCT1O0GrSur6F2v\u0026q=85\u0026s=4119ef17a74cc54be127f34578d8b5fa","dark":"https://mintcdn.com/apiyillc/LjCT1O0GrSur6F2v/logo/dark.svg?fit=max\u0026auto=format\u0026n=LjCT1O0GrSur6F2v\u0026q=85\u0026s=1f046ae9580247d96549ade642b5ecc4"},"favicon":"https://mintcdn.com/apiyillc/OMY6ItCc2mC1yzgA/logo/logo.webp?fit=max\u0026auto=format\u0026n=OMY6ItCc2mC1yzgA\u0026q=85\u0026s=62a7977ef801070e689df2d0291b9d13","api":{"openapi":["api-reference/nano-banana-2-generate-openapi.yaml","api-reference/nano-banana-2-edit-openapi.yaml","api-reference/nano-banana-2-generate-openapi-en.yaml","api-reference/nano-banana-2-edit-openapi-en.yaml","api-reference/nano-banana-pro-generate-openapi.yaml","api-reference/nano-banana-pro-edit-openapi.yaml","api-reference/nano-banana-pro-generate-openapi-en.yaml","api-reference/nano-banana-pro-edit-openapi-en.yaml","api-reference/gpt-image-2-all-generate-openapi.yaml","api-reference/gpt-image-2-all-edit-openapi.yaml","api-reference/gpt-image-2-all-generate-openapi-en.yaml","api-reference/gpt-image-2-all-edit-openapi-en.yaml","api-reference/gpt-image-2-all-chat-openapi.yaml","api-reference/gpt-image-2-all-chat-openapi-en.yaml","api-reference/gpt-image-2-vip-generate-openapi.yaml","api-reference/gpt-image-2-vip-edit-openapi.yaml","api-reference/gpt-image-2-vip-chat-openapi.yaml","api-reference/gpt-image-2-vip-generate-openapi-en.yaml","api-reference/gpt-image-2-vip-edit-openapi-en.yaml","api-reference/gpt-image-2-vip-chat-openapi-en.yaml"],"playground":{"display":"interactive","proxy":true},"examples":{"defaults":"required"}},"navbar":{"links":[{"href":"https://api.apiyi.com","label":"首页"},{"href":"https://imagen.apiyi.com","label":"AI出图"},{"href":"https://icover.ai","label":"AI视频"}],"primary":{"type":"button","label":"控制台","href":"https://api.apiyi.com/account/profile"}},"footer":{"socials":{"website":"https://api.apiyi.com"},"links":[{"header":"AI 集成","items":[{"label":"skill.md","href":"https://docs.apiyi.com/skill.md"},{"label":"llms.txt","href":"https://docs.apiyi.com/llms.txt"},{"label":"llms-full.txt","href":"https://docs.apiyi.com/llms-full.txt"},{"label":"model-registry.json","href":"https://docs.apiyi.com/model-registry.json"},{"label":"AI 开发者套件(中文)","href":"/developer-kit"},{"label":"AI Developer Kit (EN)","href":"/en/developer-kit"}]},{"header":"用户口碑 / Wall of Love","items":[{"label":"用户口碑(中文)","href":"/wall-of-love"},{"label":"Wall of Love (EN)","href":"/en/wall-of-love"}]}]},"seo":{"indexing":"all"},"icons":{"library":"lucide"},"banner":{"content":"🚀 **GPT Image 2.6 Sunburst 和 Flare 均已上线,支持 GIF 输出,低至 83 折(17% off) | Now Live**:[详情 Details](https://docs.apiyi.com/api-capabilities/gpt-image-2/gpt-image-2-6)","dismissible":true},"contextual":{"options":["copy","view","chatgpt","claude","perplexity","aistudio"],"display":"header"},"metadata":{"timestamp":false},"styling":{"latex":true},"navigation":{"global":{"anchors":[]},"languages":[{"language":"zh","href":""},{"language":"en","navbar":{"links":[{"href":"https://api.apiyi.com","label":"Home"},{"href":"https://imagen.apiyi.com","label":"AI Image"},{"href":"https://icover.ai","label":"AI Video"}],"primary":{"type":"button","label":"Console","href":"https://api.apiyi.com/account/profile"}},"href":"en"},{"language":"zh-Hant","banner":{"content":"本頁由程式自動轉換為繁體中文,用詞以台灣正體為準;如有歧義請以[簡體中文版](/)為準。","dismissible":true},"footer":{"socials":{"website":"https://api.apiyi.com"},"links":[{"header":"AI 整合","items":[{"label":"skill.md","href":"https://docs.apiyi.com/skill.md"},{"label":"llms.txt","href":"https://docs.apiyi.com/llms.txt"},{"label":"llms-full.txt","href":"https://docs.apiyi.com/llms-full.txt"},{"label":"model-registry.json","href":"https://docs.apiyi.com/model-registry.json"},{"label":"AI 開發者套件(中文)","href":"/developer-kit"},{"label":"AI Developer Kit (EN)","href":"/en/developer-kit"}]},{"header":"使用者口碑 / Wall of Love","items":[{"label":"使用者口碑(中文)","href":"/wall-of-love"},{"label":"Wall of Love (EN)","href":"/en/wall-of-love"}]}]},"navbar":{"links":[{"href":"https://api.apiyi.com","label":"首頁"},{"href":"https://imagen.apiyi.com","label":"AI出圖"},{"href":"https://icover.ai","label":"AI影片"}],"primary":{"type":"button","label":"控制台","href":"https://api.apiyi.com/account/profile"}},"href":"zh-Hant"},{"language":"ja","banner":{"content":"このページは AI により翻訳されています。内容に相違がある場合は[English 版](/en)を正としてください。","dismissible":true},"footer":{"socials":{"website":"https://api.apiyi.com"},"links":[{"header":"AI統合","items":[{"label":"skill.md","href":"https://docs.apiyi.com/skill.md"},{"label":"llms.txt","href":"https://docs.apiyi.com/llms.txt"},{"label":"llms-full.txt","href":"https://docs.apiyi.com/llms-full.txt"},{"label":"model-registry.json","href":"https://docs.apiyi.com/model-registry.json"},{"label":"AI開発者キット(中国語)","href":"/developer-kit"},{"label":"AI Developer Kit (EN)","href":"/en/developer-kit"}]},{"header":"ユーザーの声 / Wall of Love","items":[{"label":"ユーザーの声(中国語)","href":"/wall-of-love"},{"label":"Wall of Love(英語)","href":"/en/wall-of-love"}]}]},"navbar":{"links":[{"href":"https://api.apiyi.com","label":"ホーム"},{"href":"https://imagen.apiyi.com","label":"AI画像生成"},{"href":"https://icover.ai","label":"AI動画生成"}],"primary":{"type":"button","label":"コンソール","href":"https://api.apiyi.com/account/profile"}},"href":"ja"},{"language":"ko","banner":{"content":"이 페이지는 AI로 번역되었습니다. 내용이 다를 경우 [English 버전](/en)을 기준으로 하십시오.","dismissible":true},"footer":{"socials":{"website":"https://api.apiyi.com"},"links":[{"header":"AI 통합","items":[{"label":"skill.md","href":"https://docs.apiyi.com/skill.md"},{"label":"llms.txt","href":"https://docs.apiyi.com/llms.txt"},{"label":"llms-full.txt","href":"https://docs.apiyi.com/llms-full.txt"},{"label":"model-registry.json","href":"https://docs.apiyi.com/model-registry.json"},{"label":"AI 개발자 키트(중국어)","href":"/developer-kit"},{"label":"AI Developer Kit (EN)","href":"/en/developer-kit"}]},{"header":"사용자 후기 / Wall of Love","items":[{"label":"사용자 후기(중국어)","href":"/wall-of-love"},{"label":"Wall of Love (영문)","href":"/en/wall-of-love"}]}]},"navbar":{"links":[{"href":"https://api.apiyi.com","label":"홈"},{"href":"https://imagen.apiyi.com","label":"AI 이미지 생성"},{"href":"https://icover.ai","label":"AI 동영상 생성"}],"primary":{"type":"button","label":"콘솔","href":"https://api.apiyi.com/account/profile"}},"href":"ko"},{"language":"ru","banner":{"content":"Эта страница переведена с помощью ИИ. При расхождениях ориентируйтесь на [английскую версию](/en).","dismissible":true},"footer":{"socials":{"website":"https://api.apiyi.com"},"links":[{"header":"AI-интеграция","items":[{"label":"skill.md","href":"https://docs.apiyi.com/skill.md"},{"label":"llms.txt","href":"https://docs.apiyi.com/llms.txt"},{"label":"llms-full.txt","href":"https://docs.apiyi.com/llms-full.txt"},{"label":"model-registry.json","href":"https://docs.apiyi.com/model-registry.json"},{"label":"Набор AI-разработчика (кит.)","href":"/developer-kit"},{"label":"AI Developer Kit (EN)","href":"/en/developer-kit"}]},{"header":"Отзывы пользователей / Wall of Love","items":[{"label":"Отзывы пользователей (на китайском)","href":"/wall-of-love"},{"label":"Wall of Love (EN)","href":"/en/wall-of-love"}]}]},"navbar":{"links":[{"href":"https://api.apiyi.com","label":"Главная"},{"href":"https://imagen.apiyi.com","label":"Генерация изображений"},{"href":"https://icover.ai","label":"Генерация видео"}],"primary":{"type":"button","label":"Консоль","href":"https://api.apiyi.com/account/profile"}},"href":"ru"}]}},"deployment":{"deploymentMetadataValue":{"subdomain":"apiyillc","hasAudioNarration":false,"actualSubdomain":"apiyillc","customDomains":["docs.apiyi.com"],"gitSource":{"type":"github","owner":"pdmaker","repo":"docs","deployBranch":"main","contentDirectory":"","isPrivate":true,"mountPath":"","label":""},"feedback":{"thumbs":true,"agentFeedback":true},"entitlements":{},"buildId":"6af5284af12ba9b78742168f","clientVersion":"0.0.4111","searchFilterCounts":[{"language":"zh","tag":"首页","count":214},{"language":"en","tag":"Home","count":214},{"language":"ja","tag":"ホーム","count":214},{"language":"ko","tag":"홈","count":214},{"language":"ru","tag":"Главная","count":214},{"language":"zh-Hant","tag":"首頁","count":214},{"language":"zh","tag":"图片 API(官转)","count":84},{"language":"en","tag":"Image API (Official)","count":84},{"language":"ja","tag":"画像API(公式)","count":84},{"language":"ko","tag":"이미지 API (공식)","count":84},{"language":"ru","tag":"Image API (официальный)","count":84},{"language":"zh-Hant","tag":"圖片 API(官轉)","count":84},{"language":"zh","tag":"公告","count":81},{"language":"en","tag":"Announcements","count":81},{"language":"zh","tag":"AI风向标","count":78},{"language":"en","tag":"AI Radar","count":78},{"language":"zh","tag":"常见问题","count":63},{"language":"en","tag":"FAQ","count":63},{"language":"ja","tag":"FAQ","count":63},{"language":"ko","tag":"FAQ","count":63},{"language":"ru","tag":"FAQ","count":63},{"language":"zh-Hant","tag":"常見問題","count":63},{"language":"zh","tag":"使用场景","count":50},{"language":"en","tag":"Use Cases","count":50},{"language":"ja","tag":"活用例","count":50},{"language":"ko","tag":"활용 사례","count":50},{"language":"ru","tag":"Сценарии использования","count":50},{"language":"zh-Hant","tag":"使用場景","count":50},{"language":"zh","tag":"基础 API","count":47},{"language":"en","tag":"Basic API","count":47},{"language":"ja","tag":"基本API","count":47},{"language":"ko","tag":"기본 API","count":47},{"language":"ru","tag":"Базовый API","count":47},{"language":"zh-Hant","tag":"基礎 API","count":47},{"language":"zh","tag":"模型价格","count":36},{"language":"en","tag":"Model Pricing","count":36},{"language":"ja","tag":"モデル料金","count":36},{"language":"ko","tag":"모델 요금","count":36},{"language":"ru","tag":"Цены на модели","count":36},{"language":"zh-Hant","tag":"模型價格","count":36},{"language":"zh","tag":"视频 API(官转)","count":35},{"language":"en","tag":"Video API (Official)","count":35},{"language":"ja","tag":"動画API(公式)","count":35},{"language":"ko","tag":"동영상 API (공식)","count":35},{"language":"ru","tag":"Video API (официальный)","count":35},{"language":"zh-Hant","tag":"影片 API(官轉)","count":35},{"language":"zh","tag":"文本生成","count":28},{"language":"en","tag":"Text Generation","count":28},{"language":"ja","tag":"テキスト生成","count":28},{"language":"ko","tag":"텍스트 생성","count":28},{"language":"ru","tag":"Генерация текста","count":28},{"language":"zh-Hant","tag":"文本生成","count":28},{"language":"ja","tag":"課金とセキュリティ","count":17},{"language":"ko","tag":"결제 및 보안","count":17},{"language":"ru","tag":"Оплата и безопасность","count":17},{"language":"zh-Hant","tag":"充值與安全","count":17},{"language":"ja","tag":"NanoBananaベストプラクティス","count":15},{"language":"ko","tag":"NanoBanana 모범 사례","count":15},{"language":"ru","tag":"Лучшие практики NanoBanana","count":15},{"language":"zh-Hant","tag":"NanoBanana最佳實踐","count":15}]},"assistantConfig":{},"basePath":"","hasChatPermissions":false,"hasWebMcpPermissions":false,"toggles":[{"name":"kill-isr","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"custom-rbac-roles","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"agent-mintlify-slack","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"agent-integrations-settings","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"rbac-expansion","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"automations-pr-grouping","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"custom-prefix","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"analytics-v7","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"user-flows-analytics","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"no-publish-flow","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"workos-onboarding","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"llms-txt-v2","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"snapshot-serving-live","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"stripTemperatureMiddleware","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"support-platform-pylon-zendesk","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"snapshot-serving","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"instant-rollback","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"granular-notifications-server","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"granular-notifications","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"automations-fable","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"fixed-ai-action-pricing","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"automation-resolve-merge-conflict","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"scoped-publishing","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"mintql","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"page-level-analytics","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"editor-version-history-v2","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"billing-page-v2","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"full-page-search","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"workspace-projects","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"assistant-v5","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"fork-pr-previews","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"revalidation-jwt","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"workos-sso-scim","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"hobby-abuse-scan","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"dashboard-inbox","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"workos-signup","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"turbopuffer-dual-write","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"workos-enabled","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"approve-review-flow","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"editor-metadata","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"sso-setup-deadline-banner","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"turbopuffer-serve","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false},{"name":"live-agents","enabled":true,"variant":{"name":"disabled","enabled":false,"feature_enabled":true},"impressionData":false}],"googleFontsInlined":false},"customCss":[{"filePath":"models/models.css","content":".mp-layout{display:flex;gap:2.5rem;max-width:1400px;margin:0 auto;padding:2.5rem 1.5rem 4rem;font-size:15px;line-height:1.7;color:rgb(var(--gray-500, 113 115 119))}html.dark .mp-layout{color:rgb(var(--gray-400, 159 161 165))}.mp-rail{display:none}@media (min-width: 1024px){.mp-rail{display:block;width:13rem;flex-shrink:0}}.mp-rail-nav{position:sticky;top:9.25rem;font-size:0.875rem}.mp-rail-head{font-weight:600;margin:0 0 0.375rem;color:rgb(var(--gray-900, 23 25 29))}html.dark .mp-rail-head{color:rgb(var(--gray-200, 223 225 229))}.mp-rail-link{display:block;padding:0.22rem 0;color:rgb(var(--gray-500, 113 115 119));text-decoration:none;overflow:hidden;text-overflow:ellipsis;white-space:nowrap}.mp-rail-link:hover{color:rgb(var(--primary, 37 99 235))}html.dark .mp-rail-link{color:rgb(var(--gray-400, 159 161 165))}html.dark .mp-rail-link:hover{color:rgb(var(--primary-light, 59 130 246))}.mp-rail-vendors{max-height:45vh;overflow-y:auto}.mp-mt{margin-top:1rem}.mp-content{min-width:0;flex:1}.mp-title{font-size:2rem;font-weight:700;letter-spacing:-0.02em;margin:0 0 0.5rem;color:rgb(var(--gray-900, 23 25 29))}html.dark .mp-title{color:#fff}.mp-desc{color:rgb(var(--gray-500, 113 115 119));margin:0 0 1.5rem}html.dark .mp-desc{color:rgb(var(--gray-400, 159 161 165))}.mp-content h2{font-size:1.375rem;font-weight:600;margin:2.75rem 0 1rem;padding-bottom:0.45rem;border-bottom:1px solid rgb(var(--gray-200, 223 225 229) / 0.7);color:rgb(var(--gray-900, 23 25 29));scroll-margin-top:12rem}@media (min-width: 1024px){.mp-content h2{scroll-margin-top:16.5rem}}html.dark .mp-content h2{border-color:rgb(255 255 255 / 0.1);color:#fff}.mp-content p{margin:0.75rem 0}.mp-content ul{margin:0.75rem 0;padding-left:1.4rem}.mp-content li{margin:0.4rem 0}.mp-content strong{color:rgb(var(--gray-900, 23 25 29))}html.dark .mp-content strong{color:#fff}.mp-content a{color:rgb(var(--primary, 37 99 235));text-decoration:none}.mp-content a:hover{text-decoration:underline}html.dark .mp-content a{color:rgb(var(--primary-light, 59 130 246))}.mp-content code{font-size:0.85em;background:rgb(var(--gray-100, 239 241 245) / 0.8);border:1px solid rgb(var(--gray-200, 223 225 229) / 0.7);padding:0.1em 0.35em;border-radius:0.375rem}html.dark .mp-content code{background:rgb(255 255 255 / 0.06);border-color:rgb(255 255 255 / 0.1)}.mp-content code.mp-ep-rec{color:rgb(var(--primary, 37 99 235));background:rgb(var(--primary, 37 99 235) / 0.08);border-color:rgb(var(--primary, 37 99 235) / 0.45);font-weight:600}html.dark .mp-content code.mp-ep-rec{color:rgb(var(--primary-light, 59 130 246));background:rgb(var(--primary-light, 59 130 246) / 0.14);border-color:rgb(var(--primary-light, 59 130 246) / 0.5)}.mp-content table{display:block;max-width:100%;overflow-x:auto;border-collapse:collapse;font-size:0.875rem;margin:1rem 0 1.5rem}.mp-content th{text-align:left;font-weight:500;color:rgb(var(--gray-500, 113 115 119));padding:0.55rem 1.25rem 0.55rem 0;border-bottom:1px solid rgb(var(--gray-200, 223 225 229) / 0.7);white-space:nowrap}.mp-content td{padding:0.55rem 1.25rem 0.55rem 0;border-bottom:1px solid rgb(var(--gray-200, 223 225 229) / 0.45);white-space:nowrap}html.dark .mp-content th{border-color:rgb(255 255 255 / 0.1);color:rgb(var(--gray-400, 159 161 165))}html.dark .mp-content td{border-color:rgb(255 255 255 / 0.07)}.mp-search{display:contents}.mp-search-bar{position:sticky;top:5rem;z-index:20;margin:0 0 1.75rem;background:rgb(var(--background-light, 255 255 255));padding:0.75rem 0 0.85rem;box-shadow:0 10px 14px -10px rgb(var(--gray-950, 11 13 17) / 0.28)}@media (min-width: 1024px){.mp-search-bar{top:9.25rem}}html.dark .mp-search-bar{background:rgb(var(--background-dark, 10 11 16));box-shadow:0 8px 12px -10px rgb(0 0 0 / 0.7)}.mp-search-label{margin:0 0 0.5rem;padding-left:0.6rem;border-left:3px solid rgb(var(--primary, 37 99 235));font-size:0.9rem;font-weight:600;line-height:1.4;color:rgb(var(--primary, 37 99 235))}html.dark .mp-search-label{border-left-color:rgb(var(--primary-light, 59 130 246));color:rgb(var(--primary-light, 59 130 246))}.mp-search-input{width:100%;box-sizing:border-box;border:1px solid rgb(var(--gray-400, 159 161 165) / 0.3);border-radius:0.75rem;padding:0.7rem 1rem 0.7rem 2.65rem;font-size:0.9rem;background-color:rgb(var(--background-light, 255 255 255));background-image:url(\"data:image/svg+xml,%3Csvg xmlns='http://www.w3.org/2000/svg' width='18' height='18' viewBox='0 0 24 24' fill='none' stroke='%23717377' stroke-width='2' stroke-linecap='round' stroke-linejoin='round'%3E%3Ccircle cx='11' cy='11' r='8'/%3E%3Cpath d='m21 21-4.3-4.3'/%3E%3C/svg%3E\");background-repeat:no-repeat;background-position:0.9rem center;color:rgb(var(--gray-900, 23 25 29));outline:none;transition:border-color 0.15s ease, background-color 0.15s ease, box-shadow 0.15s ease}.mp-search-input::placeholder{color:rgb(var(--gray-500, 113 115 119))}.mp-search-input:hover{border-color:rgb(var(--gray-600, 81 83 87) / 0.3)}.mp-search-input:focus{border-color:rgb(var(--primary, 37 99 235));box-shadow:0 0 0 3px rgb(var(--primary, 37 99 235) / 0.16)}html.dark .mp-search-input{background-color:rgb(var(--background-dark, 10 11 16));background-image:url(\"data:image/svg+xml,%3Csvg xmlns='http://www.w3.org/2000/svg' width='18' height='18' viewBox='0 0 24 24' fill='none' stroke='%239fa1a5' stroke-width='2' stroke-linecap='round' stroke-linejoin='round'%3E%3Ccircle cx='11' cy='11' r='8'/%3E%3Cpath d='m21 21-4.3-4.3'/%3E%3C/svg%3E\");border-color:rgb(var(--gray-600, 81 83 87) / 0.3);color:rgb(var(--gray-100, 239 241 245))}html.dark .mp-search-input::placeholder{color:rgb(255 255 255 / 0.5)}html.dark .mp-search-input:hover{border-color:rgb(var(--gray-500, 113 115 119) / 0.35)}html.dark .mp-search-input:focus{border-color:rgb(var(--primary-light, 59 130 246));box-shadow:0 0 0 3px rgb(var(--primary-light, 59 130 246) / 0.22)}.mp-search-meta{font-size:0.75rem;color:rgb(var(--gray-500, 113 115 119));margin:0.75rem 0 0.25rem}.mp-search-empty{font-size:0.875rem;color:rgb(var(--gray-500, 113 115 119));margin-top:0.75rem}html.dark .mp-search-meta,html.dark .mp-search-empty{color:rgb(var(--gray-400, 159 161 165))}.mp-mono{font-family:ui-monospace, SFMono-Regular, Menlo, Consolas, monospace;font-size:0.8125rem}@media (min-width: 1024px){.mp-jump{display:none}}"},{"filePath":"styles/agent-prompt.css","content":"div.prompt{border:1.5px solid rgb(var(--primary, 37 99 235) / 0.35);background:rgb(var(--primary, 37 99 235) / 0.035);padding:1.25rem 1.25rem 1rem;row-gap:0.75rem}html.dark div.prompt{border-color:rgb(var(--primary-light, 59 130 246) / 0.4);background:rgb(var(--primary-light, 59 130 246) / 0.06)}div.prompt [data-component-part=\"prompt-content-wrapper\"]{width:100%}div.prompt [data-component-part=\"prompt-actions-wrapper\"]{width:100%;justify-content:flex-end}div.prompt [data-component-part=\"prompt-description\"]{flex:1;font-size:14px;line-height:1.65}div.prompt [data-component-part=\"prompt-description\"]>div>*{margin:0}div.prompt [data-component-part=\"prompt-description\"]>div>*+*{margin-top:0.6rem}div.prompt [data-component-part=\"prompt-description\"] strong{font-size:15px;font-weight:650;color:rgb(var(--gray-900, 23 25 29))}html.dark div.prompt [data-component-part=\"prompt-description\"] strong{color:#fff}div.prompt [data-component-part=\"prompt-description\"]>div>*+p{color:rgb(var(--gray-600, 80 82 86))}html.dark div.prompt [data-component-part=\"prompt-description\"]>div>*+p{color:rgb(var(--gray-400, 159 161 165))}div.prompt [data-component-part=\"prompt-description\"] code{font-size:0.85em;background:rgb(var(--gray-100, 239 241 245) / 0.9);border:1px solid rgb(var(--gray-200, 223 225 229) / 0.7);padding:0.05em 0.35em;border-radius:0.375rem}html.dark div.prompt [data-component-part=\"prompt-description\"] code{background:rgb(255 255 255 / 0.06);border-color:rgb(255 255 255 / 0.1)}div.prompt [data-component-part=\"prompt-description\"] blockquote{margin:0;padding:0.75rem 0.9rem;font-style:normal;border:1px dashed rgb(var(--gray-300, 191 193 197));border-radius:0.6rem;background:rgb(var(--background-light, 255 255 255));font-family:ui-monospace, SFMono-Regular, Menlo, Consolas, monospace;font-size:12.5px;line-height:1.6;color:rgb(var(--gray-600, 80 82 86));overflow-wrap:anywhere;-webkit-mask-image:linear-gradient(to bottom, #000 70%, transparent 100%);mask-image:linear-gradient(to bottom, #000 70%, transparent 100%)}div.prompt [data-component-part=\"prompt-description\"] blockquote p,div.prompt [data-component-part=\"prompt-description\"] blockquote ol{margin:0}div.prompt [data-component-part=\"prompt-description\"] blockquote li{padding:0}div.prompt [data-component-part=\"prompt-description\"] blockquote>*+*{margin-top:0.5rem}div.prompt [data-component-part=\"prompt-description\"] blockquote code{background:none;border:0;padding:0;font-size:1em}div.prompt [data-component-part=\"prompt-description\"] blockquote a{color:inherit;text-decoration:none;pointer-events:none}html.dark div.prompt [data-component-part=\"prompt-description\"] blockquote{border-color:rgb(255 255 255 / 0.15);background:rgb(var(--background-dark, 13 13 13));color:rgb(var(--gray-400, 159 161 165))}div.prompt [data-component-part=\"prompt-action-copy-button\"]{padding:0.6rem 1.25rem;font-size:14px;line-height:20px;font-weight:600;border-radius:0.65rem;gap:0.45rem;box-shadow:0 1px 2px rgb(0 0 0 / 0.08), 0 4px 12px rgb(var(--primary, 37 99 235) / 0.25)}div.prompt [data-component-part=\"prompt-action-copy-button\"]::before{content:\"\";width:16px;height:16px;flex-shrink:0;background:currentColor;-webkit-mask:url(\"data:image/svg+xml,%3Csvg xmlns='http://www.w3.org/2000/svg' viewBox='0 0 24 24' fill='none' stroke='black' stroke-width='2' stroke-linecap='round' stroke-linejoin='round'%3E%3Crect width='14' height='14' x='8' y='8' rx='2' ry='2'/%3E%3Cpath d='M4 16c-1.1 0-2-.9-2-2V4c0-1.1.9-2 2-2h10c1.1 0 2 .9 2 2'/%3E%3C/svg%3E\") center / contain no-repeat;mask:url(\"data:image/svg+xml,%3Csvg xmlns='http://www.w3.org/2000/svg' viewBox='0 0 24 24' fill='none' stroke='black' stroke-width='2' stroke-linecap='round' stroke-linejoin='round'%3E%3Crect width='14' height='14' x='8' y='8' rx='2' ry='2'/%3E%3Cpath d='M4 16c-1.1 0-2-.9-2-2V4c0-1.1.9-2 2-2h10c1.1 0 2 .9 2 2'/%3E%3C/svg%3E\") center / contain no-repeat}div.prompt [data-component-part=\"prompt-action-copy-button\"] svg{width:12px;height:12px}@media (max-width: 640px){div.prompt [data-component-part=\"prompt-actions-wrapper\"]>*{flex:1}}"}],"page":{"pagePath":"ru/api-capabilities/image-advanced-workflow","slug":"/ru/api-capabilities/image-advanced-workflow","pageMetadata":{"title":"Продвинутая генерация изображений: рабочий процесс и реалистичность","sidebarTitle":"Продвинутый рабочий процесс","description":"Та же модель, но лучший результат: что пользовательские приложения для работы с изображениями добавляют поверх API — слой переформулирования промпта, фиксацию референса, параллельную выборку с выбором vision-модели и пошаговую ретушь. Включает готовую для копирования и вставки лексику для описания реалистичности, сравнительные тесты и расчёт стоимости.","icon":"workflow","href":"/ru/api-capabilities/image-advanced-workflow"},"description":{"compiledSource":"\"use strict\";\nconst {jsx: _jsx} = arguments[0];\nconst {useMDXComponents: _provideComponents} = arguments[0];\nfunction _createMdxContent(props) {\n const _components = {\n p: \"p\",\n ..._provideComponents(),\n ...props.components\n };\n return _jsx(_components.p, {\n children: \"Та же модель, но лучший результат: что пользовательские приложения для работы с изображениями добавляют поверх API — слой переформулирования промпта, фиксацию референса, параллельную выборку с выбором vision-модели и пошаговую ретушь. Включает готовую для копирования и вставки лексику для описания реалистичности, сравнительные тесты и расчёт стоимости.\"\n });\n}\nfunction MDXContent(props = {}) {\n const {wrapper: MDXLayout} = {\n ..._provideComponents(),\n ...props.components\n };\n return MDXLayout ? _jsx(MDXLayout, {\n ...props,\n children: _jsx(_createMdxContent, {\n ...props\n })\n }) : _createMdxContent(props);\n}\nreturn {\n default: MDXContent\n};\n","frontmatter":{},"scope":{}},"pageType":"default","mdx":{"mdxSource":{"compiledSource":"\"use strict\";const{Fragment:_Fragment,jsx:_jsx,jsxs:_jsxs}=arguments[0];const{useMDXComponents:_provideComponents}=arguments[0];function _createMdxContent(props){const _components={a:`a`,code:`code`,li:`li`,ol:`ol`,p:`p`,pre:`pre`,span:`span`,strong:`strong`,tbody:`tbody`,td:`td`,th:`th`,thead:`thead`,tr:`tr`,ul:`ul`,..._provideComponents(),...props.components},{Accordion,AccordionGroup,Card,CardGroup,CodeBlock,Frame,Heading,Info,OptimizedImage,Step,Steps,Table,Tip,Warning}=_components;if(!Accordion)_missingMdxReference(`Accordion`,true);if(!AccordionGroup)_missingMdxReference(`AccordionGroup`,true);if(!Card)_missingMdxReference(`Card`,true);if(!CardGroup)_missingMdxReference(`CardGroup`,true);if(!CodeBlock)_missingMdxReference(`CodeBlock`,true);if(!Frame)_missingMdxReference(`Frame`,true);if(!Heading)_missingMdxReference(`Heading`,true);if(!Info)_missingMdxReference(`Info`,true);if(!OptimizedImage)_missingMdxReference(`OptimizedImage`,true);if(!Step)_missingMdxReference(`Step`,true);if(!Steps)_missingMdxReference(`Steps`,true);if(!Table)_missingMdxReference(`Table`,true);if(!Tip)_missingMdxReference(`Tip`,true);if(!Warning)_missingMdxReference(`Warning`,true);return _jsxs(_Fragment,{children:[_jsxs(_components.p,{children:[_jsx(_components.a,{href:`/ru/api-capabilities/image-generation-success-tips`,children:`Как получить нужное изображение`}),` отвечает на вопрос: «эта попытка не удалась — как её спасти». Эта страница отвечает на следующий вопрос: `,_jsx(_components.strong,{children:`как сделать так, чтобы каждая попытка приводила к нужному результату`}),`.`]}),`\n`,_jsxs(_components.p,{children:[`Постоянно возникает следующий вопрос: потребительские продукты для работы с изображениями, такие как `,_jsx(_components.code,{children:`freepik.com`}),` и `,_jsx(_components.code,{children:`higgsfield.ai`}),`, работают на тех же базовых моделях, что и вы, — на тех же семействах Nano Banana, GPT-Image и FLUX, — и всё же их результаты выглядят более завершёнными. Разрыв связан не с весами модели. `,_jsx(_components.strong,{children:`Он обусловлен слоем, обёрнутым вокруг модели`}),`, и этот слой можно создать самостоятельно. На этой странице показано, как это сделать.`]}),`\n`,_jsx(Heading,{level:`2`,id:`1-что-представляют-собой-потребительские-продукты-для-работы-с-изображениями-поверх-модели`,children:`1. Что представляют собой потребительские продукты для работы с изображениями поверх модели`}),`\n`,_jsx(_components.p,{children:`Если разобрать один из таких продуктов, за пределами модели обнаружится примерно восемь слоёв. Каждый из них можно воспроизвести через API:`}),`\n`,_jsxs(Table,{children:[_jsx(_components.thead,{children:_jsxs(_components.tr,{children:[_jsx(_components.th,{children:`Что делает продукт`}),_jsx(_components.th,{children:`Какую проблему решает`}),_jsx(_components.th,{children:`Как воспроизвести это через API`})]})}),_jsxs(_components.tbody,{children:[_jsxs(_components.tr,{children:[_jsxs(_components.td,{children:[_jsx(_components.strong,{children:`Слой перезаписи промпта`}),` (улучшатель промптов)`]}),_jsx(_components.td,{children:`Пользователи пишут неформально, а моделям нужно структурированное описание`}),_jsx(_components.td,{children:`Сначала вызовите текстовую модель для перезаписи, затем обратитесь к модели для работы с изображениями (раздел 2)`})]}),_jsxs(_components.tr,{children:[_jsxs(_components.td,{children:[_jsx(_components.strong,{children:`Предустановки стиля`}),` (десятки доступных по нажатию предустановок, а также сохранённые пользовательские)`]}),_jsx(_components.td,{children:`Фиксируют эстетику, поэтому пользователям не нужно знать терминологию фотографии`}),_jsx(_components.td,{children:`Предустановка — это всего лишь константа с фрагментом промпта в вашем коде и фиксированный набор эталонных изображений`})]}),_jsxs(_components.tr,{children:[_jsxs(_components.td,{children:[_jsx(_components.strong,{children:`Закрепление идентичности`}),` (например, `,_jsx(_components.code,{children:`Soul ID`}),` от Higgsfield, которое обучает постоянную идентичность на 20–80 фотографиях)`]}),_jsx(_components.td,{children:`Один и тот же человек остаётся неизменным в разных генерациях`}),_jsx(_components.td,{children:`Приблизить такой результат можно с помощью эталонных изображений (см. ограничения ниже)`})]}),_jsxs(_components.tr,{children:[_jsx(_components.td,{children:_jsx(_components.strong,{children:`Выборка нескольких вариантов с показом одного`})}),_jsx(_components.td,{children:`Пользователь видит только лучший вариант, поэтому воспринимаемая вероятность успеха приближается к 100%`}),_jsx(_components.td,{children:`Сгенерируйте N вариантов параллельно, затем попросите визуальную модель оценить их и выбрать лучший (раздел 3, шаги 3–4)`})]}),_jsxs(_components.tr,{children:[_jsx(_components.td,{children:_jsx(_components.strong,{children:`Пошаговое редактирование`})}),_jsx(_components.td,{children:`Составные инструкции надёжно дают сбои при выполнении за один запрос`}),_jsx(_components.td,{children:`Сначала зафиксируйте композицию, затем отредактируйте отдельные области и добавьте текст`})]}),_jsxs(_components.tr,{children:[_jsxs(_components.td,{children:[_jsx(_components.strong,{children:`Увеличение разрешения и постобработка`}),` (в 2024 году Freepik приобрела Magnific, предложив творческое увеличение в 2–16 раз)`]}),_jsx(_components.td,{children:`Превращают изображение небольшого размера в формат, готовый к печати`}),_jsx(_components.td,{children:`В APIYI нет такого эндпоинта — вместо этого генерируйте изображение с высоким разрешением (см. ограничения ниже)`})]}),_jsxs(_components.tr,{children:[_jsx(_components.td,{children:_jsx(_components.strong,{children:`Негативные промпты и резервные варианты для модерации`})}),_jsx(_components.td,{children:`Помогают обходить известные особенности поведения модели и перехватывать запросы, которые модерация отклонила бы`}),_jsx(_components.td,{children:`Включите фиксированные негативные формулировки в шаблон, а также предусмотрите запасной сценарий на случай сбоев модерации`})]}),_jsxs(_components.tr,{children:[_jsx(_components.td,{children:_jsx(_components.strong,{children:`Библиотека ресурсов и повторное размещение`})}),_jsx(_components.td,{children:`Пользовательские изображения никогда не истекают и не исчезают`}),_jsx(_components.td,{children:`Немедленно копируйте каждый результат в собственное объектное хранилище`})]})]})]}),`\n`,_jsxs(Warning,{children:[_jsx(_components.p,{children:_jsx(_components.strong,{children:`Два ограничения платформы, которые нужно учесть до копирования списка функций конкурента:`})}),_jsxs(_components.ol,{children:[`\n`,_jsxs(_components.li,{children:[_jsx(_components.strong,{children:`В APIYI нет эндпоинта для увеличения разрешения, удаления фона или восстановления лиц.`}),` Если вам нужно изображение большого размера, выберите тариф с высоким разрешением при генерации (`,_jsx(_components.code,{children:`gpt-image-2`}),` в 4K, Nano Banana Pro в 4K), а не планируйте последующее увеличение. Для прозрачного фона используйте официальный релей `,_jsx(_components.code,{children:`gpt-image-2.5-flare`}),` / `,_jsx(_components.code,{children:`gpt-image-2.5-sunburst`}),` с `,_jsx(_components.code,{children:`background: \"transparent\"`}),` — он возвращает PNG с настоящим альфа-каналом (OpenAI отключила прозрачность для `,_jsx(_components.code,{children:`gpt-image-2`}),` 30.09.2026) (`,_jsx(_components.code,{children:`seedream-5-0`}),` / `,_jsx(_components.code,{children:`seedream-5-0-pro`}),` можно только попросить создать с прозрачностью, и наличие альфа-канала не гарантируется при каждом вызове). См. раздел `,_jsx(_components.a,{href:`/ru/faq/image-transparent-background`,children:`Как генерировать изображения с прозрачным фоном`}),`.`]}),`\n`,_jsxs(_components.li,{children:[_jsx(_components.strong,{children:`APIYI не предоставляет обучение LoRA или обучение идентичности.`}),` Возможность «однократно обучить и навсегда зафиксировать лицо», лежащая в основе `,_jsx(_components.code,{children:`Soul ID`}),`, может быть лишь приблизительно воспроизведена с помощью эталонных изображений: один и тот же персонаж всё равно будет немного меняться в разных сценах и при изменении освещения, а наилучший результат достигается, когда новый кадр близок к фронтальному ракурсу и исходному освещению. Для коммерческих персонажей, требующих строгой согласованности, заложите в процесс этап проверки человеком.`]}),`\n`]})]}),`\n`,_jsx(Heading,{level:`2`,id:`2-первый-слой-уже-разделяет-результаты-превратите-неформальный-ввод-в-структуру`,children:`2. Первый слой уже разделяет результаты: превратите неформальный ввод в структуру`}),`\n`,_jsx(_components.p,{children:`Это самый эффективный слой, который чаще всего пропускают.`}),`\n`,_jsx(Heading,{level:`3`,id:`сравнительный-тест-одна-модель-один-бриф-два-промпта`,children:`Сравнительный тест: одна модель, один бриф, два промпта`}),`\n`,_jsxs(_components.p,{children:[`Бриф: «предметная съёмка кофе для интернет-магазина». Слева показано то, что пользователь действительно вводит; справа — тот же бриф с добавленными недостающими решениями. Оба варианта были запущены один раз на `,_jsx(_components.code,{children:`gemini-3-pro-image`}),` (Nano Banana Pro) при `,_jsx(_components.code,{children:`2K`}),`, `,_jsx(_components.code,{children:`1:1`}),`:`]}),`\n`,_jsx(Frame,{caption:`Casual prompt: 'Make me a coffee product shot, make it look nice, make it feel premium'`,children:_jsx(OptimizedImage,{src:`https://mintcdn.com/apiyillc/4sMX_MxhL2nRcbPH/images/image-workflow-prompt-before.jpg?fit=max\u0026auto=format\u0026n=4sMX_MxhL2nRcbPH\u0026q=85\u0026s=a2e2025bf74baf40a7b63a424762cb62`,alt:`Изображение кофе по неформальному промпту: деревянный стол, кофемолка, мешок из мешковины и другие незапрошенные предметы, тёплая ностальгическая цветокоррекция и вымышленное название бренда, напечатанное на чашке`,\"data-og-width\":`1280`,width:`1280`,\"data-og-height\":`1280`,height:`1280`,\"data-path\":`images/image-workflow-prompt-before.jpg`,\"data-optimize\":`true`,\"data-opv\":`3`,srcset:`https://mintcdn.com/apiyillc/4sMX_MxhL2nRcbPH/images/image-workflow-prompt-before.jpg?w=280\u0026fit=max\u0026auto=format\u0026n=4sMX_MxhL2nRcbPH\u0026q=85\u0026s=cdc6f261bdbade3a9151b43d99deed33 280w, https://mintcdn.com/apiyillc/4sMX_MxhL2nRcbPH/images/image-workflow-prompt-before.jpg?w=560\u0026fit=max\u0026auto=format\u0026n=4sMX_MxhL2nRcbPH\u0026q=85\u0026s=e6f697fd2f035f9d39a0cef120c30ff6 560w, https://mintcdn.com/apiyillc/4sMX_MxhL2nRcbPH/images/image-workflow-prompt-before.jpg?w=840\u0026fit=max\u0026auto=format\u0026n=4sMX_MxhL2nRcbPH\u0026q=85\u0026s=0ab09776f1d36718beda0903d57cb3e3 840w, https://mintcdn.com/apiyillc/4sMX_MxhL2nRcbPH/images/image-workflow-prompt-before.jpg?w=1100\u0026fit=max\u0026auto=format\u0026n=4sMX_MxhL2nRcbPH\u0026q=85\u0026s=b23c589ff1264ee042d455f3be56592b 1100w, https://mintcdn.com/apiyillc/4sMX_MxhL2nRcbPH/images/image-workflow-prompt-before.jpg?w=1650\u0026fit=max\u0026auto=format\u0026n=4sMX_MxhL2nRcbPH\u0026q=85\u0026s=6bf52a162e36e3efc6082e283b140b85 1650w, https://mintcdn.com/apiyillc/4sMX_MxhL2nRcbPH/images/image-workflow-prompt-before.jpg?w=2500\u0026fit=max\u0026auto=format\u0026n=4sMX_MxhL2nRcbPH\u0026q=85\u0026s=15fdbefaa8ce0c9bf88a8eb0877b09fc 2500w`})}),`\n`,_jsx(Frame,{caption:`Structured prompt: subject, environment, light position, lens, grading, imperfections and composition all specified`,children:_jsx(OptimizedImage,{src:`https://mintcdn.com/apiyillc/4sMX_MxhL2nRcbPH/images/image-workflow-prompt-after.jpg?fit=max\u0026auto=format\u0026n=4sMX_MxhL2nRcbPH\u0026q=85\u0026s=cb00b095545e5dcad8cb2c113fefe47f`,alt:`Изображение кофе по структурированному промпту: матовая чёрная керамическая чашка на светло-серой поверхности из микроцемента, чистый размытый фон, чётко заданное направление света, большое свободное пространство`,\"data-og-width\":`1280`,width:`1280`,\"data-og-height\":`1280`,height:`1280`,\"data-path\":`images/image-workflow-prompt-after.jpg`,\"data-optimize\":`true`,\"data-opv\":`3`,srcset:`https://mintcdn.com/apiyillc/4sMX_MxhL2nRcbPH/images/image-workflow-prompt-after.jpg?w=280\u0026fit=max\u0026auto=format\u0026n=4sMX_MxhL2nRcbPH\u0026q=85\u0026s=1e386f2df340f396a1cb6ab94b10e6f7 280w, https://mintcdn.com/apiyillc/4sMX_MxhL2nRcbPH/images/image-workflow-prompt-after.jpg?w=560\u0026fit=max\u0026auto=format\u0026n=4sMX_MxhL2nRcbPH\u0026q=85\u0026s=8458932292b8d4ab0a760e6c380a42a5 560w, https://mintcdn.com/apiyillc/4sMX_MxhL2nRcbPH/images/image-workflow-prompt-after.jpg?w=840\u0026fit=max\u0026auto=format\u0026n=4sMX_MxhL2nRcbPH\u0026q=85\u0026s=72d06312b1f8c31140260787e22ab7c7 840w, https://mintcdn.com/apiyillc/4sMX_MxhL2nRcbPH/images/image-workflow-prompt-after.jpg?w=1100\u0026fit=max\u0026auto=format\u0026n=4sMX_MxhL2nRcbPH\u0026q=85\u0026s=92afe2e96b655501b908861b2392991a 1100w, https://mintcdn.com/apiyillc/4sMX_MxhL2nRcbPH/images/image-workflow-prompt-after.jpg?w=1650\u0026fit=max\u0026auto=format\u0026n=4sMX_MxhL2nRcbPH\u0026q=85\u0026s=1df25d991b960115ed294465c1b167eb 1650w, https://mintcdn.com/apiyillc/4sMX_MxhL2nRcbPH/images/image-workflow-prompt-after.jpg?w=2500\u0026fit=max\u0026auto=format\u0026n=4sMX_MxhL2nRcbPH\u0026q=85\u0026s=2240107add42d7014c50fc820998f46d 2500w`})}),`\n`,_jsxs(_components.p,{children:[`Левое изображение не выглядит некрасивым, но оно `,_jsx(_components.strong,{children:`непригодно для использования`}),`. Модель самостоятельно приняла множество решений, на которые никто не давал согласия: добавила кофемолку и мешок из мешковины, выбрала тёплую ностальгическую цветокоррекцию и напечатала на чашке вымышленное название бренда — автоматически сгенерированный текст такого рода делает кадр коммерчески бесполезным. Правое изображение можно сразу размещать на странице товара: нейтральный фон, понятная световая схема, которую можно описать словами, и место для текста.`]}),`\n`,_jsxs(_components.p,{children:[_jsx(_components.strong,{children:`«Выглядит красиво» и «пригодно для использования» — разные цели.`}),` Неформальный промпт позволяет достичь только первой из них.`]}),`\n`,_jsx(Heading,{level:`3`,id:`шесть-элементов-которые-должен-добавить-слой-переформулирования`,children:`Шесть элементов, которые должен добавить слой переформулирования`}),`\n`,_jsx(_components.p,{children:`Переформулирование не означает, что промпт нужно сделать длиннее. Оно означает заполнение недостающих решений. Промпт для изображения состоит из шести ключевых частей:`}),`\n`,_jsxs(Table,{children:[_jsx(_components.thead,{children:_jsxs(_components.tr,{children:[_jsx(_components.th,{children:`Элемент`}),_jsx(_components.th,{children:`Что происходит без него`}),_jsx(_components.th,{children:`Пример`})]})}),_jsxs(_components.tbody,{children:[_jsxs(_components.tr,{children:[_jsx(_components.td,{children:_jsx(_components.strong,{children:`Объект`})}),_jsx(_components.td,{children:`Модель импровизирует и добавляет ненужные предметы`}),_jsx(_components.td,{children:`«Матовая чёрная керамическая чашка для пуровера, заполненная чёрным кофе на 80 %»`})]}),_jsxs(_components.tr,{children:[_jsx(_components.td,{children:_jsx(_components.strong,{children:`Окружение`})}),_jsx(_components.td,{children:`Фоны выбираются случайно, поэтому изображения из одной серии не сочетаются`}),_jsx(_components.td,{children:`«Светло-серая поверхность из микроцемента, стена в том же тоне, размытая»`})]}),_jsxs(_components.tr,{children:[_jsx(_components.td,{children:_jsx(_components.strong,{children:`Свет`})}),_jsx(_components.td,{children:`Плоское общее освещение сразу выглядит искусственным`}),_jsx(_components.td,{children:`«Ключевой свет от софтбокса сверху слева, под углом 45 градусов; справа — белый отражатель»`})]}),_jsxs(_components.tr,{children:[_jsx(_components.td,{children:_jsx(_components.strong,{children:`Объектив и угол`})}),_jsx(_components.td,{children:`Перспектива и глубина резкости находятся вне вашего контроля`}),_jsx(_components.td,{children:`«Макрообъектив 85 мм, f/5.6, фронтальный вид с наклоном на 15 градусов вниз»`})]}),_jsxs(_components.tr,{children:[_jsx(_components.td,{children:_jsx(_components.strong,{children:`Цветокоррекция и носитель`})}),_jsx(_components.td,{children:`По умолчанию результат получается перенасыщенным и похожим на рендер`}),_jsx(_components.td,{children:`«Холодный нейтральный баланс белого, низкая общая насыщенность»`})]}),_jsxs(_components.tr,{children:[_jsx(_components.td,{children:_jsx(_components.strong,{children:`Композиция`})}),_jsx(_components.td,{children:`Объект всегда оказывается точно в центре`}),_jsx(_components.td,{children:`«Чашка в левой трети кадра, справа — большое свободное пространство»`})]})]})]}),`\n`,_jsx(Tip,{children:_jsxs(_components.p,{children:[`Разрешение `,_jsx(_components.strong,{children:`не является седьмым элементом`}),`. Разрешение результата задаётся только такими параметрами, как `,_jsx(_components.code,{children:`size`}),` / `,_jsx(_components.code,{children:`imageSize`}),`; указание «4K» или «8K» в промпте не добавляет ни одного пикселя. См. раздел `,_jsx(_components.a,{href:`/ru/api-capabilities/image-compression-resolution`,children:`Сжатие изображений и разрешение результата`}),`.`]})}),`\n`,_jsx(Heading,{level:`3`,id:`слой-переформулирования-в-коде`,children:`Слой переформулирования в коде`}),`\n`,_jsx(_components.p,{children:`Для этой задачи достаточно недорогой быстрой текстовой модели; её стоимость незначительна по сравнению с генерацией:`}),`\n`,_jsx(CodeBlock,{filename:``,numberOfLines:`39`,language:`python`,children:_jsx(_components.pre,{className:`shiki shiki-themes github-light-default dark-plus`,style:{backgroundColor:`#ffffff`,\"--shiki-dark-bg\":`#0B0C0E`,color:`#1f2328`,\"--shiki-dark\":`#D4D4D4`},language:`python`,children:_jsxs(_components.code,{language:`python`,numberOfLines:`39`,children:[_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:`import`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` os`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:`import`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` requests`})]}),`\n`,_jsx(_components.span,{className:`line`}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#D4D4D4`},children:`BASE`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:` =`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:` \"https://api.apiyi.com/v1\"`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#D4D4D4`},children:`API_KEY`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:` =`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` os.environ[`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"APIYI_API_KEY\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`] `}),_jsx(_components.span,{style:{color:`#6E7781`,\"--shiki-dark\":`#6A9955`},children:`# never hard-code the key`})]}),`\n`,_jsx(_components.span,{className:`line`}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#D4D4D4`},children:`REWRITE_SYSTEM`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:` =`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:` \"\"\"You are an image prompt engineer. Rewrite the user's casual brief`})]}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`into one structured image prompt.`})}),`\n`,_jsx(_components.span,{className:`line`}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`Fill in all six elements. Supply whatever is missing; never ask the user:`})}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`1 Subject: material, colour, count, state`})}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`2 Environment: what the background is, what is sharp and what is blurred`})}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`3 Light: direction, hardness, fill or no fill — there must be one identifiable key light`})}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`4 Lens and angle: focal length, aperture, camera height, tilt`})}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`5 Grading and medium: white balance bias, saturation, film or digital character`})}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`6 Composition: where the subject sits in the frame, where the negative space is`})}),`\n`,_jsx(_components.span,{className:`line`}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`Rules:`})}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`- Output only the prompt body: no explanation, no bullet points, no heading`})}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`- No brand names, logos, or legible text unless the user asked for them`})}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`- Never use vague quality words such as 8K, ultra HD, masterpiece, perfect`})}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`- Keep any element the user specified exactly as written\"\"\"`})}),`\n`,_jsx(_components.span,{className:`line`}),`\n`,_jsx(_components.span,{className:`line`}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#569CD6`},children:`def`}),_jsx(_components.span,{style:{color:`#8250DF`,\"--shiki-dark\":`#DCDCAA`},children:` rewrite`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`(`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#9CDCFE`},children:`user_prompt`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: `}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#4EC9B0`},children:`str`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`) -> `}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#4EC9B0`},children:`str`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`:`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` r `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`=`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` requests.post(`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#569CD6`},children:` f`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#569CD6`},children:`{`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#D4D4D4`},children:`BASE`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#569CD6`},children:`}`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`/chat/completions\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`,`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#953800`,\"--shiki-dark\":`#9CDCFE`},children:` headers`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`=`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`{`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"Authorization\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#569CD6`},children:`f`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"Bearer `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#569CD6`},children:`{`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#D4D4D4`},children:`API_KEY`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#569CD6`},children:`}`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`},`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#953800`,\"--shiki-dark\":`#9CDCFE`},children:` json`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`=`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`{`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:` \"model\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: `}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"gemini-3.5-flash\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`,`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:` \"messages\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: [`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` {`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"role\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: `}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"system\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`, `}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"content\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: `}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#D4D4D4`},children:`REWRITE_SYSTEM`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`},`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` {`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"role\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: `}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"user\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`, `}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"content\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: user_prompt},`})]}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` ],`})}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` },`})}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#953800`,\"--shiki-dark\":`#9CDCFE`},children:` timeout`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`=`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#B5CEA8`},children:`60`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`,`})]}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` )`})}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` r.raise_for_status()`})}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:` return`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` r.json()[`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"choices\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`][`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#B5CEA8`},children:`0`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`][`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"message\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`][`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"content\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`].strip()`})]}),`\n`]})})}),`\n`,_jsx(_components.p,{children:`Обратите внимание на правило, запрещающее «8K, ультравысокое разрешение, шедевр, идеально» — в разделе 4 объясняется почему.`}),`\n`,_jsx(Heading,{level:`2`,id:`3-конвейер-который-действительно-можно-внедрить`,children:`3. Конвейер, который действительно можно внедрить`}),`\n`,_jsx(_components.p,{children:`Соедините оставшиеся четыре уровня с уровнем перезаписи — и вы получите всю систему:`}),`\n`,_jsxs(Steps,{children:[_jsx(Step,{title:`Перезапись: от неформального ввода к структурированному промпту`,children:_jsx(_components.p,{children:`См. раздел 2. На этом этапе также нейтрализуется чувствительный контент во вводе пользователя, что заметно снижает частоту блокировки запроса на последующих этапах.`})}),_jsxs(Step,{title:`Привязка: референсные изображения и константа стиля`,children:[_jsxs(_components.p,{children:[`Стиль фиксируется двумя составляющими: `,_jsx(_components.strong,{children:`константой стиля, добавляемой к каждому промпту`}),` (вашим пресетом), и `,_jsx(_components.strong,{children:`фиксированным набором референсных изображений`}),`.`]}),_jsx(_components.p,{children:`Ограничения на количество референсов значительно различаются у разных семейств — уточните их для своей модели до проектирования конвейера:`}),_jsxs(Table,{children:[_jsx(_components.thead,{children:_jsxs(_components.tr,{children:[_jsx(_components.th,{children:`Семейство моделей`}),_jsx(_components.th,{children:`Лимит референсов`}),_jsx(_components.th,{children:`Примечания`})]})}),_jsxs(_components.tbody,{children:[_jsxs(_components.tr,{children:[_jsx(_components.td,{children:`Nano Banana (все)`}),_jsxs(_components.td,{children:[_jsx(_components.strong,{children:`14`}),` (измерено)`]}),_jsxs(_components.td,{children:[`См. `,_jsx(_components.a,{href:`/ru/api-capabilities/multi-image-fusion-testing`,children:`Тестирование слияния нескольких изображений`})]})]}),_jsxs(_components.tr,{children:[_jsxs(_components.td,{children:[_jsx(_components.code,{children:`gpt-image-2`}),` семейство`]}),_jsx(_components.td,{\"data-numeric\":`true`,children:_jsx(_components.strong,{children:`16`})}),_jsxs(_components.td,{children:[`Повторите `,_jsx(_components.code,{children:`image[]`})]})]}),_jsxs(_components.tr,{children:[_jsx(_components.td,{children:`Seedream`}),_jsx(_components.td,{\"data-numeric\":`true`,children:_jsx(_components.strong,{children:`10`})}),_jsx(_components.td,{children:`Общее количество входных и выходных изображений не должно превышать 15`})]}),_jsxs(_components.tr,{children:[_jsx(_components.td,{children:`FLUX.2 pro / max / flex`}),_jsx(_components.td,{\"data-numeric\":`true`,children:_jsx(_components.strong,{children:`8`})}),_jsxs(_components.td,{children:[_jsx(_components.code,{children:`input_image_2`}),` … `,_jsx(_components.code,{children:`input_image_8`}),`; klein принимает 4, Kontext — 1`]})]}),_jsxs(_components.tr,{children:[_jsx(_components.td,{children:`Grok Imagine`}),_jsx(_components.td,{children:_jsx(_components.strong,{children:`1–4`})}),_jsx(_components.td,{children:`Пятое изображение возвращает ошибку 400`})]})]})]}),_jsxs(_components.p,{children:[`Необходимо соблюдать два правила: `,_jsx(_components.strong,{children:`«изображение 1 / изображение 2» в промпте строго соответствуют порядку в массиве`}),`, поэтому явно указывайте, какое изображение является каким; и `,_jsxs(_components.strong,{children:[`Grok учитывает референсные изображения только в `,_jsx(_components.code,{children:`/v1/images/edits`})]}),` — их передача в `,_jsx(_components.code,{children:`/v1/images/generations`}),` молча приводит к их удалению, при этом тарификация всё равно выполняется.`]})]}),_jsxs(Step,{title:`Пример: генерируйте N параллельно, не полагайтесь на n`,children:[_jsx(_components.p,{children:`Ощущение, что потребительский продукт «с первого раза всё сделал идеально», на самом деле создаётся за счёт того, что продукт разыгрывает несколько вариантов от вашего имени.`}),_jsxs(_components.p,{children:[`Но `,_jsxs(_components.strong,{children:[`серверный параметр `,_jsx(_components.code,{children:`n`}),` не влияет на большинство моделей изображений`]}),` (Seedream полностью его игнорирует). Чтобы получить несколько кандидатов, отправляйте несколько запросов параллельно со стороны клиента — на страницах навыков этого сайта их количество ограничено 5 одновременно. Настраивайте количество параллельных запросов для каждого канала; некоторые начинают возвращать ошибку 429 уже при значении 2, поэтому добавьте экспоненциальную задержку.`]})]}),_jsxs(Step,{title:`Отбор: используйте модель компьютерного зрения в качестве судьи`,children:[_jsx(_components.p,{children:`Получив N кандидатов, необходимо выбрать один автоматически, иначе вы просто переложите выбор на пользователя.`}),_jsxs(_components.p,{children:[`Отправьте кандидатов обратно в модель компьютерного зрения для оценки через стандартный `,_jsx(_components.code,{children:`/v1/chat/completions`}),` ввод изображений; подходящие модели перечислены в разделе `,_jsx(_components.a,{href:`/ru/api-capabilities/vision-understanding`,children:`Понимание изображений`}),`. Зафиксируйте критерии оценки по пяти измерениям и потребуйте ответ в формате JSON: соответствие инструкциям, структура и анатомия, корректность текста, реалистичность текстур, композиция.`]}),_jsx(Warning,{children:_jsxs(_components.p,{children:[`Не используйте для этого `,_jsx(_components.code,{children:`/v1/rerank`}),`. `,_jsx(_components.code,{children:`bge-reranker-v2-m3`}),` — это `,_jsx(_components.strong,{children:`модель переранжирования, работающая только с текстом`}),`, которая не принимает изображения. Для оценки изображений требуется модель понимания изображений.`]})})]}),_jsxs(Step,{title:`Ретушируйте и доводите результат`,children:[_jsx(_components.p,{children:`После фиксации композиции вносите локальные изменения — это обеспечивает гораздо более высокий процент успеха, чем одна составная инструкция:`}),_jsxs(_components.ul,{children:[`\n`,_jsxs(_components.li,{children:[_jsx(_components.strong,{children:`Локальная перерисовка на уровне пикселей`}),`: только `,_jsxs(_components.strong,{children:[`официальный релей `,_jsx(_components.code,{children:`gpt-image-2`})]}),` поддерживает маски; см. `,_jsx(_components.a,{href:`/ru/api-capabilities/gpt-image-2/mask-editing`,children:`Руководство по масочному восстановлению`}),`.`]}),`\n`,_jsxs(_components.li,{children:[_jsx(_components.strong,{children:`Накопительное редактирование в несколько ходов`}),`: поддерживается на `,_jsx(_components.strong,{children:`нативном эндпоинте Gemini`}),` для моделей Nano Banana (передавайте предыдущее изображение обратно как `,_jsx(_components.code,{children:`role: \"model\"`}),`); маршруты, созданные обратной инженерией, этого не поддерживают.`]}),`\n`,_jsxs(_components.li,{children:[_jsx(_components.strong,{children:`Немедленно размещайте изображения заново`}),`: каждый возвращаемый URL является временным (для FLUX — около 10 минут и без CORS; для Seedream и R2 — около 24 часов), поэтому сразу после получения загружайте изображение в собственное объектное хранилище.`]}),`\n`]})]})]}),`\n`,_jsx(Heading,{level:`3`,id:`минимальная-сквозная-реализация`,children:`Минимальная сквозная реализация`}),`\n`,_jsx(CodeBlock,{filename:``,numberOfLines:`83`,language:`python`,children:_jsx(_components.pre,{className:`shiki shiki-themes github-light-default dark-plus`,style:{backgroundColor:`#ffffff`,\"--shiki-dark-bg\":`#0B0C0E`,color:`#1f2328`,\"--shiki-dark\":`#D4D4D4`},language:`python`,children:_jsxs(_components.code,{language:`python`,numberOfLines:`83`,children:[_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:`import`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` base64`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:`import`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` json`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:`import`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` os`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:`from`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` concurrent.futures `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:`import`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` ThreadPoolExecutor`})]}),`\n`,_jsx(_components.span,{className:`line`}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:`import`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` requests`})]}),`\n`,_jsx(_components.span,{className:`line`}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#D4D4D4`},children:`BASE`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:` =`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:` \"https://api.apiyi.com\"`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#D4D4D4`},children:`API_KEY`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:` =`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` os.environ[`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"APIYI_API_KEY\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`]`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#D4D4D4`},children:`HEAD`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:` =`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` {`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"Authorization\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#569CD6`},children:`f`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"Bearer `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#569CD6`},children:`{`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#D4D4D4`},children:`API_KEY`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#569CD6`},children:`}`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`}`})]}),`\n`,_jsx(_components.span,{className:`line`}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#D4D4D4`},children:`STYLE_CONST`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:` =`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:` \"Cool neutral white balance, low saturation, clean frame with generous negative space.\"`})]}),`\n`,_jsx(_components.span,{className:`line`}),`\n`,_jsx(_components.span,{className:`line`}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#569CD6`},children:`def`}),_jsx(_components.span,{style:{color:`#8250DF`,\"--shiki-dark\":`#DCDCAA`},children:` draw`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`(`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#9CDCFE`},children:`prompt`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: `}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#4EC9B0`},children:`str`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`, `}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#9CDCFE`},children:`size`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: `}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#4EC9B0`},children:`str`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:` =`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:` \"2K\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`, `}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#9CDCFE`},children:`aspect`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: `}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#4EC9B0`},children:`str`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:` =`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:` \"1:1\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`) -> `}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#4EC9B0`},children:`bytes`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`:`})]}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:` \"\"\"Generate one image (Nano Banana Pro, native Gemini endpoint).\"\"\"`})}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` url `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`=`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#569CD6`},children:` f`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#569CD6`},children:`{`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#D4D4D4`},children:`BASE`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#569CD6`},children:`}`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`/v1beta/models/gemini-3-pro-image:generateContent\"`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` body `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`=`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` {`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:` \"contents\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: [{`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"parts\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: [{`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"text\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: prompt}]}],`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:` \"generationConfig\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: {`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:` \"responseModalities\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: [`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"IMAGE\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`],`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:` \"imageConfig\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: {`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"aspectRatio\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: aspect, `}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"imageSize\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: size},`})]}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` },`})}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` }`})}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` r `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`=`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` requests.post(url, `}),_jsx(_components.span,{style:{color:`#953800`,\"--shiki-dark\":`#9CDCFE`},children:`headers`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`=`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#D4D4D4`},children:`HEAD`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`, `}),_jsx(_components.span,{style:{color:`#953800`,\"--shiki-dark\":`#9CDCFE`},children:`json`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`=`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`body, `}),_jsx(_components.span,{style:{color:`#953800`,\"--shiki-dark\":`#9CDCFE`},children:`timeout`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`=`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#B5CEA8`},children:`600`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`) `}),_jsx(_components.span,{style:{color:`#6E7781`,\"--shiki-dark\":`#6A9955`},children:`# headroom for 4K`})]}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` r.raise_for_status()`})}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` parts `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`=`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` r.json()[`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"candidates\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`][`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#B5CEA8`},children:`0`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`][`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"content\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`][`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"parts\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`]`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` part `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`=`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#DCDCAA`},children:` next`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`((p `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:`for`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` p `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:`in`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` parts `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:`if`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` p.get(`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"inlineData\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`)), `}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#569CD6`},children:`None`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`)`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:` if`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` part `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#569CD6`},children:`is`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#569CD6`},children:` None`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: `}),_jsx(_components.span,{style:{color:`#6E7781`,\"--shiki-dark\":`#6A9955`},children:`# HTTP 200 with no image usually means moderation`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:` raise`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#4EC9B0`},children:` RuntimeError`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`(`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"no image returned: \"`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:` +`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` json.dumps(parts)[:`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#B5CEA8`},children:`300`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`])`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:` return`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` base64.b64decode(part[`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"inlineData\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`][`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"data\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`])`})]}),`\n`,_jsx(_components.span,{className:`line`}),`\n`,_jsx(_components.span,{className:`line`}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#569CD6`},children:`def`}),_jsx(_components.span,{style:{color:`#8250DF`,\"--shiki-dark\":`#DCDCAA`},children:` score`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`(`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#9CDCFE`},children:`image`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: `}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#4EC9B0`},children:`bytes`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`, `}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#9CDCFE`},children:`prompt`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: `}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#4EC9B0`},children:`str`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`) -> `}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#4EC9B0`},children:`dict`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`:`})]}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:` \"\"\"Score a candidate with a vision model; returns per-dimension scores and one issue line.\"\"\"`})}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` data_url `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`=`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:` \"data:image/png;base64,\"`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:` +`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` base64.b64encode(image).decode()`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` rubric `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`=`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` (`})]}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:` \"Score this image and return strict JSON: \"`})}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:` '{\"instruction\":0-10,\"anatomy\":0-10,\"text\":0-10,\"texture\":0-10,'`})}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:` '\"composition\":0-10,\"total\":0-50,\"issue\":\"one sentence\"}. '`})}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:` \"instruction = does it satisfy the brief below; anatomy = errors in hands, limbs, object structure; \"`})}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:` \"text = is any text in the image correct (score 10 if there is none); \"`})}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:` \"texture = does it read as a real photograph rather than a render; \"`})}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:` \"composition = is the framing usable. The brief:`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D7BA7D`},children:`\\\\n`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:` +`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` prompt`})]}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` )`})}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` r `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`=`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` requests.post(`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#569CD6`},children:` f`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#569CD6`},children:`{`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#D4D4D4`},children:`BASE`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#569CD6`},children:`}`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`/v1/chat/completions\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`,`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#953800`,\"--shiki-dark\":`#9CDCFE`},children:` headers`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`=`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#D4D4D4`},children:`HEAD`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`,`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#953800`,\"--shiki-dark\":`#9CDCFE`},children:` json`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`=`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`{`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:` \"model\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: `}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"gemini-3.5-flash\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`,`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:` \"messages\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: [{`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"role\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: `}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"user\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`, `}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"content\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: [`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` {`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"type\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: `}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"text\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`, `}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"text\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: rubric},`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` {`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"type\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: `}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"image_url\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`, `}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"image_url\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: {`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"url\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: data_url}},`})]}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` ]}],`})}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:` \"response_format\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: {`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"type\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: `}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"json_object\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`},`})]}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` },`})}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#953800`,\"--shiki-dark\":`#9CDCFE`},children:` timeout`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`=`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#B5CEA8`},children:`120`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`,`})]}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` )`})}),`\n`,_jsx(_components.span,{className:`line`,children:_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` r.raise_for_status()`})}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:` return`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` json.loads(r.json()[`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"choices\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`][`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#B5CEA8`},children:`0`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`][`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"message\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`][`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"content\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`])`})]}),`\n`,_jsx(_components.span,{className:`line`}),`\n`,_jsx(_components.span,{className:`line`}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#569CD6`},children:`def`}),_jsx(_components.span,{style:{color:`#8250DF`,\"--shiki-dark\":`#DCDCAA`},children:` best_of`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`(`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#9CDCFE`},children:`user_input`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: `}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#4EC9B0`},children:`str`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`, `}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#9CDCFE`},children:`n`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: `}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#4EC9B0`},children:`int`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:` =`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#B5CEA8`},children:` 4`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`) -> `}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#4EC9B0`},children:`bytes`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`:`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` prompt `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`=`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` rewrite(user_input) `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`+`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:` \"`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D7BA7D`},children:`\\\\n`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:` +`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#D4D4D4`},children:` STYLE_CONST`}),_jsx(_components.span,{style:{color:`#6E7781`,\"--shiki-dark\":`#6A9955`},children:` # steps 1 and 2`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:` with`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` ThreadPoolExecutor(`}),_jsx(_components.span,{style:{color:`#953800`,\"--shiki-dark\":`#9CDCFE`},children:`max_workers`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`=`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`n) `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:`as`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` pool: `}),_jsx(_components.span,{style:{color:`#6E7781`,\"--shiki-dark\":`#6A9955`},children:`# step 3: client-side fan-out`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` results `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`=`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#4EC9B0`},children:` list`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`(pool.map(`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#569CD6`},children:`lambda`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#9CDCFE`},children:` _`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: _safe(draw, prompt), `}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#DCDCAA`},children:`range`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`(n)))`})]}),`\n`,_jsx(_components.span,{className:`line`}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` cands `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`=`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` [img `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:`for`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` ok, img `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:`in`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` results `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:`if`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` ok]`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:` if`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#569CD6`},children:` not`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` cands:`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:` raise`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#4EC9B0`},children:` RuntimeError`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`(`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"all candidates failed; check moderation or fall back to another model\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`)`})]}),`\n`,_jsx(_components.span,{className:`line`}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:` with`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` ThreadPoolExecutor(`}),_jsx(_components.span,{style:{color:`#953800`,\"--shiki-dark\":`#9CDCFE`},children:`max_workers`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`=`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#DCDCAA`},children:`len`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`(cands)) `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:`as`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` pool: `}),_jsx(_components.span,{style:{color:`#6E7781`,\"--shiki-dark\":`#6A9955`},children:`# step 4: score in parallel`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` scores `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`=`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#4EC9B0`},children:` list`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`(pool.map(`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#569CD6`},children:`lambda`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#9CDCFE`},children:` im`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: score(im, prompt), cands))`})]}),`\n`,_jsx(_components.span,{className:`line`}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` ranked `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`=`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#DCDCAA`},children:` sorted`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`(`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#DCDCAA`},children:`zip`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`(cands, scores), `}),_jsx(_components.span,{style:{color:`#953800`,\"--shiki-dark\":`#9CDCFE`},children:`key`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`=`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#569CD6`},children:`lambda`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#9CDCFE`},children:` x`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`: x[`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#B5CEA8`},children:`1`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`][`}),_jsx(_components.span,{style:{color:`#0A3069`,\"--shiki-dark\":`#CE9178`},children:`\"total\"`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`], `}),_jsx(_components.span,{style:{color:`#953800`,\"--shiki-dark\":`#9CDCFE`},children:`reverse`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`=`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#569CD6`},children:`True`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`)`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:` return`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` ranked[`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#B5CEA8`},children:`0`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`][`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#B5CEA8`},children:`0`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`] `}),_jsx(_components.span,{style:{color:`#6E7781`,\"--shiki-dark\":`#6A9955`},children:`# step 5 retouch/rehost hooks in here`})]}),`\n`,_jsx(_components.span,{className:`line`}),`\n`,_jsx(_components.span,{className:`line`}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#569CD6`},children:`def`}),_jsx(_components.span,{style:{color:`#8250DF`,\"--shiki-dark\":`#DCDCAA`},children:` _safe`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`(`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#9CDCFE`},children:`fn`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`, `}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`*`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#9CDCFE`},children:`args`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`):`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:` try`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`:`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:` return`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#569CD6`},children:` True`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`, fn(`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#D4D4D4`},children:`*`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`args)`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:` except`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#4EC9B0`},children:` Exception`}),_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:` as`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:` e: `}),_jsx(_components.span,{style:{color:`#6E7781`,\"--shiki-dark\":`#6A9955`},children:`# one failure must not sink the batch`})]}),`\n`,_jsxs(_components.span,{className:`line`,children:[_jsx(_components.span,{style:{color:`#CF222E`,\"--shiki-dark\":`#C586C0`},children:` return`}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#569CD6`},children:` False`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`, `}),_jsx(_components.span,{style:{color:`#0550AE`,\"--shiki-dark\":`#4EC9B0`},children:`str`}),_jsx(_components.span,{style:{color:`#1F2328`,\"--shiki-dark\":`#D4D4D4`},children:`(e)`})]}),`\n`]})})}),`\n`,_jsx(Heading,{level:`2`,id:`4-устранение-визуальных-признаков-ии`,children:`4. Устранение визуальных признаков ИИ`}),`\n`,_jsxs(_components.p,{children:[`«Вид, характерный для ИИ», — не загадка. Это `,_jsx(_components.strong,{children:`набор конкретных признаков, которые можно устранять по одному`}),`.`]}),`\n`,_jsx(Heading,{level:`3`,id:`сравнительный-тест`,children:`Сравнительный тест`}),`\n`,_jsxs(_components.p,{children:[`Одна и та же модель (`,_jsx(_components.code,{children:`gemini-3-pro-image`}),`), один и тот же объект, два стиля промптов, по два изображения каждого варианта; показано первое изображение из каждой серии:`]}),`\n`,_jsx(Frame,{caption:`Bare prompt: 'A photorealistic half-body portrait of a young woman by a cafe window, smiling at the camera, 8K, ultra HD, ultra detailed, flawless skin, beautiful, perfect lighting, masterpiece'`,children:_jsx(OptimizedImage,{src:`https://mintcdn.com/apiyillc/4sMX_MxhL2nRcbPH/images/image-workflow-texture-before.jpg?fit=max\u0026auto=format\u0026n=4sMX_MxhL2nRcbPH\u0026q=85\u0026s=0623ee0bf7aa07fab43cd347d9aa4a7d`,alt:`Портрет по минимальному промпту: объект в центре, смотрит в камеру, равномерное освещение без различимого направления света, аккуратный фон, вид типичной стоковой фотографии`,\"data-og-width\":`1280`,width:`1280`,\"data-og-height\":`956`,height:`956`,\"data-path\":`images/image-workflow-texture-before.jpg`,\"data-optimize\":`true`,\"data-opv\":`3`,srcset:`https://mintcdn.com/apiyillc/4sMX_MxhL2nRcbPH/images/image-workflow-texture-before.jpg?w=280\u0026fit=max\u0026auto=format\u0026n=4sMX_MxhL2nRcbPH\u0026q=85\u0026s=1da07d9d22728413529c5cd02ca7a8a4 280w, https://mintcdn.com/apiyillc/4sMX_MxhL2nRcbPH/images/image-workflow-texture-before.jpg?w=560\u0026fit=max\u0026auto=format\u0026n=4sMX_MxhL2nRcbPH\u0026q=85\u0026s=48cc76890fc115ba84418cc29080dc48 560w, https://mintcdn.com/apiyillc/4sMX_MxhL2nRcbPH/images/image-workflow-texture-before.jpg?w=840\u0026fit=max\u0026auto=format\u0026n=4sMX_MxhL2nRcbPH\u0026q=85\u0026s=0596f0e5a57cf031c576b1f3fc2f457c 840w, https://mintcdn.com/apiyillc/4sMX_MxhL2nRcbPH/images/image-workflow-texture-before.jpg?w=1100\u0026fit=max\u0026auto=format\u0026n=4sMX_MxhL2nRcbPH\u0026q=85\u0026s=0a949b43b54a71d68b17662bcaefd01a 1100w, https://mintcdn.com/apiyillc/4sMX_MxhL2nRcbPH/images/image-workflow-texture-before.jpg?w=1650\u0026fit=max\u0026auto=format\u0026n=4sMX_MxhL2nRcbPH\u0026q=85\u0026s=6cd2bb12f2dcf609d2d8c5abb0bd0156 1650w, https://mintcdn.com/apiyillc/4sMX_MxhL2nRcbPH/images/image-workflow-texture-before.jpg?w=2500\u0026fit=max\u0026auto=format\u0026n=4sMX_MxhL2nRcbPH\u0026q=85\u0026s=402aea8964783728164b064d5d65b673 2500w`})}),`\n`,_jsx(Frame,{caption:`The same subject after adding four blocks of control language: light position, lens, medium, imperfections`,children:_jsx(OptimizedImage,{src:`https://mintcdn.com/apiyillc/4sMX_MxhL2nRcbPH/images/image-workflow-texture-after.jpg?fit=max\u0026auto=format\u0026n=4sMX_MxhL2nRcbPH\u0026q=85\u0026s=83efd55ea2ba552a67c04aa2e0f99936`,alt:`Портрет по контролируемому промпту: один направленный свет из окна, половина лица в тени, видимые поры и пушковые волосы на лице, небольшая родинка на щеке, выбившиеся пряди волос, плёночная цветокоррекция, объект расположен правее центра`,\"data-og-width\":`1280`,width:`1280`,\"data-og-height\":`956`,height:`956`,\"data-path\":`images/image-workflow-texture-after.jpg`,\"data-optimize\":`true`,\"data-opv\":`3`,srcset:`https://mintcdn.com/apiyillc/4sMX_MxhL2nRcbPH/images/image-workflow-texture-after.jpg?w=280\u0026fit=max\u0026auto=format\u0026n=4sMX_MxhL2nRcbPH\u0026q=85\u0026s=bccba09fbb4d009c48de6e45cd3e81f9 280w, https://mintcdn.com/apiyillc/4sMX_MxhL2nRcbPH/images/image-workflow-texture-after.jpg?w=560\u0026fit=max\u0026auto=format\u0026n=4sMX_MxhL2nRcbPH\u0026q=85\u0026s=c40cc2e21dab1a17da9bd9d3790c8f9e 560w, https://mintcdn.com/apiyillc/4sMX_MxhL2nRcbPH/images/image-workflow-texture-after.jpg?w=840\u0026fit=max\u0026auto=format\u0026n=4sMX_MxhL2nRcbPH\u0026q=85\u0026s=700e5a4768bb1be633dbae7bd4d16919 840w, https://mintcdn.com/apiyillc/4sMX_MxhL2nRcbPH/images/image-workflow-texture-after.jpg?w=1100\u0026fit=max\u0026auto=format\u0026n=4sMX_MxhL2nRcbPH\u0026q=85\u0026s=6c083ef18a027864f0197bdc55b5745d 1100w, https://mintcdn.com/apiyillc/4sMX_MxhL2nRcbPH/images/image-workflow-texture-after.jpg?w=1650\u0026fit=max\u0026auto=format\u0026n=4sMX_MxhL2nRcbPH\u0026q=85\u0026s=3ce88999d2c9543ea9f3f9463a955fb7 1650w, https://mintcdn.com/apiyillc/4sMX_MxhL2nRcbPH/images/image-workflow-texture-after.jpg?w=2500\u0026fit=max\u0026auto=format\u0026n=4sMX_MxhL2nRcbPH\u0026q=85\u0026s=89f7d08d6891faecd09c16be56c62999 2500w`})}),`\n`,_jsxs(_components.p,{children:[`Левое изображение неплохое — базовая модель достаточно сильна, поэтому даже минимальный промпт даёт привлекательную картинку. Но в нём проявляется полный набор характеристик: `,_jsx(_components.strong,{children:`объект жёстко расположен точно по центру, свет настолько равномерный, что невозможно сказать, откуда он исходит, и каждый элемент выглядит безупречно`}),`. И это не случайность: оба изображения из этой серии имели практически одинаковые композицию и схему освещения.`]}),`\n`,_jsxs(_components.p,{children:[`В правом изображении использован другой подход: у света есть направление, половине лица позволено оказаться в тени, на коже видны жирный блеск и поры, на щеке есть родинка, выбившиеся волосы не приглажены, а объект расположен правее центра. Оно воспринимается как `,_jsx(_components.strong,{children:`снимок конкретного человека в конкретный момент`}),`, а не как «стоковое изображение улыбающейся женщины в кафе».`]}),`\n`,_jsx(Info,{children:_jsxs(_components.p,{children:[`Именно здесь также проявляется реальная ценность конвейера. Он не превращает некрасивый результат в красивый — он `,_jsx(_components.strong,{children:`превращает «удачный случай» в хороший результат, который вы задали, можете описать и воспроизвести`}),`. Заказчику правое изображение может понравиться меньше, но по левому невозможно сказать, почему оно выглядит именно так, и нельзя попросить получить следующее изображение в том же стиле.`]})}),`\n`,_jsx(Heading,{level:`3`,id:`симптом-исправление-и-чего-не-следует-писать`,children:`Симптом, исправление и чего не следует писать`}),`\n`,_jsxs(Table,{children:[_jsx(_components.thead,{children:_jsxs(_components.tr,{children:[_jsx(_components.th,{children:`Симптом характерного вида AI`}),_jsx(_components.th,{children:`Исправление (впишите это в промпт)`}),_jsx(_components.th,{children:`Не пишите это`})]})}),_jsxs(_components.tbody,{children:[_jsxs(_components.tr,{children:[_jsx(_components.td,{children:`Объект всегда по центру, симметричная композиция`}),_jsx(_components.td,{children:`Укажите расположение: «объект справа от центра, свободное пространство слева»`}),_jsx(_components.td,{children:`«идеальная композиция», «золотое сечение»`})]}),_jsxs(_components.tr,{children:[_jsx(_components.td,{children:`Пластиковая кожа без пор`}),_jsx(_components.td,{children:`«естественная текстура кожи, видимые поры и пушковые волосы на лице, лёгкий блеск на носу, без ретуши»`}),_jsx(_components.td,{children:`«безупречная кожа», «изысканный», «красивый»`})]}),_jsxs(_components.tr,{children:[_jsx(_components.td,{children:`Ровный свет без различимого источника`}),_jsx(_components.td,{children:`Назовите один ключевой источник света и его жёсткость: «свет из окна слева — единственный источник, правая половина лица в тени»`}),_jsx(_components.td,{children:`«идеальное освещение», «мягкое освещение»`})]}),_jsxs(_components.tr,{children:[_jsx(_components.td,{children:`Ненастоящая глубина резкости, фон выглядит наклеенным`}),_jsx(_components.td,{children:`Укажите фокусное расстояние и диафрагму: «85mm, f/2.8, фокус на ближайшем глазе»`}),_jsx(_components.td,{children:`«размытый фон», «кинематографичный»`})]}),_jsxs(_components.tr,{children:[_jsx(_components.td,{children:`Перенасыщенный, светящийся цвет`}),_jsx(_components.td,{children:`Укажите тип плёнки и баланс белого: «характер Kodak Portra 400, тёплые света и холодные тени, низкая насыщенность»`}),_jsx(_components.td,{children:`«яркие цвета», «HDR»`})]}),_jsxs(_components.tr,{children:[_jsx(_components.td,{children:`Всё выглядит новым и неношеным`}),_jsx(_components.td,{children:`Намеренно добавьте следы использования: «свитер в катышках, следы от стаканов и крошки на столе»`}),_jsx(_components.td,{children:`«чисто и аккуратно», «премиальная текстура»`})]}),_jsxs(_components.tr,{children:[_jsx(_components.td,{children:`Выглядит как постер или рендер`}),_jsx(_components.td,{children:`Укажите ситуацию съёмки: «непостановочный снимок», «на уровне глаз, вид с соседнего столика»`}),_jsx(_components.td,{children:`«8K», «ультра-HD», «шедевр»`})]})]})]}),`\n`,_jsx(Warning,{children:_jsxs(_components.p,{children:[_jsxs(_components.strong,{children:[`Расплывчатые слова о качестве, такие как `,_jsx(_components.code,{children:`8K`}),`, `,_jsx(_components.code,{children:`ultra HD`}),`, `,_jsx(_components.code,{children:`ultra detailed`}),`, `,_jsx(_components.code,{children:`masterpiece`}),` и `,_jsx(_components.code,{children:`perfect`}),`, в итоге вредят.`]}),` Они не добавляют детализации (это делают только параметры) и подталкивают модель к чрезмерно резкому, перенасыщенному рендеру — именно это и составляет основу характерного вида AI. Приведённый выше промпт слева был перегружен такими словами, и результат это показывает. Если вам нужно качество, вместо этого указывайте конкретные параметры света, объектива и типа плёнки.`]})}),`\n`,_jsx(Heading,{level:`3`,id:`четыре-блока-управляющих-формулировок-для-копирования-и-вставки`,children:`Четыре блока управляющих формулировок для копирования и вставки`}),`\n`,_jsx(_components.p,{children:`При необходимости добавляйте их в промпт; обычно достаточно одной-двух строк из каждого блока:`}),`\n`,_jsxs(CardGroup,{cols:2,children:[_jsx(Card,{title:`Свет`,icon:`sun`,children:_jsx(_components.p,{children:`свет из окна слева — единственный источник в кадре / жёсткий контровой свет сзади в три часа дня / контровой свет с бликом по контуру волос / настольная лампа в кадре в качестве практического источника света / рассеянный свет пасмурного дня без выраженных теней`})}),_jsx(Card,{title:`Объектив`,icon:`aperture`,children:_jsx(_components.p,{children:`35 мм, f/2.0, спонтанный снимок, на уровне глаз / 85 мм, f/2.8, фокус на ближнем глазе / 24 мм с низкой точки съёмки, лёгкое искажение по краям / длиннофокусный объектив сжимающий пространство, уплощённые слои фона / лёгкое виньетирование в углах`})}),_jsx(Card,{title:`Среда`,icon:`film`,children:_jsx(_components.p,{children:`характер Kodak Portra 400, мелкое зерно / тёплые светлые участки, холодные тени / мгновенная плёнка Polaroid, низкий контраст, мягкие края / шум и цветовой оттенок ранней цифровой камеры на CCD / в целом низкая насыщенность, без повышения резкости`})}),_jsx(Card,{title:`Несовершенства`,icon:`scan-line`,children:_jsx(_components.p,{children:`естественная текстура кожи, видимые поры и пушковые волосы на лице / несколько выбившихся, непричёсанных прядей волос / свалявшийся свитер, потёртые манжеты / следы от стаканов, отпечатки пальцев и крошки на столе / нецентрированная композиция, часть объекта обрезана краем кадра`})})]}),`\n`,_jsx(Heading,{level:`3`,id:`три-полных-примера`,children:`Три полных примера`}),`\n`,_jsxs(AccordionGroup,{children:[_jsx(Accordion,{title:`Портрет: естественный, не на паспорт`,id:`portret-estestvenniy-ne-na-pasport`,children:_jsx(_components.p,{children:`Естественный поясной портрет: женщина чуть старше двадцати пяти лет у окна кафе, повернувшись в сторону и глядя наружу; на её лице улыбка, которую она едва сдерживает. Свет из окна слева — единственный источник в кадре; правая половина лица погружена в тень, под переносицей видна небольшая тень с чёткими краями. Объектив 85 мм, f/2.8, уровень глаз, фокус на ближнем глазе. Характер Kodak Portra 400 с мелким заметным зерном, тёплыми светами и холодными тенями, общая низкая насыщенность. Естественная кожа: видимые поры и пушковые волосы, лёгкий блеск сбоку носа, небольшая родинка на левой щеке, несколько выбившихся волосков бровей, свободные пряди волос, не приглаженные у лба. Без сглаживания кожи, косметической ретуши и повышения резкости. Объект справа от центра, слева — свободное пространство.`})}),_jsx(Accordion,{title:`Предметная съёмка: готово для страницы товара`,id:`predmetnaya-syomka-gotovo-dlya-stranitsy-tovara`,children:_jsx(_components.p,{children:`Главный кадр для интернет-магазина: матовая чёрная керамическая чашка для пуровера, заполненная на 80 % чёрным кофе; на поверхности — тонкое кольцо крема. Она стоит на светло-серой поверхности из микроцемента, а на заднем плане размыта стена того же оттенка. Ключевой свет от софтбокса слева сверху, под углом 45 градусов; белый отражатель справа оставляет узкий блик вдоль правого края чашки; мягкая падающая тень направлена назад и вправо. Макрообъектив 85 мм, f/5.6, фронтальный вид с наклоном вниз на 15 градусов, вся чашка в резкости. Холодный нейтральный баланс белого, общая низкая насыщенность. Глазурь слегка неровная, с характером ручной работы, и имеет одну крошечную отметину от обжига; на краю чашки виден едва заметный след использования. Много свободного пространства, чашка расположена в левой трети кадра. На изображении нигде нет названий брендов или текста.`})}),_jsx(Accordion,{title:`Окружение: укажите конкретное время и погоду`,id:`okruzhenie-ukazhite-konkretnoe-vremya-i-pogodu`,children:_jsx(_components.p,{children:`Узкая улица старого города в шесть часов вечера, сразу после дождя; лужи отражают световые короба магазинов по обеим сторонам. Единственный ключевой свет — тёплый уличный фонарь в конце улицы; окна магазинов служат заполняющим светом, а в небе ещё сохраняется холодный сумеречный свет, создавая контраст тёплых и холодных оттенков. Объектив 28 мм, f/4, камера на уровне глаз, слегка наклонена вверх. Общая низкая насыщенность, шум сохранён в тенях, без осветления теней. На стенах видны потёки воды, оборванные старые плакаты и блоки кондиционеров; в верхней части кадра проходят линии электропередачи. Никто не смотрит в камеру; прохожие видны со спины и слегка размыты в движении.`})})]}),`\n`,_jsx(Heading,{level:`2`,id:`5-факты-которые-изменят-проектирование-вашего-пайплайна`,children:`5. Факты, которые изменят проектирование вашего пайплайна`}),`\n`,_jsx(_components.p,{children:`Знание этих фактов заранее поможет избежать повторной работы:`}),`\n`,_jsxs(Table,{children:[_jsx(_components.thead,{children:_jsxs(_components.tr,{children:[_jsx(_components.th,{children:`Факт`}),_jsx(_components.th,{children:`Последствие для пайплайна`})]})}),_jsxs(_components.tbody,{children:[_jsxs(_components.tr,{children:[_jsxs(_components.td,{children:[_jsx(_components.strong,{children:`Seed фактически недоступен во всей этой линейке продуктов`}),`: ни одна модель Nano Banana или GPT-Image не предоставляет Seed, эффективность Seed в Seedream 4.x / 5.x была признана недостаточной, а Grok Imagine его не поддерживает`]}),_jsxs(_components.td,{children:[`Не стройте воспроизводимость на Seed. `,_jsx(_components.strong,{children:`Единственный надёжный способ воспроизведения — архивировать полный успешный запрос`}),` — промпт, референсные изображения и каждый параметр — и повторно отправлять его без изменений`]})]}),_jsxs(_components.tr,{children:[_jsx(_components.td,{children:_jsxs(_components.strong,{children:[`Параметр сервера `,_jsx(_components.code,{children:`n`}),` не влияет на большинство моделей изображений`]})}),_jsx(_components.td,{children:`Несколько вариантов необходимо получать за счёт параллельных запросов на стороне клиента; протестируйте нагрузкой количество параллельных запросов для каждого канала и добавьте экспоненциальную задержку перед повторными попытками`})]}),_jsxs(_components.tr,{children:[_jsx(_components.td,{children:_jsx(_components.strong,{children:`Все API изображений работают синхронно, не имеют идентификатора задачи и продолжают тарифицировать запрос даже после разрыва соединения`})}),_jsxs(_components.td,{children:[`Пайплайну необходима собственная очередь задач; см. `,_jsx(_components.a,{href:`/ru/api-capabilities/image-async-queue`,children:`Создание собственной асинхронной очереди`}),` и `,_jsx(_components.a,{href:`/ru/api-capabilities/image-api-best-practices`,children:`Основы API изображений`})]})]}),_jsxs(_components.tr,{children:[_jsx(_components.td,{children:_jsx(_components.strong,{children:`Нет эндпоинта для увеличения разрешения, удаления фона или восстановления лиц`})}),_jsxs(_components.td,{children:[`Задавайте размер результата во время генерации; для прозрачного фона передавайте `,_jsx(_components.code,{children:`background: \"transparent\"`}),` в `,_jsx(_components.code,{children:`gpt-image-2.5-flare`}),` / `,_jsx(_components.code,{children:`gpt-image-2.5-sunburst`}),` (это не эндпоинт для вырезания объекта — он напрямую генерирует изображение на прозрачном фоне)`]})]}),_jsxs(_components.tr,{children:[_jsx(_components.td,{children:_jsx(_components.strong,{children:`HTTP 200 без изображения обычно означает блокировку модерацией`})}),_jsxs(_components.td,{children:[`Логика выбора должна различать случаи «изображение не вернулось» и «изображение вернулось, но оказалось плохим»; в первом случае см. `,_jsx(_components.a,{href:`/ru/api-capabilities/gemini-image-error-handling`,children:`Обработка ошибок Gemini Image`})]})]}),_jsxs(_components.tr,{children:[_jsx(_components.td,{children:_jsx(_components.strong,{children:`Каждый URL возвращённого изображения является временной ссылкой`})}),_jsx(_components.td,{children:`Размещайте изображение на собственном хостинге сразу после получения; никогда не сохраняйте исходный URL в базе данных`})]}),_jsxs(_components.tr,{children:[_jsxs(_components.td,{children:[_jsx(_components.strong,{children:`Длина промптов GPT-Image ограничена 8 192 token`}),` (подтверждено измерениями; при превышении ошибки нет, весь промпт молча игнорируется; это около 11 000 китайских символов)`]}),_jsxs(_components.td,{children:[`Не вставляйте брендбуки или спецификации упаковки напрямую в модель изображений; сначала с помощью текстовой модели преобразуйте их в структурированный промпт объёмом от 1 000 до 3 000 символов, см. `,_jsx(_components.a,{href:`/ru/api-capabilities/image-long-prompt`,children:`Длинные промпты`})]})]})]})]}),`\n`,_jsx(Heading,{level:`2`,id:`6-расчёт-стоимости-когда-pipeline-оправдан`,children:`6. Расчёт стоимости: когда pipeline оправдан`}),`\n`,_jsxs(_components.p,{children:[`Pipeline обменивает деньги на вероятность успеха. На стоимость генерации изображений в основном влияет вывод (`,_jsx(_components.code,{children:`gpt-image-2`}),` тарифицирует вывод по $30 за миллион токенов), тогда как текстовые и vision-модели, используемые для переписывания и оценки, дают почти незаметные затраты. Поэтому стоимость фактически определяется тем, «сколько кандидатов вы сгенерировали».`]}),`\n`,_jsx(_components.p,{children:`Используйте три уровня вместо одной настройки для всех случаев:`}),`\n`,_jsxs(Table,{children:[_jsx(_components.thead,{children:_jsxs(_components.tr,{children:[_jsx(_components.th,{children:`Уровень`}),_jsx(_components.th,{children:`Состав`}),_jsx(_components.th,{children:`Относительная стоимость`}),_jsx(_components.th,{children:`Использование`})]})}),_jsxs(_components.tbody,{children:[_jsxs(_components.tr,{children:[_jsx(_components.td,{children:_jsx(_components.strong,{children:`Черновик`})}),_jsx(_components.td,{children:`Одиночная генерация с помощью модели Lite`}),_jsx(_components.td,{children:`1×`}),_jsx(_components.td,{children:`Внутренние предварительные просмотры, массовые заполнители, неформальные эксперименты пользователей`})]}),_jsxs(_components.tr,{children:[_jsx(_components.td,{children:_jsx(_components.strong,{children:`Стандартный`})}),_jsx(_components.td,{children:`Переписывание + 2 кандидата + выбор по результатам оценки`}),_jsx(_components.td,{children:`около 2×`}),_jsx(_components.td,{children:`Путь по умолчанию в потребительском продукте`})]}),_jsxs(_components.tr,{children:[_jsx(_components.td,{children:_jsx(_components.strong,{children:`Премиум`})}),_jsx(_components.td,{children:`Переписывание + 4 кандидата + оценка + одна локальная ретушь`}),_jsx(_components.td,{children:`около 5×`}),_jsx(_components.td,{children:`Главные изображения продукта, рекламные материалы, всё, что передаётся внешним пользователям`})]})]})]}),`\n`,_jsxs(_components.p,{children:[`Проверка проста: `,_jsx(_components.strong,{children:`увидит ли это изображение кто-либо за пределами вашей команды?`}),` Если да, стандартный или более высокий уровень окупается; если это внутренний просмотр, достаточно чернового уровня. Между ними также можно добавить промежуточное условие — генерировать больше кандидатов только тогда, когда наивысшая оценка ниже заданного порога. Это позволяет большинству запросов останавливаться на двух кандидатах.`]}),`\n`,_jsx(Heading,{level:`2`,id:`краткое-резюме`,children:`Краткое резюме`}),`\n`,_jsxs(_components.ul,{children:[`\n`,_jsxs(_components.li,{children:[`Разрыв обусловлен не весами модели, а `,_jsx(_components.strong,{children:`восемью слоями вокруг модели`}),`: переформулированием, пресетами, фиксацией композиции, сэмплированием, отбором, поэтапным редактированием, постобработкой и повторным размещением.`]}),`\n`,_jsxs(_components.li,{children:[_jsx(_components.strong,{children:`Слой переформулирования даёт наибольшую отдачу`}),`: добавьте сведения о субъекте, окружении, освещении, объективе, цветокоррекции и композиции — и «выглядит неплохо» превратится в «пригодно для использования».`]}),`\n`,_jsxs(_components.li,{children:[_jsx(_components.strong,{children:`Несколько вариантов в сочетании с оценкой vision-моделью`}),` — именно здесь на самом деле формируется высокий воспринимаемый процент успешных результатов потребительских продуктов. `,_jsx(_components.code,{children:`n`}),` не работает, поэтому распределяйте запросы на стороне клиента; `,_jsx(_components.code,{children:`/v1/rerank`}),` не может оценивать изображения.`]}),`\n`,_jsxs(_components.li,{children:[_jsx(_components.strong,{children:`Чтобы устранить ощущение, что изображение создано ИИ, добавляйте конкретику, а не прилагательные`}),`: укажите один источник света, фокусное расстояние и диафрагму, задайте тип носителя и зернистость, намеренно добавьте несовершенства и сместите субъект от центра.`]}),`\n`,_jsxs(_components.li,{children:[_jsxs(_components.strong,{children:[_jsx(_components.code,{children:`8K`}),` / `,_jsx(_components.code,{children:`masterpiece`}),` / `,_jsx(_components.code,{children:`perfect lighting`}),` дают отрицательный чистый эффект`]}),` — дополнительного разрешения они не добавляют и придают кадру вид рендера.`]}),`\n`,_jsxs(_components.li,{children:[_jsx(_components.strong,{children:`Не рассчитывайте на seed для воспроизведения результата`}),`; вместо этого архивируйте полный запрос. API изображений работают синхронно и тарифицируются при разрыве соединения, поэтому для конвейера нужна очередь.`]}),`\n`,_jsx(_components.li,{children:`У APIYI нет эндпоинтов для апскейлинга, удаления фона или обучения идентичности; с самого начала проектируйте решение с учётом этих слоёв.`}),`\n`]}),`\n`,_jsx(Heading,{level:`2`,id:`связанная-документация`,children:`Связанная документация`}),`\n`,_jsxs(CardGroup,{cols:2,children:[_jsx(Card,{title:`Как получить нужное изображение`,icon:`target`,href:`/ru/api-capabilities/image-generation-success-tips`,children:_jsx(_components.p,{children:`Спасение одного неудачного вызова: перепишите промпт, повторите попытку, смените модели, изолируйте проблему с помощью инструмента тестирования`})}),_jsx(Card,{title:`Основы Image API`,icon:`book-check`,href:`/ru/api-capabilities/image-api-best-practices`,children:_jsx(_components.p,{children:`Синхронные вызовы, уровни тайм-аутов, тарификация, обработка base64, предварительная обработка входного изображения`})}),_jsx(Card,{title:`Руководство по дорисовке с использованием маски`,icon:`scissors`,href:`/ru/api-capabilities/gpt-image-2/mask-editing`,children:_jsx(_components.p,{children:`Локальное редактирование на уровне пикселей, доступно только для gpt-image-2 через официальный релей`})}),_jsx(Card,{title:`Тестирование слияния нескольких изображений`,icon:`images`,href:`/ru/api-capabilities/multi-image-fusion-testing`,children:_jsx(_components.p,{children:`Как измерялись ограничения на количество референсов, а также результат слияния 14 изображений`})}),_jsx(Card,{title:`Распознавание изображений`,icon:`eye`,href:`/ru/api-capabilities/vision-understanding`,children:_jsx(_components.p,{children:`Модели распознавания изображений, которые можно использовать для оценки изображений-кандидатов, и способы их вызова`})}),_jsx(Card,{title:`Создание собственной асинхронной очереди`,icon:`list-checks`,href:`/ru/api-capabilities/image-async-queue`,children:_jsx(_components.p,{children:`Обёртывание синхронной генерации в очередь задач для поддержки конвейера с несколькими кандидатами`})})]})]})}function MDXContent(props={}){const{wrapper:MDXLayout}={..._provideComponents(),...props.components};return MDXLayout?_jsx(MDXLayout,{...props,children:_jsx(_createMdxContent,{...props})}):_createMdxContent(props)}return{default:MDXContent};function _missingMdxReference(id,component){throw new Error(`Expected `+(component?`component`:`object`)+\" `\"+id+\"` to be defined: you likely forgot to import, pass, or provide it.\")}","frontmatter":{},"scope":{"config":{},"pageMetadata":{"title":"Продвинутая генерация изображений: рабочий процесс и реалистичность","sidebarTitle":"Продвинутый рабочий процесс","description":"Та же модель, но лучший результат: что пользовательские приложения для работы с изображениями добавляют поверх API — слой переформулирования промпта, фиксацию референса, параллельную выборку с выбором vision-модели и пошаговую ретушь. Включает готовую для копирования и вставки лексику для описания реалистичности, сравнительные тесты и расчёт стоимости.","icon":"workflow","href":"/ru/api-capabilities/image-advanced-workflow"}}},"mdxSourceWithNoJs":null},"mdxExtracts":{"tableOfContents":[{"title":"1. Что представляют собой потребительские продукты для работы с изображениями поверх модели","slug":"1-что-представляют-собой-потребительские-продукты-для-работы-с-изображениями-поверх-модели","depth":2,"children":[]},{"title":"2. Первый слой уже разделяет результаты: превратите неформальный ввод в структуру","slug":"2-первый-слой-уже-разделяет-результаты-превратите-неформальный-ввод-в-структуру","depth":2,"children":[{"title":"Сравнительный тест: одна модель, один бриф, два промпта","slug":"сравнительный-тест-одна-модель-один-бриф-два-промпта","depth":3,"children":[]},{"title":"Шесть элементов, которые должен добавить слой переформулирования","slug":"шесть-элементов-которые-должен-добавить-слой-переформулирования","depth":3,"children":[]},{"title":"Слой переформулирования в коде","slug":"слой-переформулирования-в-коде","depth":3,"children":[]}]},{"title":"3. Конвейер, который действительно можно внедрить","slug":"3-конвейер-который-действительно-можно-внедрить","depth":2,"children":[{"title":"Минимальная сквозная реализация","slug":"минимальная-сквозная-реализация","depth":3,"children":[]}]},{"title":"4. Устранение визуальных признаков ИИ","slug":"4-устранение-визуальных-признаков-ии","depth":2,"children":[{"title":"Сравнительный тест","slug":"сравнительный-тест","depth":3,"children":[]},{"title":"Симптом, исправление и чего не следует писать","slug":"симптом-исправление-и-чего-не-следует-писать","depth":3,"children":[]},{"title":"Четыре блока управляющих формулировок для копирования и вставки","slug":"четыре-блока-управляющих-формулировок-для-копирования-и-вставки","depth":3,"children":[]},{"title":"Три полных примера","slug":"три-полных-примера","depth":3,"children":[]}]},{"title":"5. Факты, которые изменят проектирование вашего пайплайна","slug":"5-факты-которые-изменят-проектирование-вашего-пайплайна","depth":2,"children":[]},{"title":"6. Расчёт стоимости: когда pipeline оправдан","slug":"6-расчёт-стоимости-когда-pipeline-оправдан","depth":2,"children":[]},{"title":"Краткое резюме","slug":"краткое-резюме","depth":2,"children":[]},{"title":"Связанная документация","slug":"связанная-документация","depth":2,"children":[]}],"codeExamples":{}},"jsLinks":[],"subdomain":"apiyillc","siteName":"API易文档中心","title":"Продвинутая генерация изображений: рабочий процесс и реалистичность - API易文档中心","navMaps":{"firstHrefInVersion":{},"firstHrefInLanguage":{"zh":{"href":"/api-capabilities/image-advanced-workflow","matchLevel":1},"en":{"href":"/en/api-capabilities/image-advanced-workflow","matchLevel":1},"zh-Hant":{"href":"/zh-Hant/api-capabilities/image-advanced-workflow","matchLevel":1},"ja":{"href":"/ja/api-capabilities/image-advanced-workflow","matchLevel":1},"ko":{"href":"/ko/api-capabilities/image-advanced-workflow","matchLevel":1},"ru":{"href":"/ru/api-capabilities/image-advanced-workflow","matchLevel":0}}},"lastModified":"2026-11-09T08:49:11.586Z","originalFileLocation":"ru/api-capabilities/image-advanced-workflow.mdx","locale":"ru"},"headHtml":"\u003cscript data-mint-head>(function(){var d=document.documentElement,p=null;if(!p){try{p=localStorage.getItem(\"isDarkMode\")}catch(e){}if(p==='true')p='dark';else if(p==='false')p='light';if(p!=='light'\u0026\u0026p!=='dark'\u0026\u0026p!=='system')p=\"system\"}var r=p==='system'?(matchMedia(\"(prefers-color-scheme: dark)\").matches?'dark':'light'):p;d.classList.remove(r==='dark'?'light':'dark');d.classList.add(r);d.setAttribute(\"data-theme-preference\",p)})();\u003c/script>\u003cmeta data-mint-head name=\"description\" content=\"Та же модель, но лучший результат: что пользовательские приложения для работы с изображениями добавляют поверх API — слой переформулирования промпта, фиксацию референса, параллельную выборку с выбором vision-модели и пошаговую ретушь. Включает готовую для копирования и вставки лексику для описания реалистичности, сравнительные тесты и расчёт стоимости.\">\u003cmeta data-mint-head name=\"application-name\" content=\"API易文档中心\">\u003cmeta data-mint-head name=\"generator\" content=\"Mintlify\">\u003clink data-mint-head rel=\"icon\" type=\"image/png\" sizes=\"192x192\" href=\"/mintlify-assets/_mintlify/favicons/apiyillc/sQlsuRwD6o27XLvg/_generated/favicon/android-chrome-192x192.png\" media=\"(prefers-color-scheme: light)\">\u003clink data-mint-head rel=\"apple-touch-icon\" type=\"image/png\" sizes=\"180x180\" href=\"/mintlify-assets/_mintlify/favicons/apiyillc/sQlsuRwD6o27XLvg/_generated/favicon/apple-touch-icon.png\">\u003clink data-mint-head rel=\"icon\" type=\"image/png\" sizes=\"16x16\" href=\"/mintlify-assets/_mintlify/favicons/apiyillc/sQlsuRwD6o27XLvg/_generated/favicon/favicon-16x16.png\" media=\"(prefers-color-scheme: light)\">\u003clink data-mint-head rel=\"icon\" type=\"image/png\" sizes=\"32x32\" href=\"/mintlify-assets/_mintlify/favicons/apiyillc/sQlsuRwD6o27XLvg/_generated/favicon/favicon-32x32.png\" media=\"(prefers-color-scheme: light)\">\u003clink data-mint-head rel=\"shortcut icon\" type=\"image/x-icon\" href=\"/mintlify-assets/_mintlify/favicons/apiyillc/sQlsuRwD6o27XLvg/_generated/favicon/favicon.ico\" media=\"(prefers-color-scheme: light)\">\u003clink data-mint-head rel=\"icon\" type=\"image/png\" sizes=\"192x192\" href=\"/mintlify-assets/_mintlify/favicons/apiyillc/sQlsuRwD6o27XLvg/_generated/favicon-dark/android-chrome-192x192.png\" media=\"(prefers-color-scheme: dark)\">\u003clink data-mint-head rel=\"icon\" type=\"image/png\" sizes=\"16x16\" href=\"/mintlify-assets/_mintlify/favicons/apiyillc/sQlsuRwD6o27XLvg/_generated/favicon-dark/favicon-16x16.png\" media=\"(prefers-color-scheme: dark)\">\u003clink data-mint-head rel=\"icon\" type=\"image/png\" sizes=\"32x32\" href=\"/mintlify-assets/_mintlify/favicons/apiyillc/sQlsuRwD6o27XLvg/_generated/favicon-dark/favicon-32x32.png\" media=\"(prefers-color-scheme: dark)\">\u003clink data-mint-head rel=\"shortcut icon\" type=\"image/x-icon\" href=\"/mintlify-assets/_mintlify/favicons/apiyillc/sQlsuRwD6o27XLvg/_generated/favicon-dark/favicon.ico\" media=\"(prefers-color-scheme: dark)\">\u003cmeta data-mint-head property=\"og:title\" content=\"Продвинутая генерация изображений: рабочий процесс и реалистичность - API易文档中心\">\u003cmeta data-mint-head property=\"og:description\" content=\"Та же модель, но лучший результат: что пользовательские приложения для работы с изображениями добавляют поверх API — слой переформулирования промпта, фиксацию референса, параллельную выборку с выбором vision-модели и пошаговую ретушь. Включает готовую для копирования и вставки лексику для описания реалистичности, сравнительные тесты и расчёт стоимости.\">\u003cmeta data-mint-head property=\"og:site_name\" content=\"API易文档中心\">\u003cmeta data-mint-head property=\"og:url\" content=\"https://docs.apiyi.com/ru/api-capabilities/image-advanced-workflow\">\u003cmeta data-mint-head property=\"og:type\" content=\"website\">\u003cmeta data-mint-head property=\"og:image\" content=\"https://apiyillc.mintlify.site/_mintlify/api/og/v2?division=%D0%9E%D1%81%D0%BD%D0%BE%D0%B2%D1%8B+Image+API\u0026amp;title=%D0%9F%D1%80%D0%BE%D0%B4%D0%B2%D0%B8%D0%BD%D1%83%D1%82%D0%B0%D1%8F+%D0%B3%D0%B5%D0%BD%D0%B5%D1%80%D0%B0%D1%86%D0%B8%D1%8F+%D0%B8%D0%B7%D0%BE%D0%B1%D1%80%D0%B0%D0%B6%D0%B5%D0%BD%D0%B8%D0%B9%3A+%D1%80%D0%B0%D0%B1%D0%BE%D1%87%D0%B8%D0%B9+%D0%BF%D1%80%D0%BE%D1%86%D0%B5%D1%81%D1%81+%D0%B8+%D1%80%D0%B5%D0%B0%D0%BB%D0%B8%D1%81%D1%82%D0%B8%D1%87%D0%BD%D0%BE%D1%81%D1%82%D1%8C\u0026amp;description=%D0%A2%D0%B0+%D0%B6%D0%B5+%D0%BC%D0%BE%D0%B4%D0%B5%D0%BB%D1%8C%2C+%D0%BD%D0%BE+%D0%BB%D1%83%D1%87%D1%88%D0%B8%D0%B9+%D1%80%D0%B5%D0%B7%D1%83%D0%BB%D1%8C%D1%82%D0%B0%D1%82%3A+%D1%87%D1%82%D0%BE+%D0%BF%D0%BE%D0%BB%D1%8C%D0%B7%D0%BE%D0%B2%D0%B0%D1%82%D0%B5%D0%BB%D1%8C%D1%81%D0%BA%D0%B8%D0%B5+%D0%BF%D1%80%D0%B8%D0%BB%D0%BE%D0%B6%D0%B5%D0%BD%D0%B8%D1%8F+%D0%B4%D0%BB%D1%8F+%D1%80%D0%B0%D0%B1%D0%BE%D1%82%D1%8B+%D1%81+%D0%B8%D0%B7%D0%BE%D0%B1%D1%80%D0%B0%D0%B6%D0%B5%D0%BD%D0%B8%D1%8F%D0%BC%D0%B8+%D0%B4%D0%BE%D0%B1%D0%B0%D0%B2%D0%BB%D1%8F%D1%8E%D1%82+%D0%BF%D0%BE%D0%B2%D0%B5%D1%80%D1%85+API+%E2%80%94+%D1%81%D0%BB%D0%BE%D0%B9+%D0%BF%D0%B5%D1%80%D0%B5%D1%84%D0%BE%D1%80%D0%BC%D1%83%D0%BB%D0%B8%D1%80%D0%BE%D0%B2%D0%B0%D0%BD%D0%B8%D1%8F+%D0%BF%D1%80%D0%BE%D0%BC%D0%BF%D1%82%D0%B0%2C+%D1%84%D0%B8%D0%BA%D1%81%D0%B0%D1%86%D0%B8%D1%8E+%D1%80\u0026amp;theme=84509e4a5d1cb12fd162de92\u0026amp;signature=2bdf67ad30634c56227c9eae42af727c2f6b9f0994d18473d35da7399e07e5fa\">\u003cmeta data-mint-head property=\"og:image:width\" content=\"1200\">\u003cmeta data-mint-head property=\"og:image:height\" content=\"630\">\u003cmeta data-mint-head name=\"twitter:card\" content=\"summary_large_image\">\u003cmeta data-mint-head name=\"twitter:title\" content=\"Продвинутая генерация изображений: рабочий процесс и реалистичность - API易文档中心\">\u003cmeta data-mint-head name=\"twitter:description\" content=\"Та же модель, но лучший результат: что пользовательские приложения для работы с изображениями добавляют поверх API — слой переформулирования промпта, фиксацию референса, параллельную выборку с выбором vision-модели и пошаговую ретушь. Включает готовую для копирования и вставки лексику для описания реалистичности, сравнительные тесты и расчёт стоимости.\">\u003cmeta data-mint-head name=\"twitter:image\" content=\"https://apiyillc.mintlify.site/_mintlify/api/og/v2?division=%D0%9E%D1%81%D0%BD%D0%BE%D0%B2%D1%8B+Image+API\u0026amp;title=%D0%9F%D1%80%D0%BE%D0%B4%D0%B2%D0%B8%D0%BD%D1%83%D1%82%D0%B0%D1%8F+%D0%B3%D0%B5%D0%BD%D0%B5%D1%80%D0%B0%D1%86%D0%B8%D1%8F+%D0%B8%D0%B7%D0%BE%D0%B1%D1%80%D0%B0%D0%B6%D0%B5%D0%BD%D0%B8%D0%B9%3A+%D1%80%D0%B0%D0%B1%D0%BE%D1%87%D0%B8%D0%B9+%D0%BF%D1%80%D0%BE%D1%86%D0%B5%D1%81%D1%81+%D0%B8+%D1%80%D0%B5%D0%B0%D0%BB%D0%B8%D1%81%D1%82%D0%B8%D1%87%D0%BD%D0%BE%D1%81%D1%82%D1%8C\u0026amp;description=%D0%A2%D0%B0+%D0%B6%D0%B5+%D0%BC%D0%BE%D0%B4%D0%B5%D0%BB%D1%8C%2C+%D0%BD%D0%BE+%D0%BB%D1%83%D1%87%D1%88%D0%B8%D0%B9+%D1%80%D0%B5%D0%B7%D1%83%D0%BB%D1%8C%D1%82%D0%B0%D1%82%3A+%D1%87%D1%82%D0%BE+%D0%BF%D0%BE%D0%BB%D1%8C%D0%B7%D0%BE%D0%B2%D0%B0%D1%82%D0%B5%D0%BB%D1%8C%D1%81%D0%BA%D0%B8%D0%B5+%D0%BF%D1%80%D0%B8%D0%BB%D0%BE%D0%B6%D0%B5%D0%BD%D0%B8%D1%8F+%D0%B4%D0%BB%D1%8F+%D1%80%D0%B0%D0%B1%D0%BE%D1%82%D1%8B+%D1%81+%D0%B8%D0%B7%D0%BE%D0%B1%D1%80%D0%B0%D0%B6%D0%B5%D0%BD%D0%B8%D1%8F%D0%BC%D0%B8+%D0%B4%D0%BE%D0%B1%D0%B0%D0%B2%D0%BB%D1%8F%D1%8E%D1%82+%D0%BF%D0%BE%D0%B2%D0%B5%D1%80%D1%85+API+%E2%80%94+%D1%81%D0%BB%D0%BE%D0%B9+%D0%BF%D0%B5%D1%80%D0%B5%D1%84%D0%BE%D1%80%D0%BC%D1%83%D0%BB%D0%B8%D1%80%D0%BE%D0%B2%D0%B0%D0%BD%D0%B8%D1%8F+%D0%BF%D1%80%D0%BE%D0%BC%D0%BF%D1%82%D0%B0%2C+%D1%84%D0%B8%D0%BA%D1%81%D0%B0%D1%86%D0%B8%D1%8E+%D1%80\u0026amp;theme=84509e4a5d1cb12fd162de92\u0026amp;signature=2bdf67ad30634c56227c9eae42af727c2f6b9f0994d18473d35da7399e07e5fa\">\u003cmeta data-mint-head name=\"twitter:image:width\" content=\"1200\">\u003cmeta data-mint-head name=\"twitter:image:height\" content=\"630\">\u003cmeta data-mint-head name=\"msapplication-config\" content=\"/mintlify-assets/_mintlify/favicons/apiyillc/sQlsuRwD6o27XLvg/_generated/favicon/browserconfig.xml\">\u003cmeta data-mint-head name=\"apple-mobile-web-app-title\" content=\"API易文档中心\">\u003cmeta data-mint-head name=\"msapplication-TileColor\" content=\"#2563eb\">\u003clink data-mint-head rel=\"canonical\" href=\"https://docs.apiyi.com/ru/api-capabilities/image-advanced-workflow\">\u003clink data-mint-head rel=\"alternate\" type=\"application/xml\" href=\"/sitemap.xml\">\u003clink data-mint-head rel=\"alternate\" type=\"text/markdown\" href=\"/ru/api-capabilities/image-advanced-workflow.md\">\u003clink data-mint-head rel=\"alternate\" hreflang=\"ru\" href=\"https://docs.apiyi.com/ru/api-capabilities/image-advanced-workflow\">\u003clink data-mint-head rel=\"alternate\" hreflang=\"zh\" href=\"https://docs.apiyi.com/api-capabilities/image-advanced-workflow\">\u003clink data-mint-head rel=\"alternate\" hreflang=\"en\" href=\"https://docs.apiyi.com/en/api-capabilities/image-advanced-workflow\">\u003clink data-mint-head rel=\"alternate\" hreflang=\"zh-Hant\" href=\"https://docs.apiyi.com/zh-Hant/api-capabilities/image-advanced-workflow\">\u003clink data-mint-head rel=\"alternate\" hreflang=\"ja\" href=\"https://docs.apiyi.com/ja/api-capabilities/image-advanced-workflow\">\u003clink data-mint-head rel=\"alternate\" hreflang=\"ko\" href=\"https://docs.apiyi.com/ko/api-capabilities/image-advanced-workflow\">\u003clink data-mint-head rel=\"alternate\" hreflang=\"x-default\" href=\"https://docs.apiyi.com/api-capabilities/image-advanced-workflow\">\u003cscript data-mint-head type=\"application/ld+json\">{\"@context\":\"https://schema.org\",\"@graph\":[{\"@type\":\"Organization\",\"@id\":\"https://docs.apiyi.com/#organization\",\"name\":\"API易文档中心\",\"url\":\"https://docs.apiyi.com\",\"logo\":{\"@type\":\"ImageObject\",\"url\":\"https://mintcdn.com/apiyillc/LjCT1O0GrSur6F2v/logo/light.svg?fit=max\u0026auto=format\u0026n=LjCT1O0GrSur6F2v\u0026q=85\u0026s=4119ef17a74cc54be127f34578d8b5fa\"}},{\"@type\":\"WebSite\",\"@id\":\"https://docs.apiyi.com#website\",\"name\":\"API易文档中心\",\"url\":\"https://docs.apiyi.com\",\"publisher\":{\"@id\":\"https://docs.apiyi.com/#organization\"}},{\"@type\":\"WebPage\",\"@id\":\"https://docs.apiyi.com/ru/api-capabilities/image-advanced-workflow#webpage\",\"url\":\"https://docs.apiyi.com/ru/api-capabilities/image-advanced-workflow\",\"name\":\"Продвинутая генерация изображений: рабочий процесс и реалистичность\",\"description\":\"Та же модель, но лучший результат: что пользовательские приложения для работы с изображениями добавляют поверх API — слой переформулирования промпта, фиксацию референса, параллельную выборку с выбором vision-модели и пошаговую ретушь. Включает готовую для копирования и вставки лексику для описания реалистичности, сравнительные тесты и расчёт стоимости.\",\"dateModified\":\"2026-11-09T08:49:11.586Z\",\"isPartOf\":{\"@id\":\"https://docs.apiyi.com#website\"},\"breadcrumb\":{\"@id\":\"https://docs.apiyi.com/ru/api-capabilities/image-advanced-workflow#breadcrumb\"}},{\"@type\":\"BreadcrumbList\",\"@id\":\"https://docs.apiyi.com/ru/api-capabilities/image-advanced-workflow#breadcrumb\",\"itemListElement\":[{\"@type\":\"ListItem\",\"position\":1,\"name\":\"Image API (официальный)\",\"item\":\"https://docs.apiyi.com/ru/api-capabilities/image-api-best-practices\"},{\"@type\":\"ListItem\",\"position\":2,\"name\":\"Основы Image API\",\"item\":\"https://docs.apiyi.com/ru/api-capabilities/image-api-best-practices\"},{\"@type\":\"ListItem\",\"position\":3,\"name\":\"Продвинутая генерация изображений: рабочий процесс и реалистичность\",\"item\":\"https://docs.apiyi.com/ru/api-capabilities/image-advanced-workflow\"}]},{\"@type\":[\"Article\",\"TechArticle\"],\"@id\":\"https://docs.apiyi.com/ru/api-capabilities/image-advanced-workflow#article\",\"headline\":\"Продвинутая генерация изображений: рабочий процесс и реалистичность\",\"name\":\"Продвинутая генерация изображений: рабочий процесс и реалистичность\",\"description\":\"Та же модель, но лучший результат: что пользовательские приложения для работы с изображениями добавляют поверх API — слой переформулирования промпта, фиксацию референса, параллельную выборку с выбором vision-модели и пошаговую ретушь. Включает готовую для копирования и вставки лексику для описания реалистичности, сравнительные тесты и расчёт стоимости.\",\"url\":\"https://docs.apiyi.com/ru/api-capabilities/image-advanced-workflow\",\"mainEntityOfPage\":{\"@id\":\"https://docs.apiyi.com/ru/api-capabilities/image-advanced-workflow#webpage\"},\"dateModified\":\"2026-11-09T08:49:11.586Z\",\"publisher\":{\"@id\":\"https://docs.apiyi.com/#organization\"},\"isPartOf\":{\"@id\":\"https://docs.apiyi.com#website\"}}]}\u003c/script>\u003cscript data-mint-head type=\"application/ld+json\">{\"@context\":\"https://schema.org\",\"@type\":\"WebSite\",\"name\":\"API易文档中心\",\"publisher\":{\"@type\":\"Organization\",\"name\":\"API易文档中心\"},\"provider\":{\"@type\":\"Organization\",\"name\":\"Mintlify\",\"url\":\"https://mintlify.com\"}}\u003c/script>","agentPointerHref":"/ru/api-capabilities/image-advanced-workflow.md","siteName":"API易文档中心","nav":{"global":{"anchors":[]},"languages":[{"language":"zh","pages":[{"title":"zh","href":"/api-capabilities/image-advanced-workflow"}]},{"language":"en","navbar":{"links":[{"href":"https://api.apiyi.com","label":"Home"},{"href":"https://imagen.apiyi.com","label":"AI Image"},{"href":"https://icover.ai","label":"AI Video"}],"primary":{"type":"button","label":"Console","href":"https://api.apiyi.com/account/profile"}},"pages":[{"title":"en","href":"/en/api-capabilities/image-advanced-workflow"}]},{"language":"zh-Hant","banner":{"content":"本頁由程式自動轉換為繁體中文,用詞以台灣正體為準;如有歧義請以[簡體中文版](/)為準。","dismissible":true},"footer":{"socials":{"website":"https://api.apiyi.com"},"links":[{"header":"AI 整合","items":[{"label":"skill.md","href":"https://docs.apiyi.com/skill.md"},{"label":"llms.txt","href":"https://docs.apiyi.com/llms.txt"},{"label":"llms-full.txt","href":"https://docs.apiyi.com/llms-full.txt"},{"label":"model-registry.json","href":"https://docs.apiyi.com/model-registry.json"},{"label":"AI 開發者套件(中文)","href":"/developer-kit"},{"label":"AI Developer Kit (EN)","href":"/en/developer-kit"}]},{"header":"使用者口碑 / Wall of Love","items":[{"label":"使用者口碑(中文)","href":"/wall-of-love"},{"label":"Wall of Love (EN)","href":"/en/wall-of-love"}]}]},"navbar":{"links":[{"href":"https://api.apiyi.com","label":"首頁"},{"href":"https://imagen.apiyi.com","label":"AI出圖"},{"href":"https://icover.ai","label":"AI影片"}],"primary":{"type":"button","label":"控制台","href":"https://api.apiyi.com/account/profile"}},"pages":[{"title":"zh-Hant","href":"/zh-Hant/api-capabilities/image-advanced-workflow"}]},{"language":"ja","banner":{"content":"このページは AI により翻訳されています。内容に相違がある場合は[English 版](/en)を正としてください。","dismissible":true},"footer":{"socials":{"website":"https://api.apiyi.com"},"links":[{"header":"AI統合","items":[{"label":"skill.md","href":"https://docs.apiyi.com/skill.md"},{"label":"llms.txt","href":"https://docs.apiyi.com/llms.txt"},{"label":"llms-full.txt","href":"https://docs.apiyi.com/llms-full.txt"},{"label":"model-registry.json","href":"https://docs.apiyi.com/model-registry.json"},{"label":"AI開発者キット(中国語)","href":"/developer-kit"},{"label":"AI Developer Kit (EN)","href":"/en/developer-kit"}]},{"header":"ユーザーの声 / Wall of Love","items":[{"label":"ユーザーの声(中国語)","href":"/wall-of-love"},{"label":"Wall of Love(英語)","href":"/en/wall-of-love"}]}]},"navbar":{"links":[{"href":"https://api.apiyi.com","label":"ホーム"},{"href":"https://imagen.apiyi.com","label":"AI画像生成"},{"href":"https://icover.ai","label":"AI動画生成"}],"primary":{"type":"button","label":"コンソール","href":"https://api.apiyi.com/account/profile"}},"pages":[{"title":"ja","href":"/ja/api-capabilities/image-advanced-workflow"}]},{"language":"ko","banner":{"content":"이 페이지는 AI로 번역되었습니다. 내용이 다를 경우 [English 버전](/en)을 기준으로 하십시오.","dismissible":true},"footer":{"socials":{"website":"https://api.apiyi.com"},"links":[{"header":"AI 통합","items":[{"label":"skill.md","href":"https://docs.apiyi.com/skill.md"},{"label":"llms.txt","href":"https://docs.apiyi.com/llms.txt"},{"label":"llms-full.txt","href":"https://docs.apiyi.com/llms-full.txt"},{"label":"model-registry.json","href":"https://docs.apiyi.com/model-registry.json"},{"label":"AI 개발자 키트(중국어)","href":"/developer-kit"},{"label":"AI Developer Kit (EN)","href":"/en/developer-kit"}]},{"header":"사용자 후기 / Wall of Love","items":[{"label":"사용자 후기(중국어)","href":"/wall-of-love"},{"label":"Wall of Love (영문)","href":"/en/wall-of-love"}]}]},"navbar":{"links":[{"href":"https://api.apiyi.com","label":"홈"},{"href":"https://imagen.apiyi.com","label":"AI 이미지 생성"},{"href":"https://icover.ai","label":"AI 동영상 생성"}],"primary":{"type":"button","label":"콘솔","href":"https://api.apiyi.com/account/profile"}},"pages":[{"title":"ko","href":"/ko/api-capabilities/image-advanced-workflow"}]},{"language":"ru","banner":{"content":"Эта страница переведена с помощью ИИ. При расхождениях ориентируйтесь на [английскую версию](/en).","dismissible":true},"footer":{"socials":{"website":"https://api.apiyi.com"},"links":[{"header":"AI-интеграция","items":[{"label":"skill.md","href":"https://docs.apiyi.com/skill.md"},{"label":"llms.txt","href":"https://docs.apiyi.com/llms.txt"},{"label":"llms-full.txt","href":"https://docs.apiyi.com/llms-full.txt"},{"label":"model-registry.json","href":"https://docs.apiyi.com/model-registry.json"},{"label":"Набор AI-разработчика (кит.)","href":"/developer-kit"},{"label":"AI Developer Kit (EN)","href":"/en/developer-kit"}]},{"header":"Отзывы пользователей / Wall of Love","items":[{"label":"Отзывы пользователей (на китайском)","href":"/wall-of-love"},{"label":"Wall of Love (EN)","href":"/en/wall-of-love"}]}]},"navbar":{"links":[{"href":"https://api.apiyi.com","label":"Главная"},{"href":"https://imagen.apiyi.com","label":"Генерация изображений"},{"href":"https://icover.ai","label":"Генерация видео"}],"primary":{"type":"button","label":"Консоль","href":"https://api.apiyi.com/account/profile"}},"tabs":[{"tab":"Главная","icon":"house","groups":[{"group":"Основы","pages":[{"title":"APIYI — центр API для моделей ИИ","sidebarTitle":"Введение","icon":"house","href":"/ru"},{"title":"Быстрый старт","icon":"rocket","href":"/ru/getting-started"},{"group":"Набор инструментов разработчика ИИ","icon":"terminal","pages":[{"title":"Набор инструментов для разработчиков ИИ","sidebarTitle":"Набор инструментов для разработчиков ИИ","icon":"bot","href":"/ru/developer-kit"},{"title":"Почему терминал сообщает, что команда apiyi не найдена?","icon":"terminal","href":"/ru/faq/apiyi-cli-command-not-found"}]},{"group":"Руководство по API","icon":"book","pages":[{"title":"Руководство по API","sidebarTitle":"Обзор руководства","icon":"book","href":"/ru/api-manual"},{"title":"Захват деталей ошибок API","sidebarTitle":"Захват ошибок","icon":"clipboard-list","href":"/ru/api-manual/error-reporting"},{"group":"Подключение API: частые вопросы","icon":"circle-question-mark","expanded":false,"pages":[{"title":"Поддерживает ли APIYI API файлов?","icon":"file-up","href":"/ru/faq/files-api-not-supported"},{"title":"Как настроить Base URL? Различия между /v1, корневым доменом и /v1beta","icon":"link","href":"/ru/faq/base-url-config"},{"title":"Как устранить ошибки API модели?","icon":"alert-triangle","href":"/ru/faq/model-error-troubleshooting"},{"title":"Каковы лимиты параллельных запросов API?","icon":"gauge","href":"/ru/faq/api-concurrency"}]}]},{"title":"Тарифы","icon":"badge-dollar-sign","href":"/ru/pricing"}]},{"group":"Базовый API","icon":"box","pages":[{"group":"Популярные модели","icon":"cpu","root":{"title":"Рекомендации популярных моделей — APIYI, всегда актуальная информация","sidebarTitle":"Популярные модели","icon":"database","href":"/ru/api-capabilities/model-info"},"pages":[{"group":"Модели: частые вопросы","icon":"circle-question-mark","expanded":false,"pages":[{"title":"Как выбрать подходящую модель ИИ?","icon":"compass","href":"/ru/faq/model-selection-guide"},{"title":"Почему официальные веб-приложения и API дают разные результаты?","icon":"layers","href":"/ru/faq/webapp-vs-api-difference"},{"title":"Почему модели ИИ не знают свою собственную версию?","icon":"circle-question-mark","href":"/ru/faq/model-version-identity"}]}]},{"title":"Модели генерации изображений и видео","icon":"palette","href":"/ru/api-capabilities/image-video-models"},{"group":"Вызовы OpenAI API","icon":"sparkles","pages":[{"title":"Руководство по нативному OpenAI Responses API","sidebarTitle":"Нативные вызовы","icon":"zap","href":"/ru/api-capabilities/openai/native"},{"title":"Режим совместимости OpenAI Chat Completions","sidebarTitle":"Совместимый режим","icon":"plug","href":"/ru/api-capabilities/openai/compatible"},{"title":"Выбор эндпоинта: миграция GPT-5.4+ на Responses","sidebarTitle":"Эндпоинт и миграция","icon":"route","href":"/ru/api-capabilities/openai/responses-migration"},{"title":"Режим совместимости OpenAI: обработка ответов","sidebarTitle":"Обработка ответов","icon":"braces","href":"/ru/api-capabilities/openai/response-handling"},{"title":"OpenAI Compatible Mode: Вывод модели рассуждений","sidebarTitle":"Вывод модели рассуждений","icon":"brain","href":"/ru/api-capabilities/openai/reasoning-models"},{"title":"Руководство по тарификации Prompt Caching OpenAI","sidebarTitle":"Тарификация кэша","icon":"database","href":"/ru/api-capabilities/openai/prompt-caching"},{"title":"Руководство по Function Calling OpenAI","sidebarTitle":"Function Calling","icon":"wrench","href":"/ru/api-capabilities/openai/function-calling"},{"title":"Руководство по веб-поиску в OpenAI API","sidebarTitle":"Веб-поиск","icon":"globe","href":"/ru/api-capabilities/openai/web-search"},{"group":"OpenAI: частые вопросы","icon":"circle-question-mark","pages":[{"title":"Поддерживает ли APIYI быстрый / сверхбыстрый режим OpenAI?","icon":"gauge","href":"/ru/faq/openai-service-tier-fast-mode"},{"title":"Чем отличаются запросы с потоковой передачей и без неё при фильтрации контента?","sidebarTitle":"Потоковая передача и фильтрация контента","icon":"shield-half","href":"/ru/faq/streaming-content-filter"},{"title":"Как выглядит отказ модели OpenAI?","icon":"message-square-x","href":"/ru/faq/openai-content-safety-refusal"}]}]},{"group":"Официальный Claude","icon":"sparkles","pages":[{"title":"Основы вызовов API Claude","sidebarTitle":"Основы API Claude","icon":"sparkles","href":"/ru/api-capabilities/claude"},{"title":"Нативный формат Claude: потоковая передача и ответы без потоковой передачи","sidebarTitle":"Потоковая передача и ответы","icon":"braces","href":"/ru/api-capabilities/claude-response-handling"},{"title":"Руководство Claude по кэшированию промптов","sidebarTitle":"Кэширование промптов","icon":"database","href":"/ru/api-capabilities/claude-prompt-caching"},{"title":"Руководство по усилиям и рассуждению Claude","sidebarTitle":"Руководство по рассуждению Claude","icon":"gauge","href":"/ru/api-capabilities/claude-effort-thinking"},{"title":"Руководство по веб-поиску Claude API","sidebarTitle":"Веб-поиск Claude","icon":"globe","href":"/ru/api-capabilities/claude-web-search"},{"group":"Claude: частые вопросы","icon":"circle-question-mark","pages":[{"title":"Почему Claude утверждает, что он Qwen или DeepSeek?","icon":"venetian-mask","href":"/ru/faq/claude-identity-confusion"},{"title":"Как исправить ошибку недействительной подписи thinking в Claude?","icon":"file-signature","href":"/ru/faq/claude-thinking-signature-invalid"},{"title":"Почему при отказе Claude возвращается пустое содержимое?","icon":"message-square-x","href":"/ru/faq/claude-content-safety-refusal"}]}]},{"group":"Нативные вызовы Gemini","icon":"sparkles","pages":[{"title":"Руководство по нативному формату Gemini","sidebarTitle":"Нативные вызовы","icon":"zap","href":"/ru/api-capabilities/gemini/native"},{"title":"Interactions API против generateContent","sidebarTitle":"Сравнение Interactions API","icon":"git-compare","href":"/ru/api-capabilities/gemini/interactions-api"},{"title":"Нативный формат Gemini: потоковые и непотоковые ответы","sidebarTitle":"Потоковая передача и ответы","icon":"braces","href":"/ru/api-capabilities/gemini/response-handling"},{"title":"Мультимодальный ввод и выполнение кода в Gemini","sidebarTitle":"Мультимодальность и выполнение кода","icon":"images","href":"/ru/api-capabilities/gemini/multimodal"},{"title":"Руководство по тарификации неявного кэширования Gemini","sidebarTitle":"Тарификация кэша","icon":"database","href":"/ru/api-capabilities/gemini/prompt-caching"},{"title":"Руководство по вызову функций Gemini","sidebarTitle":"Вызов функций","icon":"wrench","href":"/ru/api-capabilities/gemini/function-calling"},{"title":"Руководство по веб-поиску для Gemini API","sidebarTitle":"Веб-поиск","icon":"globe","href":"/ru/api-capabilities/gemini/web-search"},{"title":"Как исправить ошибки 400 (Thought Signature) в Gemini при вызовах инструментов?","icon":"file-signature","href":"/ru/faq/gemini-thought-signature-missing"}]},{"group":"Вызовы API Grok","icon":"sparkles","pages":[{"title":"Руководство по серии моделей Grok","sidebarTitle":"Обзор Grok","icon":"rocket","href":"/ru/api-capabilities/grok/overview"},{"title":"Руководство по Grok Chat и рассуждению","sidebarTitle":"Чат и рассуждение","icon":"message-square","href":"/ru/api-capabilities/grok/chat"},{"title":"Руководство по Web Search и X Search в Grok","sidebarTitle":"Web и X Search","icon":"globe","href":"/ru/api-capabilities/grok/web-search"},{"title":"Выполнение кода и руководство по Remote MCP для Grok","sidebarTitle":"Выполнение кода и MCP","icon":"terminal","href":"/ru/api-capabilities/grok/code-execution-mcp"},{"title":"Руководство по модели Grok Multi-Agent","sidebarTitle":"Мультиагентная модель","icon":"users","href":"/ru/api-capabilities/grok/multi-agent"},{"title":"Руководство по тарификации кэширования Grok","sidebarTitle":"Тарификация кэша","icon":"database","href":"/ru/api-capabilities/grok/prompt-caching"}]},{"group":"Лучшие практики текстового API","icon":"book-check","pages":[{"title":"Практики работы с длинными ответами","sidebarTitle":"Длинные ответы","icon":"book-check","href":"/ru/api-capabilities/long-form-output-practices"},{"title":"Руководство по многотуровому диалогу","sidebarTitle":"Многотуровый диалог","icon":"messages-square","href":"/ru/api-capabilities/multi-turn-conversation"},{"group":"Текст: частые вопросы","icon":"circle-question-mark","expanded":false,"pages":[{"title":"Почему модель с рассуждением возвращает пустой контент?","icon":"alert-circle","href":"/ru/faq/reasoning-model-empty-response"},{"title":"В чём разница между вызовами с потоковой передачей и без потоковой передачи?","sidebarTitle":"Потоковая передача vs без потоковой передачи","icon":"audio-lines","href":"/ru/faq/streaming-vs-non-streaming"},{"title":"Что такое max_tokens? Что произойдет, если не задавать?","icon":"sliders-horizontal","href":"/ru/faq/max-tokens"},{"title":"Есть ли у API память, как у ChatGPT?","icon":"brain","href":"/ru/faq/api-memory"}]}]},{"title":"API запроса баланса","icon":"wallet","href":"/ru/api-capabilities/balance-query"},{"title":"API запроса журналов","icon":"file-text","href":"/ru/api-capabilities/log-query"},{"title":"Управление token API","icon":"key","href":"/ru/api-capabilities/token-management"},{"title":"Устаревшие модели","icon":"triangle-alert","href":"/ru/api-capabilities/deprecated-models"}]},{"group":"Image API (официальный)","icon":"image","pages":[{"group":"Основы Image API","icon":"book-check","pages":[{"title":"Основы API изображений и лучшие практики","sidebarTitle":"Обязательно к прочтению и лучшие практики","icon":"book-check","href":"/ru/api-capabilities/image-api-best-practices"},{"title":"Устранение обрывов соединения с API изображений","sidebarTitle":"Обрывы соединения","icon":"unplug","href":"/ru/api-capabilities/image-connection-drops"},{"title":"Запросы на изображение, которые зависают после получения данных","sidebarTitle":"Запросы, зависающие в конце","icon":"hourglass","href":"/ru/api-capabilities/image-tail-stall"},{"title":"Сжатие изображений и выходное разрешение","sidebarTitle":"Сжатие и разрешение","icon":"scaling","href":"/ru/api-capabilities/image-compression-resolution"},{"title":"Как получать удовлетворительные изображения","sidebarTitle":"Получение удовлетворительных изображений","icon":"target","href":"/ru/api-capabilities/image-generation-success-tips"},{"title":"Устранение отклонений по соображениям безопасности: найдите триггерное слово методом абляции","sidebarTitle":"Отклонения по соображениям безопасности","icon":"shield-alert","href":"/ru/api-capabilities/image-safety-troubleshooting"},{"title":"Длинные prompt и двухэтапная генерация: откуда берется лимит в 32K","sidebarTitle":"Длинные prompt","description":"Клиент спросил, почему наш prompt ограничен 32K, тогда как в ChatGPT такого ограничения нет. В документации указано 32 000 символов, но фактически действует лимит в 8 192 tokens, и при его превышении весь prompt молча отбрасывается без ошибки; веб-приложение принимает объемные материалы, поскольку чат-модель предварительно дистиллирует их. Рассматриваются лимит, стоимость, почему длиннее не значит лучшее следование инструкциям, а также двухэтапный пайплайн: материалы — в текстовую модель, prompt — в модель генерации изображений.","icon":"text-quote","href":"/ru/api-capabilities/image-long-prompt"},{"title":"Продвинутая генерация изображений: рабочий процесс и реалистичность","sidebarTitle":"Продвинутый рабочий процесс","icon":"workflow","href":"/ru/api-capabilities/image-advanced-workflow"},{"title":"Навык Image Prompt Doctor","sidebarTitle":"Навык Prompt Doctor","description":"Упаковывает предварительную проверку prompt перед генерацией в готовый к подключению Agent Skill для Codex, OpenClaw, hermes-agent, Claude Code и других: оценивает prompt по шести элементам, отмечает расплывчатые слова, снижающие качество, и выдает переписанный prompt, который можно использовать как есть. Также может проверить фактический результат по prompt, который его сгенерировал. По умолчанию использует gpt-5.6-luna.","icon":"stethoscope","href":"/ru/api-capabilities/image-prompt-doctor"},{"group":"Изображения: частые вопросы","icon":"circle-question-mark","pages":[{"title":"Может ли изображение быть отклонено после генерации?","sidebarTitle":"Проверка выходного изображения","icon":"shield-alert","href":"/ru/faq/image-output-safety-review"},{"title":"Есть ли conversational API, который выводит и текст, и сгенерированные изображения?","sidebarTitle":"Текст + изображение в одном API","icon":"images","href":"/ru/faq/text-and-image-in-one-api"},{"title":"Запрос на генерацию изображения зависает без результата, но в журнале указана ошибка записи?","icon":"hourglass","href":"/ru/faq/image-direct-large-response-stall"},{"title":"Запросы на генерацию изображений обрываются примерно через 90 секунд при работе через прокси?","icon":"unplug","href":"/ru/faq/proxy-idle-timeout-disconnect"},{"title":"Почему сгенерированное изображение сильно отличается от референса?","icon":"image","href":"/ru/faq/image-result-differs-from-reference"},{"title":"Как исправить ошибку несоответствия содержимого изображения MIME-типу?","icon":"image","href":"/ru/faq/image-mime-type-mismatch-with-query"},{"title":"Есть ли асинхронный API для генерации изображений? Можно ли запрашивать результаты по ID задачи?","icon":"image","href":"/ru/faq/image-async-api"}]}]},{"group":"Генерация изображений GPT-Image-2.6 / 2.5 / 2","icon":"sparkles","pages":[{"title":"Генерация и редактирование изображений GPT-Image-2.6 / 2.5 / 2","sidebarTitle":"Обзор GPT-Image-2.6 / 2.5 / 2","icon":"sparkles","href":"/ru/api-capabilities/gpt-image-2/overview"},{"title":"Новые возможности GPT Image 2.6","sidebarTitle":"Возможности GPT Image 2.6","openapi":"api-reference/gpt-image-2-6-generate-openapi-en.yaml POST /v1/images/generations","icon":"sparkles","href":"/ru/api-capabilities/gpt-image-2/gpt-image-2-6"},{"title":"Справочник API преобразования текста в изображение","openapi":"api-reference/gpt-image-2-generate-openapi-en.yaml POST /v1/images/generations","icon":"wand-sparkles","href":"/ru/api-capabilities/gpt-image-2/text-to-image"},{"title":"Справочник API редактирования изображений","openapi":"api-reference/gpt-image-2-edit-openapi-en.yaml POST /v1/images/edits","icon":"image","href":"/ru/api-capabilities/gpt-image-2/image-edit"},{"title":"GPT-Image-2.5 / 2 Серия навыка агента","icon":"blocks","href":"/ru/api-capabilities/gpt-image-2/skills"},{"title":"Руководство по масковому inpainting","sidebarTitle":"Масковый inpainting","icon":"brush","href":"/ru/api-capabilities/gpt-image-2/mask-editing"},{"title":"Устаревшие версии GPT-Image","sidebarTitle":"Устаревшие версии GPT-Image","icon":"rotate-ccw-clock","href":"/ru/api-capabilities/gpt-image-2/historical-versions"},{"group":"GPT-Image: частые вопросы","icon":"circle-question-mark","expanded":false,"pages":[{"title":"Какие значения reasoning effort поддерживаются для генерации SVG?","icon":"sliders-horizontal","href":"/ru/faq/gpt-image-svg-reasoning-effort"},{"title":"Как генерировать изображения с прозрачным фоном (PNG без фона)?","icon":"layers","href":"/ru/faq/image-transparent-background"},{"title":"Почему у GPT Image так много output tokens?","icon":"calculator","href":"/ru/faq/gpt-image-output-token-calculation"},{"title":"Интеграция Codex для GPT-Image завершается ошибкой из-за неверного API-ключа","sidebarTitle":"Ключ изображения отклонён OpenAI","icon":"key-round","href":"/ru/faq/gpt-image-incorrect-api-key-openai"}]}]},{"title":"GPT-image-2.5 / 2: официальные модели против reverse-версий","sidebarTitle":"GPT-image-2.5 / 2: официальные против reverse-версий","icon":"scale","href":"/ru/api-capabilities/gpt-image-2/vs-gpt-image-2-all"},{"group":"Генерация изображений GPT-Image-2.6-All","icon":"sparkles","pages":[{"title":"GPT-Image-2.6-All: генерация и редактирование","sidebarTitle":"Обзор GPT-Image-2.6-All","icon":"sparkles","href":"/ru/api-capabilities/gpt-image-2-all/gpt-image-2-6-all"},{"title":"GPT-Image-2.5-All: генерация/редактирование изображений","sidebarTitle":"Обзор GPT-Image-2.5-All","icon":"sparkles","href":"/ru/api-capabilities/gpt-image-2-all/overview"},{"title":"Справочник по API генерации изображений по тексту","openapi":"api-reference/gpt-image-2-all-generate-openapi-en.yaml POST /v1/images/generations","icon":"wand-sparkles","href":"/ru/api-capabilities/gpt-image-2-all/text-to-image"},{"title":"Справочник по API редактирования изображений","openapi":"api-reference/gpt-image-2-all-edit-openapi-en.yaml POST /v1/images/edits","icon":"image","href":"/ru/api-capabilities/gpt-image-2-all/image-edit"},{"title":"Навык агента GPT-Image-2.5-All","icon":"blocks","href":"/ru/api-capabilities/gpt-image-2-all/skills"}]},{"group":"Генерация изображений GPT-Image-2.5-VIP","icon":"expand","pages":[{"title":"GPT-Image-2.5-VIP: генерация/редактирование изображений","sidebarTitle":"Обзор GPT-Image-2.5-VIP","icon":"expand","href":"/ru/api-capabilities/gpt-image-2-vip/overview"},{"title":"Справочник API Text-to-Image","openapi":"api-reference/gpt-image-2-vip-generate-openapi-en.yaml POST /v1/images/generations","icon":"wand-sparkles","href":"/ru/api-capabilities/gpt-image-2-vip/text-to-image"},{"title":"Справочник API редактирования изображений","openapi":"api-reference/gpt-image-2-vip-edit-openapi-en.yaml POST /v1/images/edits","icon":"image","href":"/ru/api-capabilities/gpt-image-2-vip/image-edit"},{"title":"Навык агента GPT-Image-2.5-VIP","icon":"blocks","href":"/ru/api-capabilities/gpt-image-2-vip/skills"}]},{"title":"Тарифы серии Nano Banana","icon":"tag","href":"/ru/api-capabilities/nano-banana-pricing"},{"group":"Лучшие практики NanoBanana","icon":"lightbulb","pages":[{"title":"Руководство разработчика по серии Nano Banana","icon":"compass","href":"/ru/api-capabilities/nano-banana-dev-guide"},{"title":"Пояснение полей Usage и вывода","sidebarTitle":"Пояснение полей Usage и вывода","icon":"receipt-text","href":"/ru/api-capabilities/nano-banana-usage-metadata"},{"title":"Руководство по обработке ошибок API генерации изображений Gemini","icon":"triangle-alert","href":"/ru/api-capabilities/gemini-image-error-handling"},{"title":"Руководство по тестированию слияния нескольких изображений","sidebarTitle":"Тестирование слияния нескольких изображений","icon":"layers","href":"/ru/api-capabilities/multi-image-fusion-testing"},{"title":"План возмещения кредитов за неудачную генерацию Nano Banana Pro","icon":"shield-check","href":"/ru/api-capabilities/nano-banana-pro-guarantee"},{"title":"Группа Nano Banana OSS","icon":"link","href":"/ru/api-capabilities/nano-banana-oss-group"},{"group":"NB: частые вопросы","icon":"circle-question-mark","pages":[{"title":"Запускаются ли модели Google в AI Studio или Vertex?","icon":"split","href":"/ru/faq/google-upstream-aistudio-vertex"},{"title":"При редактировании изображений возвращается Unable to Process Input Image?","icon":"image-off","href":"/ru/faq/gemini-empty-inlinedata"},{"title":"Почему Gemini Image возвращает IMAGE_OTHER?","sidebarTitle":"IMAGE_OTHER","icon":"image-minus","href":"/ru/faq/gemini-image-other"},{"title":"Почему Gemini Image возвращает blockReason: OTHER?","sidebarTitle":"blockReason: OTHER","icon":"shield-alert","href":"/ru/faq/gemini-image-input-blocked"},{"title":"Основные причины сбоев генерации изображений Nano Banana","icon":"image-off","href":"/ru/faq/nano-banana-image-failure"},{"title":"Почему API Gemini для генерации изображений возвращает NO_IMAGE?","icon":"image-off","href":"/ru/faq/gemini-no-image"},{"title":"Почему мое изображение становится красноватым после редактирования в Nano Banana Pro?","icon":"image","href":"/ru/faq/banana-pro-edit-red-cast"},{"title":"Как исправить искажения при смене одежды с Nano Banana Pro?","icon":"shirt","href":"/ru/faq/nano-banana-pro-print-distortion"},{"title":"Почему на изображении с белым фоном появляются чёрные пятна, грязные разводы или размытые цветные блоки?","icon":"triangle-alert","href":"/ru/faq/white-background-image-artifacts"}]}]},{"group":"Генерация изображений Nano Banana 2.1","icon":"banana","pages":[{"title":"Nano Banana 2.1: генерация и редактирование изображений","icon":"banana","href":"/ru/api-capabilities/gemini-nano-banana-2.1/overview"},{"title":"Справочник по API Text-to-Image","openapi":"api-reference/gemini-nano-banana-2.1-generate-openapi-en.yaml POST /v1beta/models/gemini-nano-banana-2.1:generateContent","icon":"wand-sparkles","href":"/ru/api-capabilities/gemini-nano-banana-2.1/text-to-image"},{"title":"Справочник по API редактирования изображений","openapi":"api-reference/gemini-nano-banana-2.1-edit-openapi-en.yaml POST /v1beta/models/gemini-nano-banana-2.1:generateContent","icon":"image","href":"/ru/api-capabilities/gemini-nano-banana-2.1/image-edit"},{"title":"Agent Skill для Nano Banana 2.1","icon":"blocks","href":"/ru/api-capabilities/gemini-nano-banana-2.1/skills"}]},{"group":"Генерация изображений Nano Banana Pro","icon":"banana","pages":[{"title":"Генерация изображений Nano Banana Pro","icon":"banana","href":"/ru/api-capabilities/nano-banana-image/overview"},{"title":"Справочник API для генерации изображений по тексту","openapi":"api-reference/nano-banana-pro-generate-openapi-en.yaml POST /v1beta/models/gemini-3-pro-image:generateContent","icon":"wand-sparkles","href":"/ru/api-capabilities/nano-banana-image/text-to-image"},{"title":"Справочник API редактирования изображений","openapi":"api-reference/nano-banana-pro-edit-openapi-en.yaml POST /v1beta/models/gemini-3-pro-image:generateContent","icon":"image","href":"/ru/api-capabilities/nano-banana-image/image-edit"},{"title":"Навык агента Nano Banana Pro","icon":"blocks","href":"/ru/api-capabilities/nano-banana-image/skills"}]},{"group":"Генерация изображений Nano Banana 2","icon":"banana","pages":[{"title":"Nano Banana 2: генерация и редактирование изображений","icon":"banana","href":"/ru/api-capabilities/nano-banana-2-image/overview"},{"title":"Справочник API для преобразования текста в изображение","openapi":"api-reference/nano-banana-2-generate-openapi-en.yaml POST /v1beta/models/gemini-3.1-flash-image:generateContent","icon":"wand-sparkles","href":"/ru/api-capabilities/nano-banana-2-image/text-to-image"},{"title":"Справочник API редактирования изображений","openapi":"api-reference/nano-banana-2-edit-openapi-en.yaml POST /v1beta/models/gemini-3.1-flash-image:generateContent","icon":"image","href":"/ru/api-capabilities/nano-banana-2-image/image-edit"},{"title":"Навык агента Nano Banana 2","icon":"blocks","href":"/ru/api-capabilities/nano-banana-2-image/skills"}]},{"group":"Генерация изображений Nano Banana Lite","icon":"banana","pages":[{"title":"Генерация/редактирование изображений с Nano Banana Lite","icon":"banana","href":"/ru/api-capabilities/nano-banana-lite-image/overview"},{"title":"Справочник API Text-to-Image","openapi":"api-reference/nano-banana-lite-generate-openapi-en.yaml POST /v1beta/models/gemini-3.1-flash-lite-image:generateContent","icon":"wand-sparkles","href":"/ru/api-capabilities/nano-banana-lite-image/text-to-image"},{"title":"Справочник API для редактирования изображений","openapi":"api-reference/nano-banana-lite-edit-openapi-en.yaml POST /v1beta/models/gemini-3.1-flash-lite-image:generateContent","icon":"image","href":"/ru/api-capabilities/nano-banana-lite-image/image-edit"},{"title":"Навык Agent Skill для Nano Banana Lite","icon":"blocks","href":"/ru/api-capabilities/nano-banana-lite-image/skills"}]},{"group":"Генерация и редактирование изображений FLUX","icon":"sparkles","pages":[{"title":"Генерация и редактирование изображений FLUX","sidebarTitle":"Обзор FLUX","icon":"sparkles","href":"/ru/api-capabilities/flux/overview"},{"title":"Справочник API для преобразования текста в изображение","openapi":"api-reference/flux-generate-openapi-en.yaml POST /v1/images/generations","icon":"wand-sparkles","href":"/ru/api-capabilities/flux/text-to-image"},{"title":"Справочник API по редактированию изображений","openapi":"api-reference/flux-edit-openapi-en.yaml POST /v1/images/generations","icon":"image","href":"/ru/api-capabilities/flux/image-edit"},{"title":"Исторические версии FLUX","sidebarTitle":"Исторические версии","icon":"rotate-ccw-clock","href":"/ru/api-capabilities/flux/historical-versions"}]},{"group":"Серия Seedream 5.0","icon":"sparkles","pages":[{"title":"Генерация и редактирование изображений Seedream","sidebarTitle":"Обзор Seedream","icon":"sparkles","href":"/ru/api-capabilities/seedream-image/overview"},{"title":"Справочник API Text-to-Image","openapi":"api-reference/seedream-image-generate-openapi-en.yaml POST /v1/images/generations","icon":"wand-sparkles","href":"/ru/api-capabilities/seedream-image/text-to-image"},{"title":"Справочник API для редактирования изображений","openapi":"api-reference/seedream-image-edit-openapi-en.yaml POST /v1/images/generations","icon":"image","href":"/ru/api-capabilities/seedream-image/image-edit"},{"title":"Предыдущие версии Seedream","sidebarTitle":"Предыдущие версии","icon":"rotate-ccw-clock","href":"/ru/api-capabilities/seedream-image/historical-versions"}]},{"group":"Grok Imagine: официальная генерация изображений","icon":"sparkles","pages":[{"title":"Официальная генерация изображений Grok Imagine","sidebarTitle":"Официальный обзор Grok Imagine","icon":"sparkles","href":"/ru/api-capabilities/grok-imagine-image-official/overview"},{"title":"Справочник по официальному API генерации изображений по тексту Grok Imagine","sidebarTitle":"Генерация изображений по тексту","openapi":"api-reference/grok-imagine-image-official-generate-openapi-en.yaml POST /v1/images/generations","icon":"wand-sparkles","href":"/ru/api-capabilities/grok-imagine-image-official/text-to-image"}]},{"group":"Grok Imagine (reverse): генерация и редактирование изображений","icon":"sparkles","pages":[{"title":"Grok Imagine Reverse: генерация и редактирование изображений","sidebarTitle":"Обзор Grok Imagine Reverse","icon":"sparkles","href":"/ru/api-capabilities/grok-imagine-image/overview"},{"title":"Справочник API генерации изображений по тексту","openapi":"api-reference/grok-imagine-image-generate-openapi-en.yaml POST /v1/images/generations","icon":"wand-sparkles","href":"/ru/api-capabilities/grok-imagine-image/text-to-image"},{"title":"Справочник API для редактирования изображений","openapi":"api-reference/grok-imagine-image-edit-openapi-en.yaml POST /v1/images/edits","icon":"image","href":"/ru/api-capabilities/grok-imagine-image/image-edit"}]},{"group":"Генерация и редактирование изображений MAI-Image 2.6","icon":"sparkles","pages":[{"title":"MAI-Image 2.6: генерация и редактирование изображений","sidebarTitle":"Обзор MAI-Image 2.6","icon":"sparkles","href":"/ru/api-capabilities/mai-image/overview"},{"title":"Справочник по Text-to-Image API","openapi":"api-reference/mai-image-generate-openapi-en.yaml POST /v1/images/generations","icon":"wand-sparkles","href":"/ru/api-capabilities/mai-image/text-to-image"},{"title":"Справочник API редактирования изображений","openapi":"api-reference/mai-image-edit-openapi-en.yaml POST /v1/images/edits","icon":"image","href":"/ru/api-capabilities/mai-image/image-edit"}]},{"title":"Практика интеграции Image API: создайте собственную асинхронную очередь","sidebarTitle":"Самостоятельно размещенная асинхронная очередь","icon":"list-checks","href":"/ru/api-capabilities/image-async-queue"}]},{"group":"Video API (официальный)","icon":"video","pages":[{"group":"Seedance 2.0 / 2.5 (Volcano Engine)","icon":"film","pages":[{"title":"Seedance 2.0 / 2.5 Генерация видео","sidebarTitle":"Обзор Seedance 2.0 / 2.5","icon":"film","href":"/ru/api-capabilities/seedance2/overview"},{"title":"Справочник API для генерации видео Seedance 2.0 / 2.5","sidebarTitle":"Генерация видео","openapi":"api-reference/seedance2-video-openapi-en.yaml POST /seedance/api/v3/contents/generations/tasks","icon":"video","href":"/ru/api-capabilities/seedance2/video-generation"},{"title":"Навык агента для генерации видео Seedance 2.0","icon":"blocks","href":"/ru/api-capabilities/seedance2/skills"},{"title":"Библиотека ассетов Seedance 2.0 (видео с сохранением персонажа)","sidebarTitle":"Библиотека ассетов","icon":"images","href":"/ru/api-capabilities/seedance2/asset-library"},{"title":"Генерация видео с привязкой к asset в коде","sidebarTitle":"Руководство по ссылкам на asset","icon":"clapperboard","href":"/ru/api-capabilities/seedance2/asset-reference"},{"title":"Сначала ресурсы: более быстрая и надёжная передача изображений и видео","sidebarTitle":"Рабочий процесс «Сначала ресурсы»","icon":"gauge","href":"/ru/api-capabilities/seedance2/asset-first-workflow"},{"group":"SD: частые вопросы","icon":"circle-question-mark","pages":[{"title":"Seedance сообщает, что первый/последний кадр нельзя смешивать с референсными медиа","sidebarTitle":"Смешивание первого кадра с референсом","icon":"layers","href":"/ru/faq/seedance-first-frame-mixed-with-reference"},{"title":"Seedance сообщает об ошибке invalid image format, но ссылка открывается в браузере","sidebarTitle":"Ссылка на изображение открывается, но не работает","icon":"link","href":"/ru/faq/seedance-image-url-invalid-format"},{"title":"Seedance 2.5: референс-видео и редактирование видео","icon":"split","href":"/ru/faq/seedance2-reference-vs-edit"},{"title":"Можно ли отменить задачу Seedance после отправки?","icon":"video","href":"/ru/faq/seedance-video-task-cancel"},{"title":"Как узнать фактическую стоимость видео Seedance по task_id?","icon":"receipt","href":"/ru/faq/seedance-task-cost-lookup"},{"title":"Загружает ли Seedance 2.0 автоматически референсы лиц в библиотеку ассетов? Срабатывает ли при этом фильтр deepfake?","icon":"banana","href":"/ru/faq/seedance2-asset-face-reference"},{"title":"Почему Seedance 2.0 / 2.5 блокирует ассеты с лицами?","icon":"scan-face","href":"/ru/faq/seedance2-face-asset-whitelist"}]}]},{"group":"Генерация видео Wan3.0 (Alibaba Cloud)","icon":"video","pages":[{"title":"Генерация видео Wan3.0 (Alibaba Tongyi Wanxiang)","sidebarTitle":"Обзор","icon":"video","href":"/ru/api-capabilities/wan3/overview"},{"title":"Справочник API генерации видео Wan3.0","sidebarTitle":"Генерация видео","openapi":"api-reference/wan3-video-openapi-en.yaml POST /wan/api/v1/services/aigc/video-generation/video-synthesis","icon":"wand-sparkles","href":"/ru/api-capabilities/wan3/video-generation"},{"title":"Wan3.0: ошибка загрузки — почему URL исходного медиад файла не работает и как это исправить","sidebarTitle":"Ошибки загрузки медиафайлов","icon":"circle-question-mark","href":"/ru/faq/wan3-media-download-failed"}]},{"group":"Генерация видео Wan2.7 (Alibaba Cloud)","icon":"videotape","pages":[{"title":"Генерация видео Wan (Alibaba Cloud Tongyi Wanxiang)","sidebarTitle":"Обзор Wan","icon":"video","href":"/ru/api-capabilities/wan/overview"},{"title":"Wan2.7 Справочник API для преобразования текста в видео","sidebarTitle":"Преобразование текста в видео","openapi":"api-reference/wan-text-to-video-openapi-en.yaml POST /wan/api/v1/services/aigc/video-generation/video-synthesis","icon":"wand-sparkles","href":"/ru/api-capabilities/wan/text-to-video"},{"title":"Wan2.7 Image-to-Video API Reference","sidebarTitle":"Изображение-в-видео","openapi":"api-reference/wan-image-to-video-openapi-en.yaml POST /wan/api/v1/services/aigc/video-generation/video-synthesis","icon":"image","href":"/ru/api-capabilities/wan/image-to-video"},{"title":"Справочник API Wan2.7 для генерации видео по референсу","sidebarTitle":"Генерация видео по референсу","openapi":"api-reference/wan-reference-to-video-openapi-en.yaml POST /wan/api/v1/services/aigc/video-generation/video-synthesis","icon":"users","href":"/ru/api-capabilities/wan/reference-to-video"},{"title":"Справочник API для редактирования видео Wan2.7","sidebarTitle":"Редактирование видео","openapi":"api-reference/wan-video-edit-openapi-en.yaml POST /wan/api/v1/services/aigc/video-generation/video-synthesis","icon":"scissors","href":"/ru/api-capabilities/wan/video-edit"},{"title":"Навык Agent Skill для видео Wan2.7 и HappyHorse","icon":"blocks","href":"/ru/api-capabilities/wan/skills"},{"title":"Исторические версии Wan (Wan2.6)","sidebarTitle":"Исторические версии","icon":"rotate-ccw-clock","href":"/ru/api-capabilities/wan/historical-versions"}]},{"group":"Генерация видео HappyHorse (Alibaba Cloud)","icon":"monitor-play","pages":[{"title":"Генерация видео HappyHorse (Alibaba Cloud)","sidebarTitle":"Обзор HappyHorse","icon":"monitor-play","href":"/ru/api-capabilities/happyhorse/overview"},{"title":"HappyHorse Текст-в-видео справочник API","sidebarTitle":"Текст-в-видео","openapi":"api-reference/happyhorse-text-to-video-openapi-en.yaml POST /wan/api/v1/services/aigc/video-generation/video-synthesis","icon":"wand-sparkles","href":"/ru/api-capabilities/happyhorse/text-to-video"},{"title":"Справочник API HappyHorse по преобразованию изображения в видео","sidebarTitle":"Изображение в видео","openapi":"api-reference/happyhorse-image-to-video-openapi-en.yaml POST /wan/api/v1/services/aigc/video-generation/video-synthesis","icon":"image","href":"/ru/api-capabilities/happyhorse/image-to-video"},{"title":"Справочник API Reference-to-Video HappyHorse","sidebarTitle":"Reference-to-Video","openapi":"api-reference/happyhorse-reference-to-video-openapi-en.yaml POST /wan/api/v1/services/aigc/video-generation/video-synthesis","icon":"users","href":"/ru/api-capabilities/happyhorse/reference-to-video"},{"title":"Справочник API для редактирования видео HappyHorse","sidebarTitle":"Редактирование видео","openapi":"api-reference/happyhorse-video-edit-openapi-en.yaml POST /wan/api/v1/services/aigc/video-generation/video-synthesis","icon":"scissors","href":"/ru/api-capabilities/happyhorse/video-edit"},{"title":"Навык видео-агента HappyHorse","icon":"blocks","href":"/ru/api-capabilities/happyhorse/skills"}]},{"group":"Grok Imagine: генерация видео (xAI)","icon":"camera","pages":[{"title":"Генерация видео Grok Imagine","sidebarTitle":"Обзор Grok Imagine Video","icon":"video","href":"/ru/api-capabilities/grok-imagine-video/overview"},{"title":"Справочник по API генерации видео Grok Imagine","sidebarTitle":"Генерация видео","openapi":"api-reference/grok-imagine-video-openapi-en.yaml POST /v1/videos","icon":"wand-sparkles","href":"/ru/api-capabilities/grok-imagine-video/video-generation"}]},{"group":"MiniMax H3: генерация видео (собственное развёртывание)","icon":"film","pages":[{"title":"Генерация видео MiniMax-H3","sidebarTitle":"Обзор MiniMax-H3","icon":"video","href":"/ru/api-capabilities/minimax-h3/overview"},{"title":"Справочник по API генерации видео MiniMax-H3","sidebarTitle":"Генерация видео","openapi":"api-reference/minimax-h3-video-openapi-en.yaml POST /hailuo/v2/video_generation","icon":"video","href":"/ru/api-capabilities/minimax-h3/video-generation"}]},{"group":"Oxygen: генерация видео (AZ8)","icon":"clapperboard","pages":[{"title":"Генерация видео Oxygen","sidebarTitle":"Обзор Oxygen","icon":"video","href":"/ru/api-capabilities/oxygen/overview"},{"title":"Справочник по API генерации видео Oxygen","sidebarTitle":"Генерация видео","openapi":"api-reference/oxygen-video-openapi-en.yaml POST /videos","icon":"video","href":"/ru/api-capabilities/oxygen/video-generation"}]}]},{"group":"API мультимодального понимания","icon":"eye","pages":[{"group":"API распознавания изображений","icon":"eye","root":{"title":"API зрительного восприятия (распознавание изображений)","icon":"eye","href":"/ru/api-capabilities/vision-understanding"},"pages":[{"group":"Распознавание изображений: частые вопросы","icon":"circle-help","expanded":false,"pages":[{"title":"Запросы на анализ изображений завершаются по таймауту — изображение слишком большое?","icon":"image","href":"/ru/faq/vision-image-too-large"}]}]},{"title":"API анализа видео","icon":"video","href":"/ru/api-capabilities/video-understanding"}]},{"group":"Генерация текста","icon":"file-text","pages":[{"title":"Генерация текста (Chat Completions)","icon":"message-square","href":"/ru/api-capabilities/text-generation"},{"group":"Gemini 4 Carbon","icon":"sparkles","pages":[{"title":"Генерация текста Gemini 4 Карбон","sidebarTitle":"Обзор Gemini 4 Карбон","icon":"sparkles","href":"/ru/api-capabilities/gemini-4-carbon/overview"}]},{"group":"Gemini 4 Argon","icon":"sparkles","pages":[{"title":"Генерация текста Gemini 4 Argon","sidebarTitle":"Обзор Gemini 4 Argon","icon":"sparkles","href":"/ru/api-capabilities/gemini-4-argon/overview"}]},{"group":"GPT-6 Astra","icon":"sparkles","pages":[{"title":"Генерация текста GPT-6 Astra","sidebarTitle":"Обзор GPT-6 Astra","icon":"sparkles","href":"/ru/api-capabilities/gpt-6-astra/overview"}]},{"group":"DeepSeek V4 Flash Vision","icon":"eye","pages":[{"title":"DeepSeek V4 Flash для работы с изображениями","sidebarTitle":"Обзор","icon":"eye","href":"/ru/api-capabilities/deepseek-v4-flash-vision/overview"},{"title":"Справочник Chat API для DeepSeek V4 Flash Vision","sidebarTitle":"Песочница чата","openapi":"api-reference/deepseek-v4-flash-vision-chat-openapi-en.yaml POST /v1/chat/completions","icon":"terminal","href":"/ru/api-capabilities/deepseek-v4-flash-vision/chat-completions"},{"title":"DeepSeek V4 Flash Vision Messages API Reference","sidebarTitle":"Песочница сообщений","openapi":"api-reference/deepseek-v4-flash-vision-messages-openapi-en.yaml POST /v1/messages","icon":"terminal","href":"/ru/api-capabilities/deepseek-v4-flash-vision/messages"}]},{"group":"DeepSeek V4 Flash","icon":"zap","pages":[{"title":"DeepSeek V4 Flash Генерация текста","sidebarTitle":"Обзор","icon":"zap","href":"/ru/api-capabilities/deepseek-v4-flash/overview"},{"title":"Справочник по Chat API DeepSeek V4 Flash","sidebarTitle":"Песочница чата","openapi":"api-reference/deepseek-v4-flash-chat-openapi-en.yaml POST /v1/chat/completions","icon":"terminal","href":"/ru/api-capabilities/deepseek-v4-flash/chat-completions"},{"title":"DeepSeek V4 Flash Responses — справочник API","sidebarTitle":"Песочница Responses","openapi":"api-reference/deepseek-v4-flash-responses-openapi-en.yaml POST /v1/responses","icon":"git-fork","href":"/ru/api-capabilities/deepseek-v4-flash/responses"}]},{"group":"DeepSeek Search \u0026 Fetch","icon":"search","pages":[{"title":"API поиска и извлечения данных из веба DeepSeek","sidebarTitle":"Обзор","icon":"search","href":"/ru/api-capabilities/deepseek-search-fetch/overview"},{"title":"Справочник по API веб-поиска DeepSeek","sidebarTitle":"Площадка для поиска","openapi":"api-reference/deepseek-search-openapi-en.yaml POST /v1/tools/search","icon":"terminal","href":"/ru/api-capabilities/deepseek-search-fetch/search-api"},{"title":"Справочник API для загрузки веб-страниц DeepSeek","sidebarTitle":"Песочница загрузки","openapi":"api-reference/deepseek-fetch-openapi-en.yaml POST /v1/tools/fetch","icon":"terminal","href":"/ru/api-capabilities/deepseek-search-fetch/fetch-api"}]},{"group":"Seed 2.1 Turbo","icon":"zap","pages":[{"title":"Генерация текста Seed 2.1 Turbo","sidebarTitle":"Обзор","icon":"message-square","href":"/ru/api-capabilities/dola-seed-2-1-turbo/overview"},{"title":"Справочник API чата Seed 2.1 Turbo","sidebarTitle":"Песочница чата","openapi":"api-reference/dola-seed-2-1-turbo-chat-openapi-en.yaml POST /v1/chat/completions","icon":"terminal","href":"/ru/api-capabilities/dola-seed-2-1-turbo/chat-completions"},{"title":"Справочник по Responses API для Seed 2.1 Turbo","sidebarTitle":"Песочница Responses","openapi":"api-reference/dola-seed-2-1-turbo-responses-openapi-en.yaml POST /v1/responses","icon":"messages-square","href":"/ru/api-capabilities/dola-seed-2-1-turbo/responses"}]},{"group":"Серия Gemini Flash","icon":"sparkles","pages":[{"title":"Генерация текста с Gemini 3.8 Flash","sidebarTitle":"Обзор Gemini 3.8 Flash","icon":"sparkles","href":"/ru/api-capabilities/gemini-3-8-flash/overview"},{"title":"Генерация текста с Gemini 3.6 Flash","sidebarTitle":"Обзор Gemini 3.6 Flash","icon":"sparkles","href":"/ru/api-capabilities/gemini-3-6-flash/overview"},{"title":"Справочник по нативному API Gemini 3.6 Flash","sidebarTitle":"Нативная площадка 3.6","openapi":"api-reference/gemini-3-6-flash-native-openapi-en.yaml POST /v1beta/models/gemini-3.6-flash:generateContent","icon":"terminal","href":"/ru/api-capabilities/gemini-3-6-flash/generate-content"},{"title":"Справочник API чата Gemini 3.6 Flash","sidebarTitle":"Песочница чата 3.6","openapi":"api-reference/gemini-3-6-flash-chat-openapi-en.yaml POST /v1/chat/completions","icon":"terminal","href":"/ru/api-capabilities/gemini-3-6-flash/chat-completions"}]},{"group":"Gemini 3.5 Flash-Lite","icon":"feather","pages":[{"title":"Gemini 3.5 Flash-Lite Генерация текста","sidebarTitle":"Обзор","icon":"feather","href":"/ru/api-capabilities/gemini-3-5-flash-lite/overview"},{"title":"Gemini 3.5 Flash-Lite Нативная справка по API","sidebarTitle":"Нативная песочница","openapi":"api-reference/gemini-3-5-flash-lite-native-openapi-en.yaml POST /v1beta/models/gemini-3.5-flash-lite:generateContent","icon":"terminal","href":"/ru/api-capabilities/gemini-3-5-flash-lite/generate-content"},{"title":"Gemini 3.5 Flash-Lite Справочник Chat API","sidebarTitle":"Песочница Chat","openapi":"api-reference/gemini-3-5-flash-lite-chat-openapi-en.yaml POST /v1/chat/completions","icon":"terminal","href":"/ru/api-capabilities/gemini-3-5-flash-lite/chat-completions"}]},{"group":"Серия Qwen3","icon":"puzzle","pages":[{"title":"Генерация текста Qwen3.8-Max","sidebarTitle":"Обзор","icon":"puzzle","href":"/ru/api-capabilities/qwen-3-8/overview"},{"title":"Справка по Chat API Qwen3.8-Max","sidebarTitle":"Песочница Chat","openapi":"api-reference/qwen-3-8-max-chat-openapi-en.yaml POST /v1/chat/completions","icon":"terminal","href":"/ru/api-capabilities/qwen-3-8/chat-completions"},{"title":"Серия текстовых моделей Qwen3.6 (устаревшая)","sidebarTitle":"Qwen3.6 (устаревшая)","icon":"puzzle","href":"/ru/api-capabilities/qwen-3-6/overview"}]},{"group":"Kimi K3.1 Pro","icon":"moon","pages":[{"title":"Обзор Kimi K3.1 Pro","sidebarTitle":"Обзор","icon":"brain","href":"/ru/api-capabilities/kimi-k3-1/overview"}]},{"title":"Генерация текста Kimi K2.5","sidebarTitle":"Kimi K2.5","icon":"bot","href":"/ru/api-capabilities/kimi-k2-5"}]},{"group":"Audio API (официальный)","icon":"audio-lines","pages":[{"title":"Голосовой режим реального времени (WebSocket)","sidebarTitle":"Обзор голосового режима реального времени","icon":"audio-lines","href":"/ru/api-capabilities/realtime/overview"}]},{"group":"Поиск и безопасность","icon":"search","pages":[{"title":"API векторизации текста","icon":"vector-square","href":"/ru/api-capabilities/text-embedding"},{"title":"Практическая настройка embedding","sidebarTitle":"Настройка embedding","icon":"sliders-horizontal","href":"/ru/api-capabilities/embedding-best-practices"},{"group":"Реранжирование","icon":"list-ordered","pages":[{"title":"bge-reranker-v2-m3 Переранжирование текста","sidebarTitle":"Обзор","icon":"list-ordered","href":"/ru/api-capabilities/rerank/overview"},{"title":"Справочник Rerank API","sidebarTitle":"Песочница","openapi":"api-reference/bge-reranker-v2-m3-rerank-openapi-en.yaml POST /v1/rerank","icon":"terminal","href":"/ru/api-capabilities/rerank/rerank-api"},{"title":"Настройка RAG на практике","sidebarTitle":"Настройка RAG","icon":"sliders-horizontal","href":"/ru/api-capabilities/rerank/rag-best-practices"}]},{"title":"Модерация текста","icon":"shield-check","href":"/ru/api-capabilities/text-moderation"}]}]},{"tab":"Сценарии использования","icon":"layout-grid","pages":[{"title":"Сценарии использования","href":"/ru/scenarios"}]},{"tab":"FAQ","icon":"circle-question-mark","pages":[{"title":"FAQ","href":"/ru/faq"}]},{"tab":"Обновления в реальном времени","icon":"activity","pages":[{"title":"Обновления в реальном времени","href":"/ru/live"}]},{"tab":"Объявления","icon":"megaphone","pages":[{"title":"Объявления","href":"/ru/changelog"}]},{"tab":"Акции","icon":"gift","pages":[{"title":"Акции","href":"/ru/faq/recharge-promotions"}]},{"tab":"Цены на модели","icon":"circle-dollar-sign","pages":[{"title":"Цены на модели","href":"/ru/models"}]}]}]},"basePath":"","title":"Продвинутая генерация изображений: рабочий процесс и реалистичность - API易文档中心","buildId":"dpl_DqYu5MPb49gWBBbUGgpHQUmCHY3P","deploymentId":"dpl_DqYu5MPb49gWBBbUGgpHQUmCHY3P","dynamics":["10e4515597","07c022d89b","a74be98ba7"],"chunks":["BannerMarkdown-DV3Oq1fY.js","dist-C-XZBk9h.js","lib-DuNMoZ05.js","lib-B8HbPgcC.js","clsx-D3Isdib3.js","html-void-elements-mCSPHezU.js","katex-YMM-FMeD.js","marked.esm-CZWythHk.js","Frame-u3J1-UOn.js","DynamicMarkdown-B-f2cqXQ.js","zoom-image-lightbox-DTFzvaXJ.js","lightbox-handle-r17bVUz3.js"]}