

Разбор случая: правка, в которой цвет получился неверным
Задача: карточка товара игрушечного чайного набора с двумя чашками в левом нижнем углу, выделенными красной рамкой. prompt: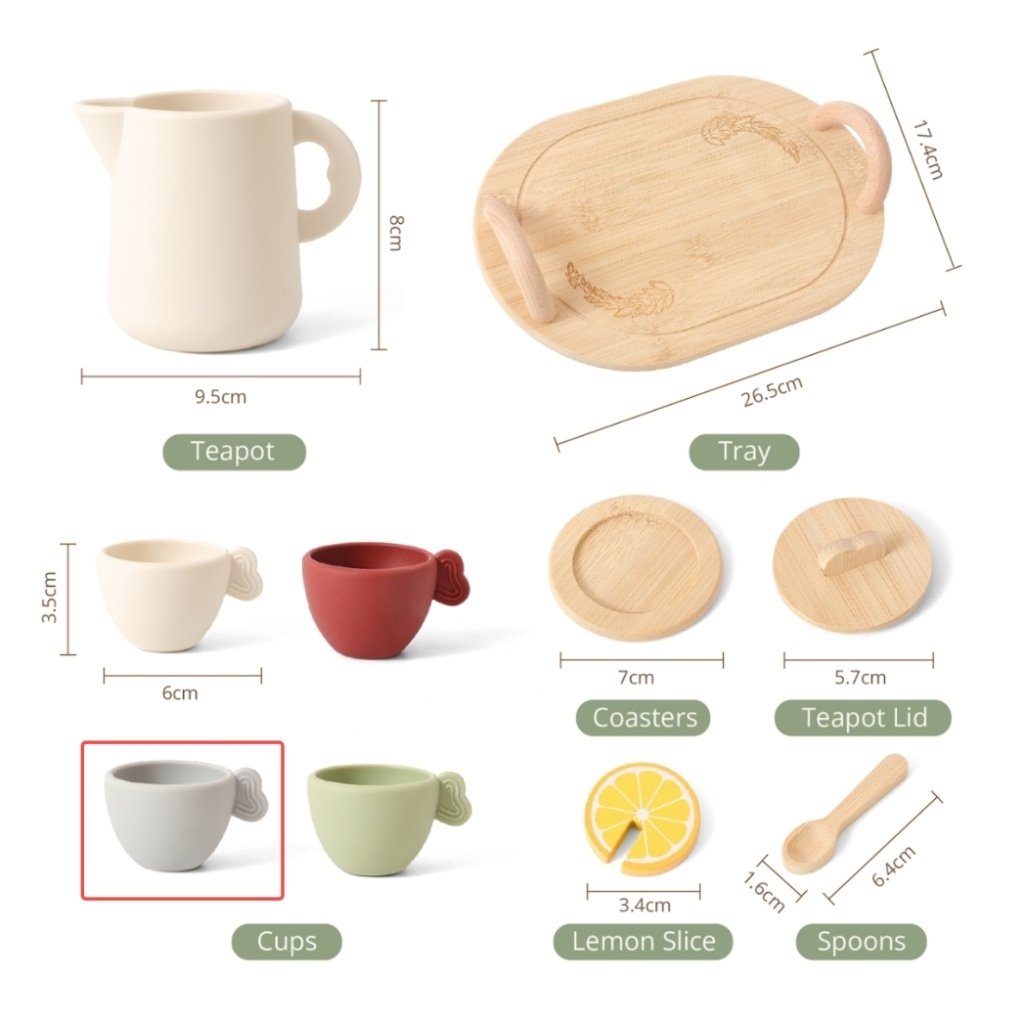
Input image: a red box marks the two cups (one gray, one green) in the lower left; the request is to make them black and remove the box
gemini-3.1-flash-image (Nano Banana 2) через API и получил следующее:
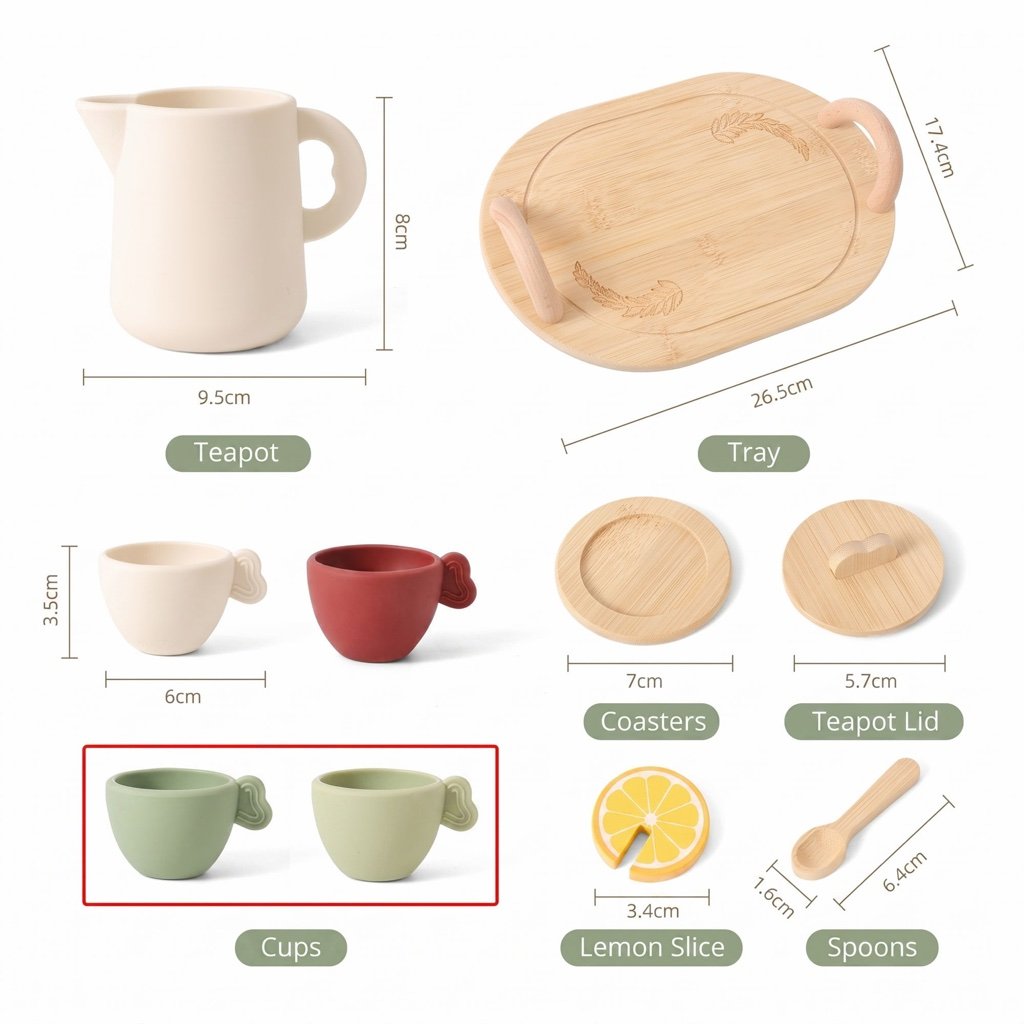
Failed result from a single API call: both cups turned green, and the red box was not removed
gemini.google.com), и там всё сработало хорошо. Их отзыв:
Результат API совершенно отличается от официального (web) результата — кажется, что API просто понимает хуже.Фрустрация понятна, но с выводом нужно быть аккуратнее. Разберем это по шагам.
Сначала поймите: веб-приложение — это агент; API — это один атомарный вызов
Сравнивать результатыgemini.google.com напрямую с сырым API-вызовом — это не сопоставление яблок с яблоками:
Одна и та же модель, две формы продукта. Веб-приложение превращает вашу неформальную инструкцию в форму, которую модель выполняет надежнее — в случае API эта доработка лежит на вас (и именно в этом ценность API: все контролируемо, воспроизводимо и легко интегрируется).
Поэтому «веб-приложение работает лучше» в основном связано с различиями в pipeline — это не доказывает, что «API понимает меньше». API получает ваш сырой, необработанный prompt, поэтому результат естественным образом сильнее зависит от качества самого prompt.
Вариативность одного вызова присуща генеративным моделям
Мы повторили задачу с тем же самым prompt + image в тестовом инструменте imagen.apiyi.com: с первого раза сработало — чашки стали чёрными, красная коробка была удалена, всё остальное осталось без изменений.Чтобы было понятно: единственное отличие между imagen.apiyi.com и прямым вызовом API — встроенный prompt с намерением «сгенерировать изображение». Он помогает модели зафиксироваться на создании изображения, но никак не влияет на то, успешно ли сработает точное редактирование в этом случае — инструмент не сработал не потому, что он «добавил секретный соус».
Стратегия 1: Улучшите prompt
Чем менее неоднозначен и чем более исполним prompt, тем выше вероятность успеха за один вызов. Рассмотрим этот случай в качестве примера: Исходный prompt (разговорный, полагается на то, что модель сделает выводы):Измените объекты в красной рамке на черный цвет, удалите красную рамку, все остальное оставьте без измененийУлучшения:
Пример улучшенного полного prompt:
Отредактируйте это изображение и выполните две вещи: ① перекрасьте две чашки внутри красной рамки в матовый чисто черный цвет, сохранив их исходную текстуру материала и форму; ② удалите саму красную рамку. Оставьте цвета, расположение, размерные подписи и текст всех остальных объектов на изображении полностью без изменений.
Не знаете, как это улучшить? Попросите ИИ переписать это за вас
Улучшение prompt — это тоже задача, которую можно поручить ИИ: просто отправьте вместе три вещи в известный, надежный чат-сервис с ИИ (например,chatgpt.com или gemini.google.com):
- Исходный prompt (вставленный дословно);
- Описание проблемы (например: “попросили черный, а получили зеленый, и красная рамка не была удалена”);
- Сравнение до/после (загрузите оригинальное изображение и фактический результат вместе).
Стратегия 2: Повторная попытка при сбое
Поскольку сбои возникают из-за дисперсии единичной выборки, повторная попытка сама по себе является эффективным способом устранения проблемы — повторная отправка того же самого запроса часто просто срабатывает (именно это и произошло в данном случае).- Закладывайте 1–2 автоматические повторные попытки в ваш бизнес-код для случая «результат не соответствует ожиданиям»;
- Различайте два типа сбоев: «изображение вернулось, но правка неверна» и «изображение вообще не вернулось». Второй случай (HTTP 200, но без изображения) обычно означает блокировку из-за модерации контента — см. Руководство по обработке ошибок Gemini Image API.
Стратегия 3: переключение моделей
Для этого сценария мы протестировали другие модели с идентичным prompt + изображением — все справились с первой попытки:
Разные модели лучше справляются с разными типами инструкций. Задача, которая раз за разом завершается ошибкой на одной модели, может сразу выполниться на другой. В едином шлюзе APIYI для переключения модели достаточно изменить только параметр
model (тот же ключ, тот же эндпоинт) — практически с нулевыми затратами. Сделайте «переключение моделей» полноценным этапом в вашем рабочем процессе обработки изображений — это полноценная стратегия достижения цели, а не компромисс.
На практике выстройте последовательность по принципу «сначала быстрые, потом мощные»:
- По умолчанию используйте быструю и недорогую модель (например,
gemini-3.1-flash-image) для рутинных задач; - Если задача точного редактирования завершается ошибкой 1–2 раза, автоматически переключайтесь на
gemini-3-pro-imageили сериюgpt-image-2и повторяйте попытку; - Если ничего не помогает, вернитесь назад и переработайте prompt.
Особый случай: размытый мелкий текст — проблема уровня качества, а не модели
Если изображение содержит текст (плакаты, скриншоты интерфейса, вывески, подписи к графикам), размытие мелких символов обычно вызвано слишком низким уровнем качества, а не слабостью модели. Сначала проверьте, какие уровни поддерживает ваша модель:
Одно и то же название уровня не означает один и тот же уровень в разных моделях: в серии 2.5 шкала была пересмотрена, поэтому
high в 2.5 примерно соответствует medium в gpt-image-2, и только max в 2.5 совпадает с high в gpt-image-2. Перенос quality без изменений при миграции с gpt-image-2 незаметно понижает уровень на одну ступень, что воспринимается как «новая модель хуже отображает текст». Числовые показатели для каждого уровня приведены в разделе Генерация и редактирование изображений GPT-Image-2.5 / 2.
Семейство Gemini (Nano Banana 2 / 2 Lite) не принимает параметр quality. То, что вы можете настроить здесь, — это разрешение и thinkingLevel: включайте thinkingLevel: "high", когда верстка текста внутри изображения или логика композиции действительно важны; это увеличивает стоимость примерно на 54% и задержку на 55%. gemini-3-pro-image не поддерживает эту настройку. Подробное описание механизмов приведено в разделе Описание полей использования и выходных данных.
Стратегия 4: Сначала изолируйте проблему с помощью тестового инструмента
Когда вы отлаживаете «почему вывод неверный», сначала изолируйте переменные. imagen.apiyi.com позволяет быстро проверить комбинацию «prompt + image» без написания кода:- Не работает и в инструменте → скорее всего, проблема в prompt/задаче; вернитесь к Стратегии 1 или переключите модели по Стратегии 3;
- Работает в инструменте, но не в вашем коде → проверьте код: полностью ли загружено изображение, корректны ли параметры, не обрезан ли prompt и не искажён ли он экранированием;
- То работает, то нет → это вариативность sampling; добавьте повторные попытки по Стратегии 2.
Краткая справка
- Веб-приложение ≠ API: веб-приложение — это полноценный агент с переписыванием prompt и многоэтапной оркестрацией; API — это одиночный атомарный вызов с вашим неизменным prompt. Ощутимая разница в основном обусловлена пайплайном, а не тем, что «API понимает меньше».
- Случайная вариативность одиночного вызова присуща генеративным моделям — единичный сбой ничего не говорит о модели или шлюзе.
- Стратегия 1, улучшите prompt: конкретные существительные, точные цвета, перечисление того, что нужно сохранить, нумерация действий — изменяйте за один раз только одну категорию элементов.
- Стратегия 2, повторите попытку: закладывайте 1–2 повторные попытки на случай «неверного редактирования»; «отсутствие изображения» — это другая проблема (см. руководство по обработке ошибок).
- Стратегия 3, смените модель: в данном случае
gemini-3-pro-image,gemini-3.1-flash-lite-imageи серияgpt-image-2сработали с первой попытки; на едином шлюзе для этого достаточно изменить один параметр. - Размытый мелкий текст: сначала повысьте уровень качества: как минимум
highдля изображений с текстом (xhigh/maxдля серии 2.5), и предварительно проверьте стоимость в tokens; для семейства Gemini используйте вместо этогоthinkingLevel: "high". - Стратегия 4, используйте инструмент тестирования для изоляции: сначала проверьте связку «prompt + изображение» на imagen.apiyi.com, чтобы разграничить проблемы с prompt, ошибки в коде и вариативность сэмплинга.