

간단한 답변
권장 설정: 토큰을 생성할 때는 대부분의 시나리오에 적합한 “사용량 우선” 과금 모드를 선택합니다.
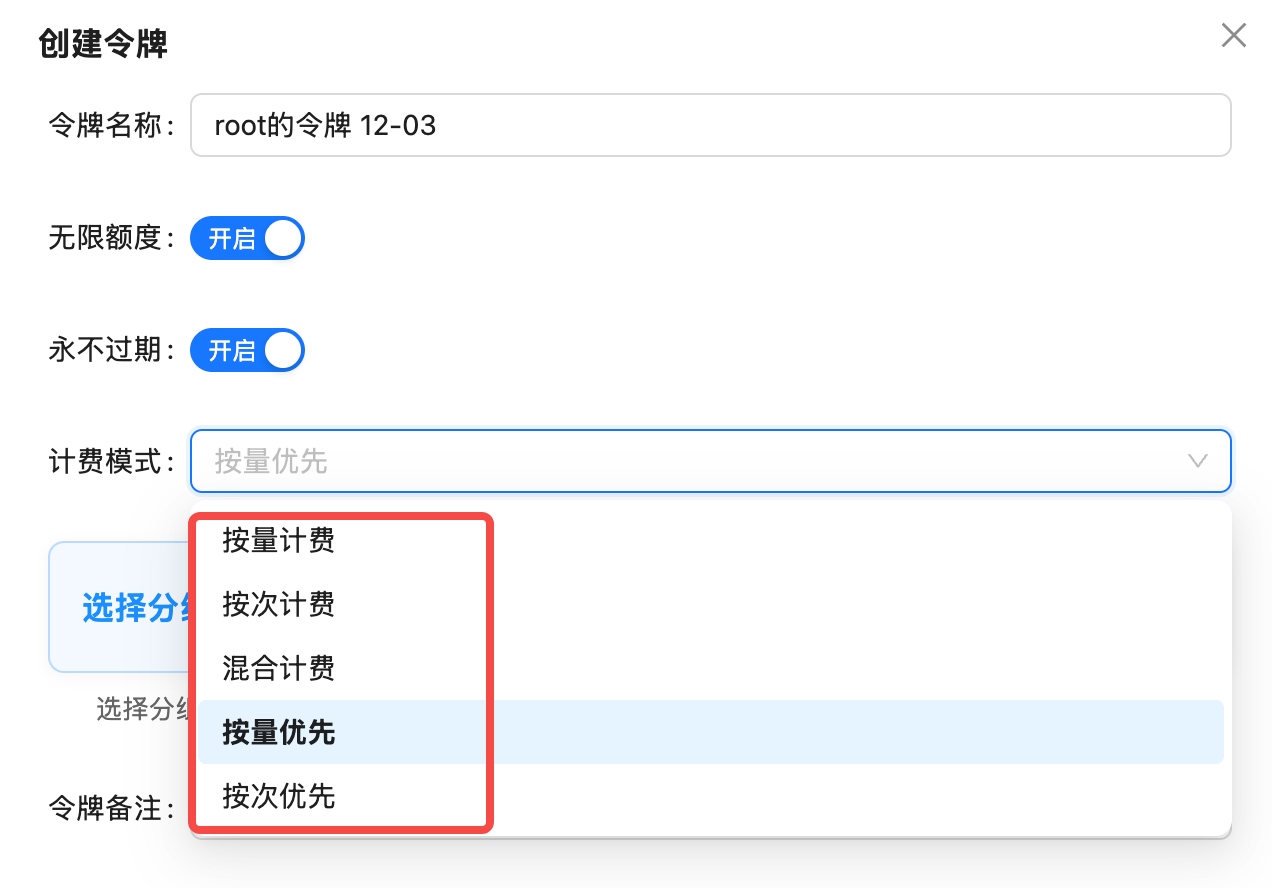
5가지 과금 모드 설명
1. 사용량 기반 과금(token 기반)
정의: 입력 및 출력 token 수에 따라 과금하며, 사용한 만큼 지불합니다. 적용 가능한 모델:- 텍스트 생성 모델: GPT-4, Claude, Gemini, DeepSeek 등
- 멀티모달 이해 모델: 이미지/오디오 입력을 지원하는 모델
- 특수 이미지 모델:
gpt-image-1(token 기준 과금)
gpt-4o: 입력 $5/백만 tokens, 출력 $15/백만 tokensclaude-3-5-sonnet-20241022: 입력 $3/백만 tokens, 출력 $15/백만 tokens
2. 호출당 과금
정의: 입력 및 출력 token 수와 관계없이 호출 1회당 고정 요금이 부과됩니다. 적용 가능한 모델:- 이미지 생성 모델: DALL-E, Flux, Sora Image 등(gpt-image-1 제외)
- 동영상 생성 모델: Sora Video, VEO 등
gemini-3-pro-image(별칭nano-banana-pro): 호출당 $0.09sora_video2: 호출당 $0.15(10초 동영상)flux-1.1-pro: 호출당 $0.04
호출당 과금의 장점:
- 투명한 요금으로 생성 1회당 비용이 고정됩니다
- token 사용량을 계산할 필요가 없습니다
- 이미지/동영상처럼 출력이 고정된 시나리오에 적합합니다
3. 하이브리드 과금
정의: 사용량 기반 과금과 호출당 과금을 모두 지원하며, 모델에 따라 자동으로 선택합니다. 상태: ⚠️ 해당 없음4. 사용량 기반 과금 우선(권장)
정의: 모델이 두 가지 과금 방식을 모두 지원하는 경우 사용량 기반 과금을 우선 적용하는 스마트 과금 모드입니다. 모델이 호출당 과금만 지원하면 해당 방식으로 자동 전환됩니다. 권장 이유- ✅ 호출당 과금 포함: 호출당 과금되는 이미지/동영상 모델을 호출할 수 있습니다
- ✅ 사용량 기반 과금 포함: 사용량 기준으로 과금되는 텍스트/멀티모달 모델을 호출할 수 있습니다
- ✅ 자동 적용: 시스템이 가장 적합한 과금 방식을 자동으로 선택합니다
- ✅ 모든 시나리오 지원: 400개 이상의 모든 모델을 지원합니다
권장 이유: “사용량 기반 과금 우선” token을 사용하면 과금 모드별로 token을 따로 만들지 않고도 모든 모델을 호출할 수 있습니다.
5. 호출당 과금 우선
정의: 모델이 두 가지 과금 방식을 모두 지원하는 경우 호출당 과금을 우선 적용합니다. 모델이 사용량 기반 과금만 지원하면 해당 방식으로 자동 전환됩니다. 적용 시나리오:- 고정 비용이 필요한 시나리오
- 주로 이미지/동영상 생성 모델을 사용하는 경우
사용 권장 사항: 명확한 비용 통제 요구 사항이 없다면 “사용량 기반 과금 우선”을 사용하세요. 텍스트 모델은 일반적으로 사용량 기반 과금이 더 비용 효율적입니다.
과금 모드를 선택하는 방법은?
권장 솔루션(사용자 95%에 적합)
사용량 기반 우선(기본 권장)
적용 시나리오:
- 텍스트, 이미지, 동영상 모델을 동시에 사용하는 경우
- 모델마다 서로 다른 token을 만들고 싶지 않은 경우
- 최대한의 유연성이 필요한 경우
- 400개 이상의 모든 모델을 지원합니다
- 시스템이 최적의 과금 방식을 자동으로 선택합니다
- 추가 설정이 필요하지 않습니다
특수 시나리오
- 순수 텍스트 애플리케이션
- 순수 이미지/동영상 애플리케이션
- 비용 제어
시나리오: GPT, Claude, Gemini 및 기타 텍스트 모델만 사용하는 경우권장 과금 모드: 사용량 기반 우선 또는 사용량 기반이유: 텍스트 모델은 모두 사용량 기반 과금을 사용하므로 두 모드의 효과가 같습니다
FAQ
gpt-image-1에는 왜 사용량별 token이 필요합니까?
gpt-image-1에는 왜 사용량별 token이 필요합니까?
gpt-image-1은 OpenAI의 공식 이미지 생성 모델입니다. 이미지를 생성하지만 과금 방식은 텍스트 모델과 비슷하며, token 기준으로 과금됩니다.과금 요소:- 이미지 해상도(1024x1024는 약 5000 token, 1792x1024는 약 8500 token을 사용합니다)
- 이미지 품질(HD 품질은 token 사용량을 늘립니다)
- “사용량별 우선” 또는 “사용량별” token을 사용합니다
- “호출당” token을 사용하면
gpt-image-1을 호출할 수 없습니다
이미 호출당 token을 만들었습니다. 사용량별 우선으로 변경할 수 있습니까?
이미 호출당 token을 만들었습니다. 사용량별 우선으로 변경할 수 있습니까?
예, 수정할 수 있습니다. 다음 단계를 따르세요.
- API.YI token 관리 페이지에 로그인합니다
- 해당 token을 찾아 오른쪽의 “수정” 버튼을 클릭합니다
- “과금 방식” 드롭다운 메뉴에서 “사용량별 우선”을 선택합니다
- 설정을 저장합니다
사용량별 우선과 호출당 우선의 차이는 무엇입니까?
사용량별 우선과 호출당 우선의 차이는 무엇입니까?
우선 적용 방식이 다릅니다:
권장 사항: 대부분의 경우 “사용량별 우선”을 사용하세요.
호출당 과금으로 경로나 이미지 품질을 알 수 있습니까?
호출당 과금으로 경로나 이미지 품질을 알 수 있습니까?
그것만으로는 알 수 없습니다. 사용량별 과금과 호출당 과금은 요금 계산 방식을 설명할 뿐입니다. 경로가 공식 포워드인지 공식 리버스인지는 나타내지 않으며, 이미지 품질 등급을 의미하지도 않습니다. 이용 가능한 과금 방식과 경로는 해당 모델 페이지와 token 그룹 세부 정보를 확인하세요.예를 들어 Nano Banana 2.1 가격 페이지에는 요청당 과금과 token 기반 과금이 모두 표시되어 있습니다. Nano Banana 연동 가이드에는 AIStudio 및 Vertex 채널을 모두 사용하는 방법이 설명되어 있습니다. 따라서 호출당 과금만으로 요청에 공식 리버스 경로가 사용되었거나 이미지 품질이 변경되었다고 판단할 수는 없습니다.모델, 경로 또는 생성 매개변수가 다르면 결과도 달라질 수 있습니다. 결과를 비교할 때는 모델 ID, token 그룹, 생성 매개변수를 확인하세요. 특정 요청을 조사하려면 해당 요청의
request_id을 제공하세요.잘못된 과금 방식을 선택하면 호출이 실패합니까?
잘못된 과금 방식을 선택하면 호출이 실패합니까?
즉시 실패하지는 않지만 일부 모델을 호출하지 못할 수 있습니다.예시 시나리오:
- token이 “호출당”이면
gpt-4o호출이 실패합니다(gpt-4o는 사용량별 과금만 지원하기 때문입니다) - token이 “사용량별”이면
gemini-3-pro-image호출이 실패할 수 있습니다(이 모델은 호출당 과금만 지원하기 때문입니다)
혼합 과금을 사용할 수 없는 이유는 무엇입니까?
혼합 과금을 사용할 수 없는 이유는 무엇입니까?
혼합 과금은 이론적으로 사용량별 과금과 호출당 과금을 모두 지원하지만, 실제로는 다음과 같은 문제가 발생할 수 있습니다.
- 과금 로직이 불명확합니다
- 비용 예측이 어렵습니다
- 시스템 호환성 문제가 발생합니다
요약 권장 사항
모범 사례: token을 생성할 때는 모든 사용 시나리오를 포괄하면서 모델별로 서로 다른 token을 만들 필요가 없도록 “사용량 기반 우선” 과금 모드를 선택하십시오.