

簡潔な回答
推奨設定: token を作成する際は、ほとんどのケースに適した 「従量課金優先」 の課金モードを選択してください。
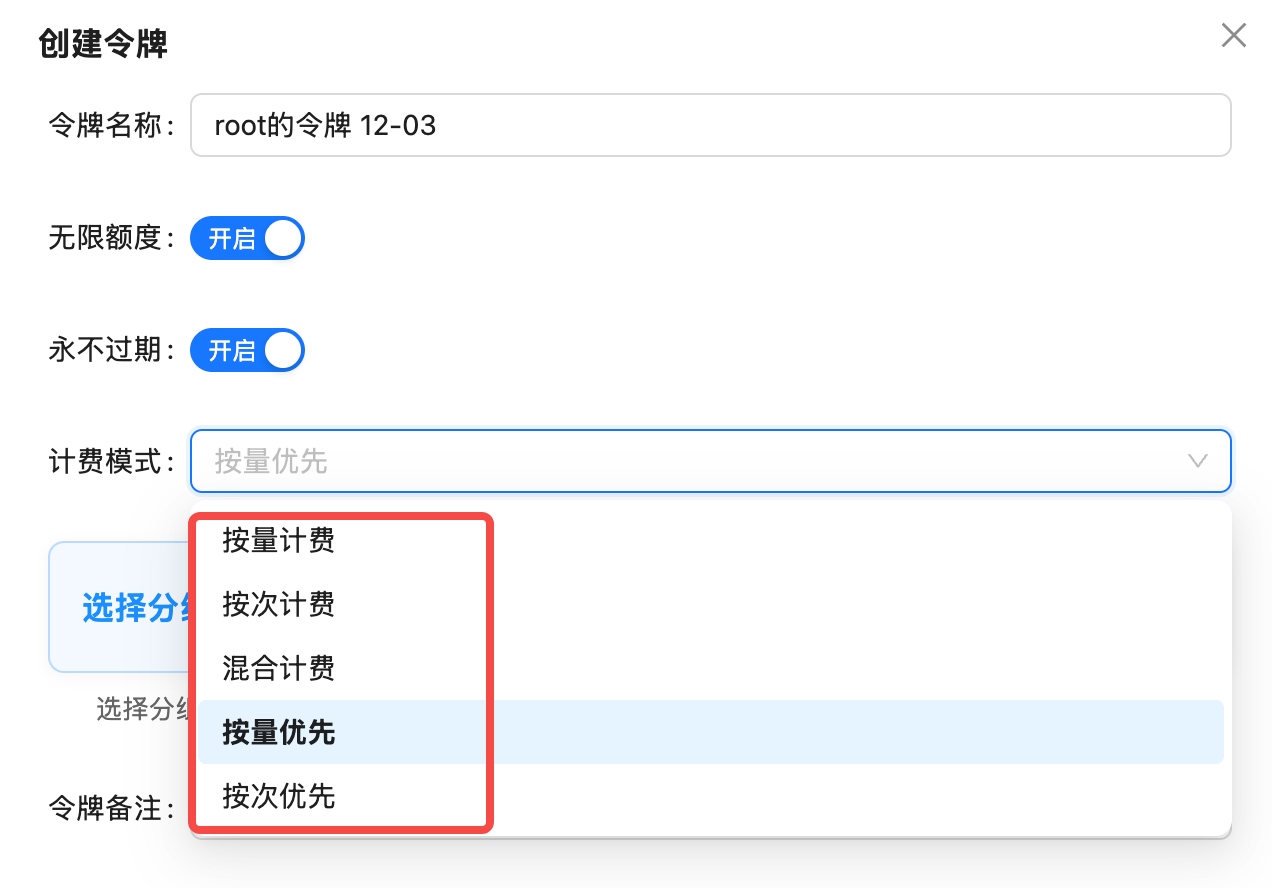
5 5つの課金方式の説明
1. 従量課金(Tokensベース)
定義: 入力と出力のTokens数に基づいて課金され、使用した分だけ支払います。 対象モデル:- テキスト生成モデル: GPT-4、Claude、Gemini、DeepSeekなど
- マルチモーダル理解モデル: 画像/音声入力に対応するモデル
- 特殊な画像モデル:
gpt-image-1(Tokensで課金)
gpt-4o: 入力 $5/100万tokens、出力 $15/100万tokensclaude-3-5-sonnet-20241022: 入力 $3/100万tokens、出力 $15/100万tokens
2. 呼び出しごとの課金
定義: 呼び出しごとに固定料金が発生し、入力と出力のTokens数による影響を受けません。 対象モデル:- 画像生成モデル: DALL-E、Flux、Sora Imageなど(gpt-image-1を除く)
- 動画生成モデル: Sora Video、VEOなど
gemini-3-pro-image(エイリアスnano-banana-pro): $0.09/呼び出しsora_video2: $0.15/呼び出し(10秒の動画)flux-1.1-pro: $0.04/呼び出し
呼び出しごとの課金のメリット:
- 料金体系が明確で、生成ごとの費用が固定されます
- Token消費量を計算する必要がありません
- 画像や動画など、出力が固定されたシナリオに適しています
3. ハイブリッド課金
定義: 従量課金と呼び出しごとの課金の両方に対応し、モデルに応じて自動的に選択されます。 ステータス: ⚠️ 対象外4. 従量課金優先(推奨)
定義: モデルが両方の方式に対応している場合は従量課金を優先する****スマート課金モードです。モデルが呼び出しごとの課金のみに対応している場合は、自動的にそちらへ切り替わります。 推奨する理由- ✅ 呼び出しごとの課金に対応: 呼び出しごとに課金される画像/動画モデルを呼び出せます
- ✅ 従量課金に対応: 使用量に応じて課金されるテキスト/マルチモーダルモデルを呼び出せます
- ✅ 自動適応: システムが最適な課金方式を自動的に選択します
- ✅ あらゆるシナリオをカバー: 400以上のすべてのモデルに対応しています
推奨する理由: 「従量課金優先」tokenを使用すると、課金方式ごとに異なるtokenを作成せずに、すべてのモデルを呼び出せます。
5. 呼び出しごとの課金優先
定義: モデルが両方の方式に対応している場合は呼び出しごとの課金を優先します。モデルが従量課金のみに対応している場合は、自動的に従量課金に切り替わります。 対象シナリオ:- 固定費が必要なシナリオ
- 主に画像/動画生成モデルを使用する場合
利用上のアドバイス: 明確なコスト管理要件がない限り、「従量課金優先」を使用してください。テキストモデルは通常、従量課金のほうがコスト効率に優れています。
課金モードの選び方は?
推奨解決策(95%のユーザーに適しています)
従量課金優先(デフォルト推奨)
適用シナリオ:
- テキスト、画像、動画モデルを同時に使用する
- モデルごとに異なる token を作成したくない
- 最大限の柔軟性が必要
- 400以上のすべてのモデルをカバー
- システムが自動的に最適な課金方法を選択
- 追加設定は不要
特殊なシナリオ
- 純テキストアプリケーション
- 純画像/動画アプリケーション
- コスト管理
シナリオ: GPT、Claude、Gemini などのテキストモデルのみを使用する推奨課金モード: 従量課金優先 または 従量課金理由: テキストモデルはいずれも従量課金制を使用するため、どちらのモードでも同じ効果です
よくある質問
gpt-image-1 にはなぜ従量課金Tokenが必要なのですか?
gpt-image-1 にはなぜ従量課金Tokenが必要なのですか?
gpt-image-1 は OpenAI の公式画像生成モデルです。画像を生成しますが、課金方式はテキストモデルと似ており、Token単位で課金されます。課金要因:- 画像の解像度(1024x1024 では約5000 tokens、1792x1024 では約8500 tokensを消費します)
- 画像の品質(HD品質ではTokenの消費量が増加します)
- 「従量課金優先」または「従量課金」のTokenを使用してください
- 「呼び出しごとの課金」のTokenを使用すると、
gpt-image-1を呼び出せません
すでに呼び出しごとの課金Tokenを作成しましたが、従量課金優先に変更できますか?
すでに呼び出しごとの課金Tokenを作成しましたが、従量課金優先に変更できますか?
変更できます。手順は次のとおりです。
- API.YI Token管理ページにログインします
- 該当するTokenを見つけ、右側の「編集」ボタンをクリックします
- 「課金モード」ドロップダウンメニューで「従量課金優先」を選択します
- 設定を保存します
従量課金優先と呼び出しごとの課金優先にはどのような違いがありますか?
従量課金優先と呼び出しごとの課金優先にはどのような違いがありますか?
優先される課金方式が異なります。
推奨: ほとんどの場合、「従量課金優先」を使用してください。
呼び出しごとの課金から、ルートや画像品質が分かりますか?
呼び出しごとの課金から、ルートや画像品質が分かりますか?
それだけでは分かりません。 従量課金と呼び出しごとの課金は料金の計算方法を示すものであり、ルートが公式フォワードか公式リバースかを示すものでも、画像品質の段階を表すものでもありません。利用可能な課金モードとルートについては、該当するモデルページとTokenグループの詳細を確認してください。たとえば、Nano Banana 2.1 の料金ページには、リクエストごとの課金とTokenベースの課金の両方が記載されています。Nano Banana の連携ガイドでは、AIStudio チャネルと Vertex チャネルの両方について説明しています。そのため、呼び出しごとの課金だけでは、リクエストが公式リバースルートを使用していることや、画像品質が変化したことの根拠にはなりません。モデル、ルート、生成パラメータが異なると、結果も異なる場合があります。出力を比較する際は、モデルID、Tokenグループ、生成パラメータを確認してください。特定のリクエストを調査する場合は、
request_idをご提供ください。課金モードを間違えて選択すると、呼び出しに失敗しますか?
課金モードを間違えて選択すると、呼び出しに失敗しますか?
すぐに失敗するわけではありませんが、一部のモデルを呼び出せない場合があります。例:
- Tokenが「呼び出しごとの課金」の場合、
gpt-4oの呼び出しは失敗します(gpt-4o は従量課金のみに対応しているためです) - Tokenが「従量課金」の場合、
gemini-3-pro-imageの呼び出しは失敗する場合があります(このモデルは呼び出しごとの課金のみに対応しているためです)
混合課金が適用されないのはなぜですか?
混合課金が適用されないのはなぜですか?
混合課金は理論上、従量課金と呼び出しごとの課金の両方に対応しますが、実際には次の問題が発生する場合があります。
- 課金ロジックが不明確になる
- コストの予測が難しくなる
- システムの互換性に問題が生じる
概要と推奨事項
ベストプラクティス: token を作成する際は、すべての利用シナリオをカバーするために「従量課金優先」課金モードを選択し、モデルごとに異なる token を作成しないようにしてください。